MySQL 排序原理详解与分页重复等异常案例排查
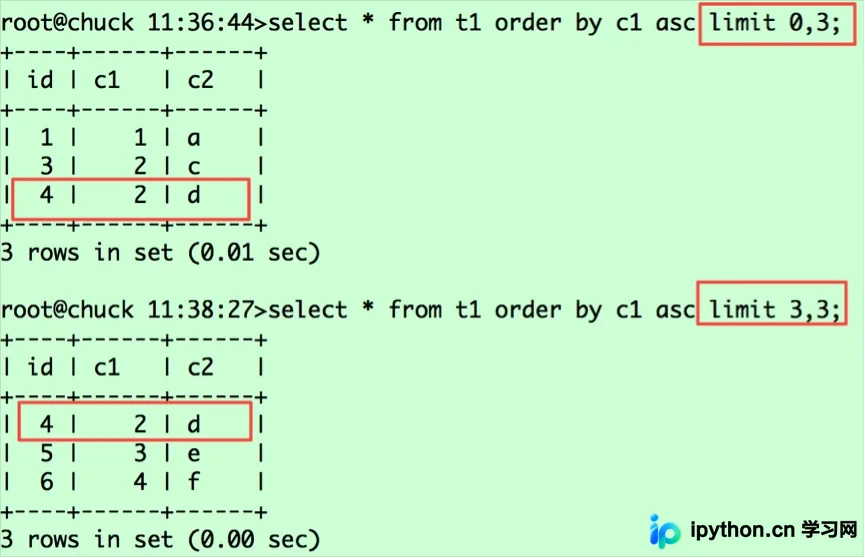
本文深入解析 MySQL 的排序机制,探讨如何利用有序索引避免昂贵的 Filesort。详细对比常规排序、优化排序与优先队列排序(堆排序)的执行流程与资源消耗。针对 MySQL 5.6+ 版本常见的分页数据重复问题,分析非稳定排序导致的根因并提供解决方案,同时通过实际案例说明因元组长度差异引发的排序结果不一致现象及自定义字段排序技巧。
2026-10-13
0



本文深入解析 MySQL 的排序机制,探讨如何利用有序索引避免昂贵的 Filesort。详细对比常规排序、优化排序与优先队列排序(堆排序)的执行流程与资源消耗。针对 MySQL 5.6+ 版本常见的分页数据重复问题,分析非稳定排序导致的根因并提供解决方案,同时通过实际案例说明因元组长度差异引发的排序结果不一致现象及自定义字段排序技巧。
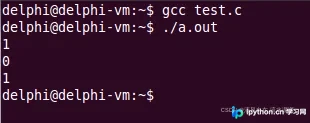
本文深入解析C语言中有符号数与无符号数的底层表示原理。详细介绍最高位符号位的判定逻辑,区分正负数在计算机内部的补码与原码存储差异。通过代码实例揭示当signed与unsigned混合运算时,系统自动将操作数转换为unsigned带来的结果反转现象,并分析因数据类型特性导致的死循环常见错误。掌握这些底层机制有助于编写更健壮的C语言程序。
MySQL在特定SQL操作下会创建内部临时表以辅助计算。本文通过具体示例分析两种常见场景:UNION进行结果集去重时,内存临时表存储中间结果并约束主键实现去重;GROUP BY分组聚合时,临时表暂存分组键与计数值,完成后需Filesort排序。当数据量超过tmp_table_size(默认16MB)限制时,临时表将转化为磁盘InnoDB表,影响性能。理解其执行流程有助于优化查询语句。
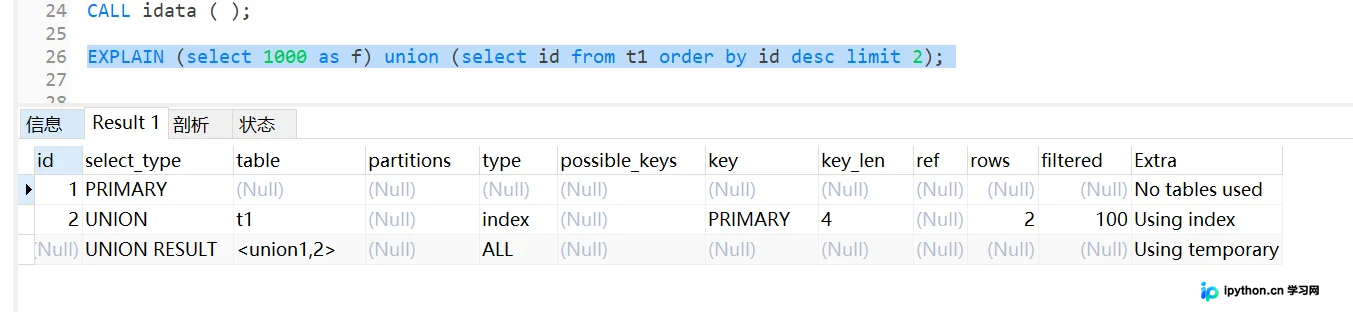
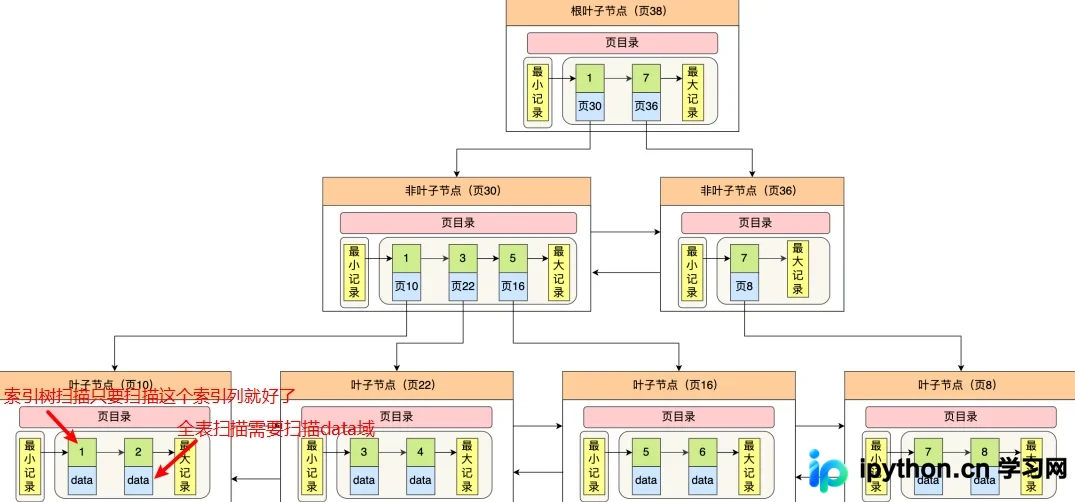
在MySQL中,EXPLAIN输出的type字段为ALL时代表全表扫描,为index时代表索引树扫描。两者底层均遍历聚簇索引B+树,但核心区别在于:索引树扫描若仅查询主键或覆盖列,可通过Using index优化避免回表;而全表扫描涉及非索引列时需读取完整行数据。本文通过实例对比两种场景的开销差异。
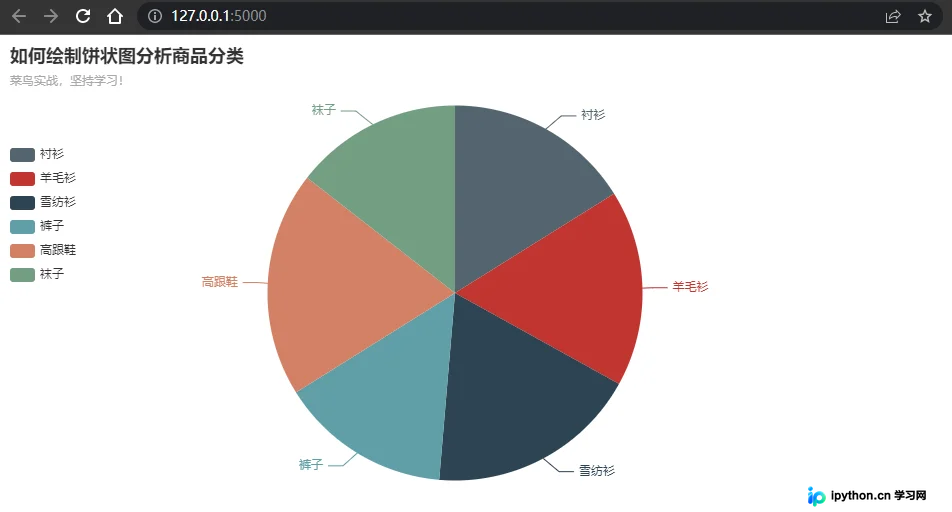
本文介绍如何利用Python的pyecharts库结合Flask框架,通过实例代码演示如何构建商品分类数据并绘制交互式饼状图。详细解析了pie()函数的关键参数,包括autopct格式控制、colors颜色设置及explode偏移量,帮助开发者快速掌握数据可视化基础。
本文详细解析Python中单向链表的实现原理与代码编写。通过定义Node节点类存储数据与指针,以及Linklist链表类管理节点容器,实现了判断空链表、获取长度、遍历、头部/尾部/指定位置添加、删除及查找节点等核心功能。包含完整的代码实现与测试运行示例,帮助开发者深入理解链表数据结构及其在Python中的具体应用。
本文详细介绍 Golang pprof 工具中 memory (heap/allocs)、block 和 mutex 的性能指标采集方法。涵盖通过 HTTP 接口暴露数据及使用代码生成 profile 文件两种方式,解析输出参数的含义及采样开关设置,帮助开发者定位内存分配、通道阻塞与锁竞争问题。
本文深入解析 MySQL EXPLAIN 命令的核心字段。通过 type 字段(从全表扫描到 const)判断访问效率,利用 key 识别实际使用的索引,并结合 extra 中的 Using index、Using filesort 等状态码定位慢查询根因。掌握这些指标可精准调整 SQL 语句,提升数据库执行效率。
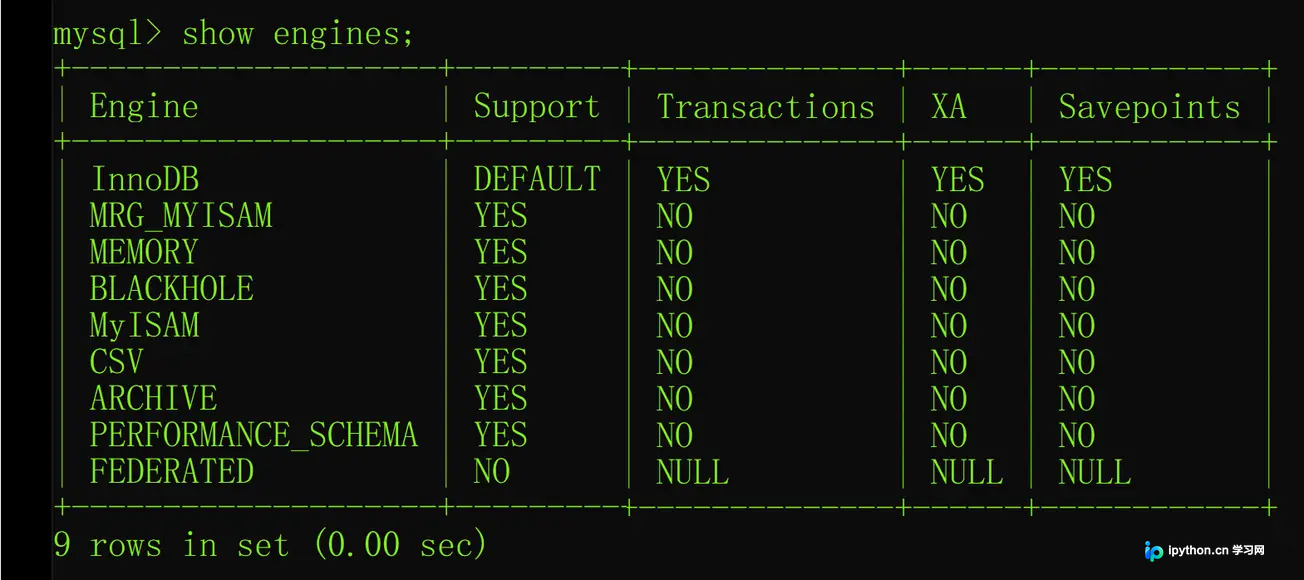
本文对比 MySQL 三大常用存储引擎:InnoDB、MyISAM 和 MEMORY。从事务支持、锁机制、读写效率及适用场景进行详细分析,并提供使用 SQL 命令查看及修改表级存储引擎的具体操作指南。
本文详细解析Python中numpy数组截取指定行列的方法。通过对比错误用法[[wp:a3]]与正确两步法[[wp:a5]],指出直接索引可能导致非预期结果,并演示如何先取行再取列以准确获取目标子矩阵,帮助开发者避免常见索引陷阱。
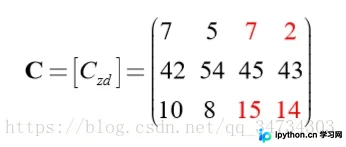
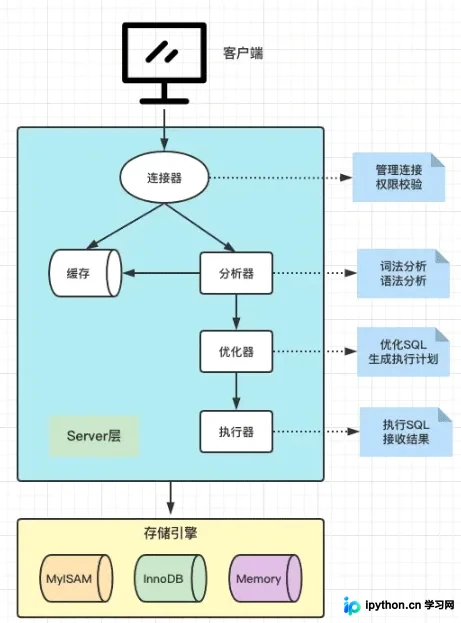
深入解析 MySQL 分层架构设计,揭示 Server 层(连接器、查询缓存、分析器、优化器、执行器)与存储引擎层的交互原理。了解 SQL 语句在每一层的具体处理逻辑,明确连接管理、语法校验、执行计划生成及最终数据返回的完整链路,帮助开发者跳出碎片化优化,建立系统性的底层认知。
针对Go服务灰度期间因大量使用json.Marshal和Un进行对象拷贝导致的内存溢出(OOM)问题,文章详细记录了通过调整GOGC参数及利用gops结合pprof工具定位CPU和内存热点的分析过程。基于火焰图分析结果,指出大型结构体JSON序列化的性能瓶颈,并提供了使用Gob库实现高效深拷贝的替代代码方案,帮助开发者规避此类线上故障。