


MySQL全表扫描与索引树扫描(index)的区别解析

MySQL性能分析中,EXPLAIN的type字段是判断查询效率的关键。本文将深入解析全表扫描(type=ALL)与索引树扫描(type=index)的本质区别。尽管二者底层都基于聚簇索引树进行遍历,但在数据读取范围、是否发生回表以及执行计划表现上存在显著差异,直接影响数据库I/O开销。
扫描类型概览
在使用 EXPLAIN 分析SQL执行计划时,type 字段反映了MySQL访问数据的方式。从高效到低效,常见类型包括:
system/const:常量级查找,速度最快。eq_ref/ref:利用唯一或非唯一索引进行等值匹配。range:索引范围内的查询,如BETWEEN或>。index:**索引树扫描**,遍历整个索引结构。ALL:**全表扫描**,物理读取每一行数据。
其中,index 和 ALL 常被混淆,因为它们通常都涉及对聚簇索引(Clustered Index)的遍历。理解它们的细微差别对于优化慢查询至关重要。
核心机制:聚簇索引与数据页
InnoDB引擎的表数据存储在B+树的叶子节点中,这被称为聚簇索引。叶子节点不仅包含索引键(Key),还存储了整行数据(Data)。
无论走哪种扫描方式,只要没有合适的辅助索引可用,MySQL最终往往都要依赖聚簇索引来定位或读取数据。区别在于:只读索引键还是需要读取完整行记录。
实例对比分析
为了直观展示差异,我们创建一个测试表,其中仅包含一个主键和一个普通文本字段:
CREATE TABLE t_article (
    t_article_id INT PRIMARY KEY AUTO_INCREMENT,
    t_title VARCHAR(40)
);
第1步:执行索引树扫描
操作目的:仅查询主键字段,观察覆盖索引的效果。
SQL语句:
EXPLAIN SELECT t_article_id FROM t_article;执行结果特征:
| field | value |
|---|---|
| type | index |
| key | PRIMARY |
| Extra | Using index |
分析:
由于 SELECT 的目标字段正是主键(即聚簇索引本身),MySQL无需访问非索引列的数据,直接遍历B+树叶子节点即可获取结果。这种优化称为“覆盖索引”(Covering Index)。虽然它遍历了整个索引树,但因为不产生额外IO读取行数据,性能优于全表扫描。
第2步:执行全表扫描
操作目的:查询非索引字段,观察需读取完整行的情况。
SQL语句:
EXPLAIN SELECT t_title FROM t_article;执行结果特征:
| field | value |
|---|---|
| type | ALL |
| key | NULL |
| Extra | NULL |
分析:
当查询字段不是索引的一部分时,仅仅读取B+树节点中的Key(主键)是不够的,必须进一步读取该节点对应的Data区域(即完整的行记录,包含 t_title)。因此,执行计划标记为 ALL(全表扫描),意味着需要物理读取表中每一行的完整内容。
可视化区别
可以通过下图理解数据页层面的读取差异:
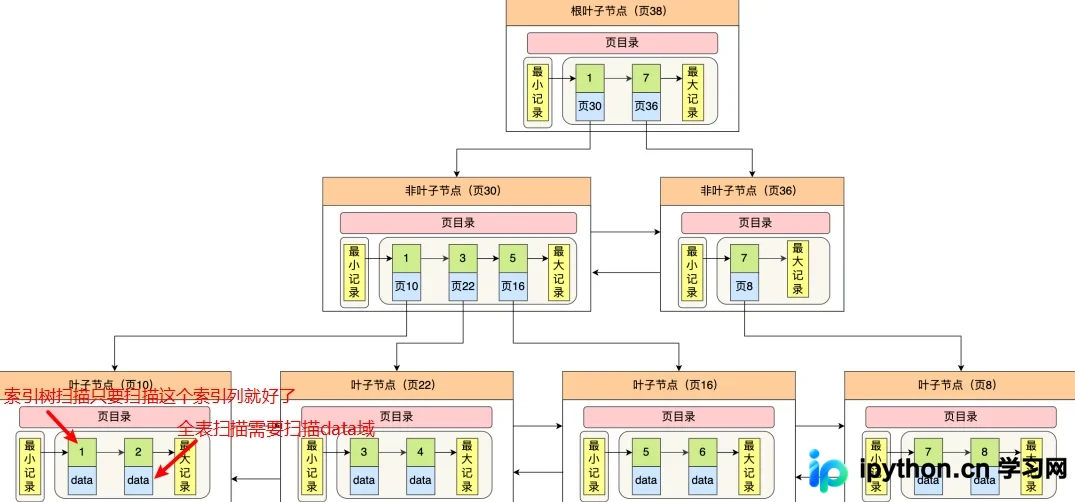
如图所示,左侧为索引树扫描,箭头指向叶子节点的 Key 区域即可满足需求;右侧为全表扫描,不仅需要定位到对应的Key,还需要深入读取 Data 区域以提取非索引列的信息。这就是为什么 index 类型在执行效率上通常优于 ALL 的原因。
总结与优化建议
综上所述:
- index(索引树扫描):遍历所有索引记录。如果查询的是覆盖索引列(如主键),则无需读取行数据,效率高。
- ALL(全表扫描):通常需要读取数据文件中的所有行。除非表极小,否则应尽量避免。
优化方向:在实际开发中,尽量使用覆盖索引(Select所需列均在索引树上),使执行计划的 Extra 列出现 Using index,从而将潜在的全表扫描转化为高效的索引树扫描。
以上就是MySQL中全表扫描和索引树扫描区别的详细内容,更多关于MySQL性能优化和执行计划分析的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















