Python DataFrame数据合并:merge()与concat()实战详解
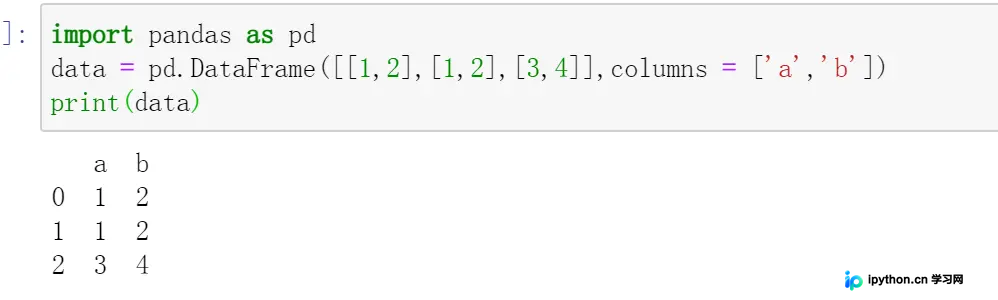
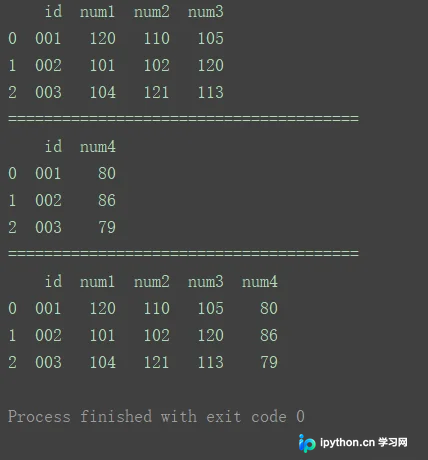
本文详细解析Python中Pandas库的数据合并方法。重点讲解merge()函数的inner、outer、left、right四种连接方式及多对一、多对多场景,并对比concat()在纵向堆叠与横向对齐时的参数配置,通过代码示例展示索引、键值处理及keys标记技巧。
2026-10-16
0



本文详细解析Python中Pandas库的数据合并方法。重点讲解merge()函数的inner、outer、left、right四种连接方式及多对一、多对多场景,并对比concat()在纵向堆叠与横向对齐时的参数配置,通过代码示例展示索引、键值处理及keys标记技巧。
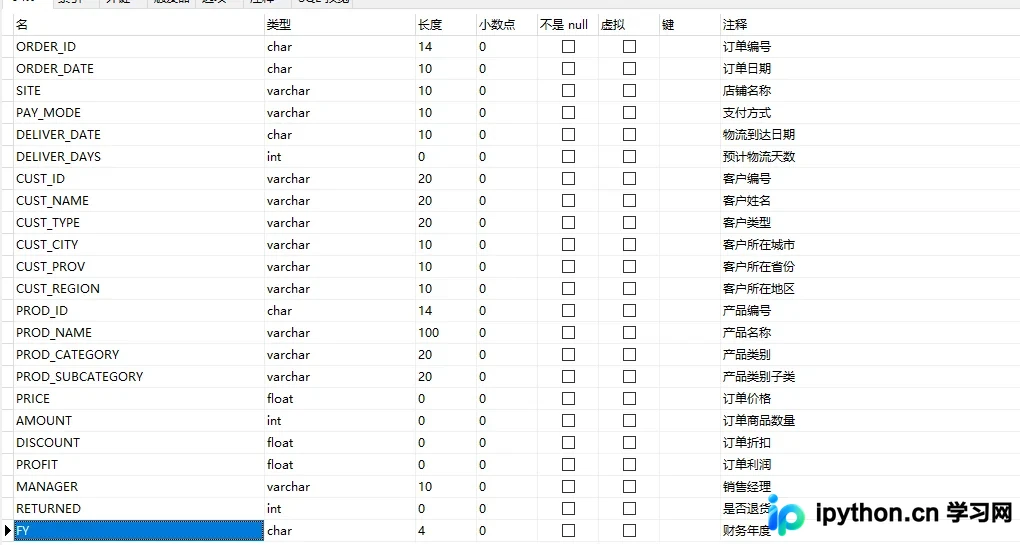
本文详细介绍如何使用Python的pymysql库连接数据库,提取订单数据,并利用matplotlib库绘制柱状图。内容涵盖从环境配置、SQL查询、全局参数设置到最终图表生成的完整代码示例,帮助开发者快速实现数据可视化。
本文介绍Python深度学习框架TensorFlow的基础知识,涵盖张量数据结构、常量与变量定义、占位符用法及计算图原理。通过具体代码示例演示如何创建Session、执行初始化及进行矩阵运算,帮助初学者快速掌握TensorFlow核心操作。
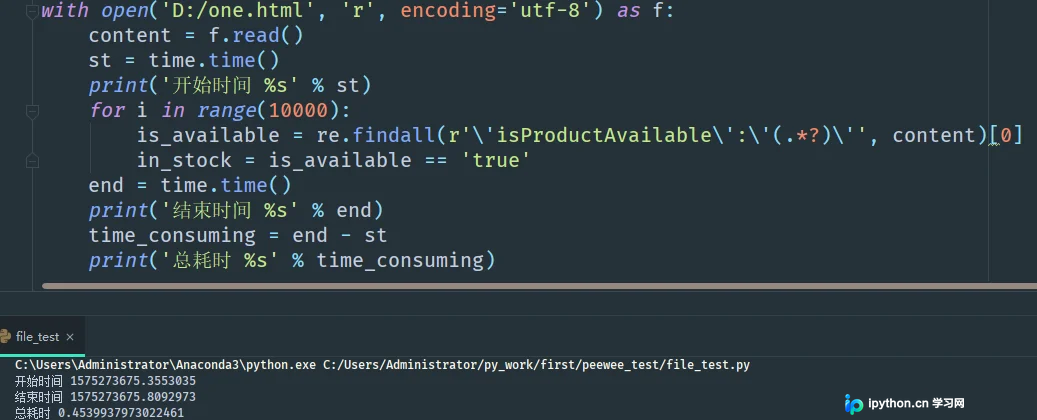
本文探讨 Python 中 re.compile 的必要性。作者通过实际案例指出,在数据量较小(如上万条)的场景下,直接使用 re.findall 或 re.search 的性能损耗可忽略不计,过度优化反而增加代码复杂度。只有面对百万级以上数据时,预编译正则对象才具有显著性能优势。文章强调应根据业务量级合理选择策略,而非盲目追求代码规范。
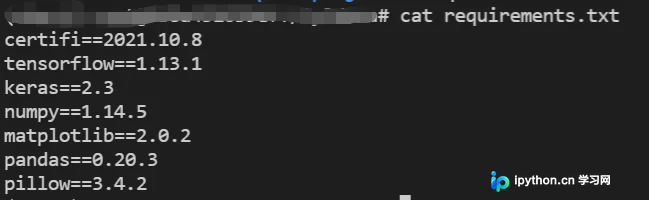
本文详细介绍Python项目中requirements.txt文件的作用及使用方法。通过pip freeze命令可自动生成包含依赖包及精确版本号的配置文件,利用pip install -r requirements.txt可快速在新环境中还原一致的开发环境,有效解决项目交付时的依赖冲突问题。
本文介绍如何使用Python的matplotlib库实现循环绘制多张图表。通过示例代码展示如何遍历数据生成多条Gamma分布曲线,并演示如何为循环生成的图表添加图例说明,解决批量可视化时的展示问题。
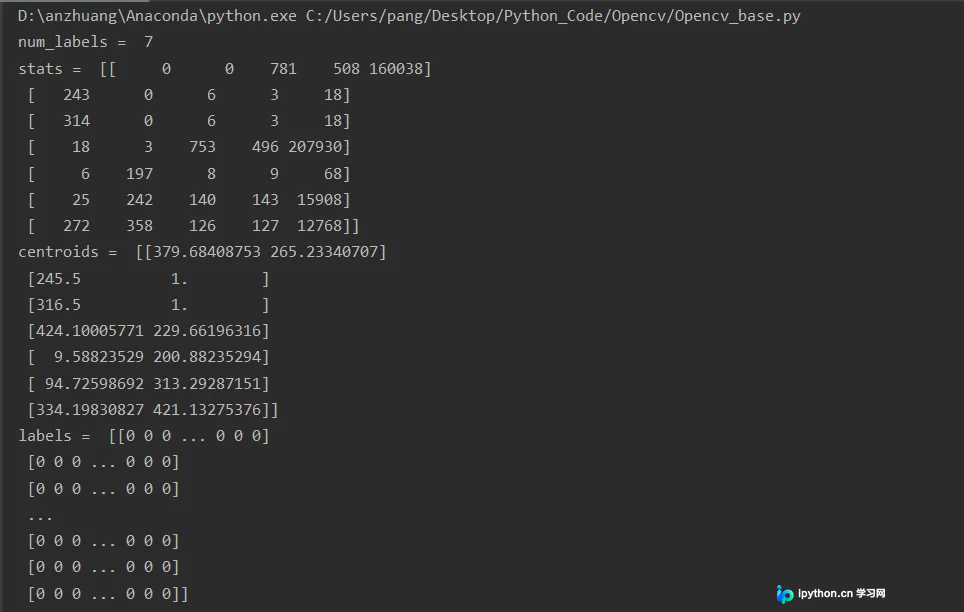
本文详细介绍OpenCV中用于连通域处理的两个核心函数:connectedComponents()与connectedComponentsWithStats()。通过对比两者在参数设置、返回值结构及信息丰富度上的差异,结合Python代码实例,演示如何从二值图像中提取连通域、获取边界框、面积及中心点等关键统计信息,并探讨预处理对检测结果的影响。
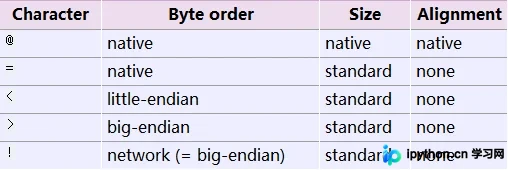
本文介绍Python中struct模块如何模拟C语言结构体。通过pack()将数据打包为字节字符串,利用unpack()还原为元组。重点解析fmt格式字符串,包括字节序、对齐方式及类型字符,并结合hhl格式示例演示具体转换过程与结果。
本文深入解析Python中Numpy库在数据分析中的核心应用,重点讲解如何利用cov和corrcoef函数计算股票收益率的协方差与相关系数,以评估资产间关联度。同时,通过polyfit和polyval实现多项式拟合与趋势预测,结合polyder求解极值,为量化交易和趋势分析提供完整的数学工具链与代码示例。
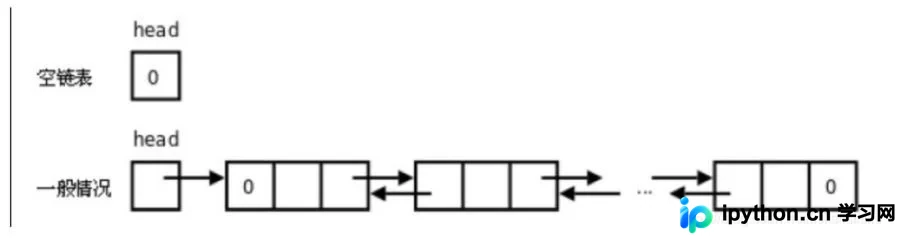
本文详细介绍Python中双向链表的实现原理,涵盖节点结构、核心操作方法如增删改查及遍历,并提供完整的Python代码示例与测试用例,帮助开发者深入理解双向链表的数据结构与编程实现。
本文详解Python中控制小数精度的两种主要方法。首先解析内置round()函数采用的ROUND_HALF_EVEN(四舍六入五成双)策略及其与常规四舍五入的区别。其次,针对超过17位小数的高精度需求,介绍使用decimal模块配合getcontext()设置更高精度的方案,并对比格式化输出的局限性。最后梳理round、ceil和floor等取整函数的具体行为。
本文详细介绍在Python数据分析中处理重复值的常用方法。通过Pandas库的duplicated()函数识别重复数据,利用sum()统计重复行数,并使用drop_duplicates()函数高效删除重复行。文章包含具体代码示例与常见错误排查,帮助开发者快速掌握数据清洗技巧。