


Python 正则 re.compile 真的必需吗

本文探讨 Python 中 re.compile 的必要性。作者通过实际案例指出,在数据量较小(如上万条)的场景下,直接使用 re.findall 或 re.search 的性能损耗可忽略不计,过度优化反而增加代码复杂度。只有面对百万级以上数据时,预编译正则对象才具有显著性能优势。文章强调应根据业务量级合理选择策略,而非盲目追求代码规范。
在处理爬虫文本数据时,我直接使用了 re.findall() 而未预先编译正则表达式。新加坡的同事对此提出质疑,认为以我的技术水平,写出这种可能影响性能的代码是不应该的,并要求我进行优化。我当时的反驳观点是:既然选择了 Python 作为开发语言,就不应过分纠结于极致的性能问题;若对性能有极高要求,理应选用 C 语言而非 Python。同事则回应:正因为 Python 性能相对较弱,才更需要在代码层面进行优化,力求做到最好。最终我未再回应,也未执行所谓的优化操作。下文将阐述我的具体观点。
re.compile()、re.findall() 与 re.search() 的作用及区别解析
1、re.compile() 详解
Python 的 re 模块用于支持正则表达式,即匹配文本中符合特定条件的内容。re.compile() 的作用是将包含正则表达式的字符串编译为模式对象,旨在提升后续匹配的效率。具体示例如下:
def test():
    regex = r'(\d+) years old'
    content = 'Alex is a 7 years old boy.'
    reg = re.compile(regex)
    result = re.search(reg, content).group()
    print(result)
result = 7
2、re.search() 详解
re.search() 用于在字符串中执行查找操作,其功能正如名称所示:search(搜索)。具体示例如下:
def test():
    content = 'Alex is a 7 years old boy.'
    result = re.search(r'(\d+) years old', content).group()
    print(result)
result = 7
3、re.findall() 详解
re.findall() 的功能是返回一个列表,其中包含所有匹配符合条件的结果。具体示例如下:
def test():
    content = 'Alex is a 7 years old boy.Bob is a 12 years old boy...'
    result = re.findall(r'(\d+) years old', content)
    print(result)
result = ['7', '12']
我们的分歧点在于,同事认为我应该先使用 re.compile 编译正则表达式,再进行匹配操作,正如我在 re.compile 示例中所展示的那样。你可能会认为他说得有理,作者不应顺从同事看似合理的要求,不改也就算了,何必发文讨论。但我认为,抛开数据量级谈性能差异是一种误导。如果处理的文本数据达到百万、千万甚至亿级别,我肯定会进行优化;但对于仅上万条的数据,我认为没有必要。业务流程中缺失那 0.0X 秒的时间通常是可以接受的,而编写额外一行 re.compile 代码所花费的时间,远大于节省下来的执行时间。虽然代码优化至关重要,特别是在处理大量数据时,但我们需要明确:仅靠几行 re.compile 并不能带来巨大的性能提升,精简流程和合理的设计模式才是核心。工作中应与同事保持良好沟通,避免像我一样因沟通不畅而产生误解,否则终将影响团队协作。
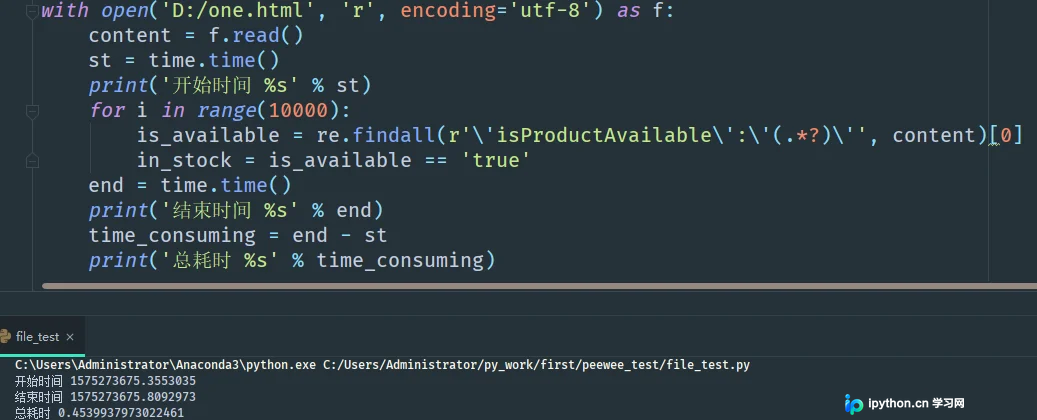
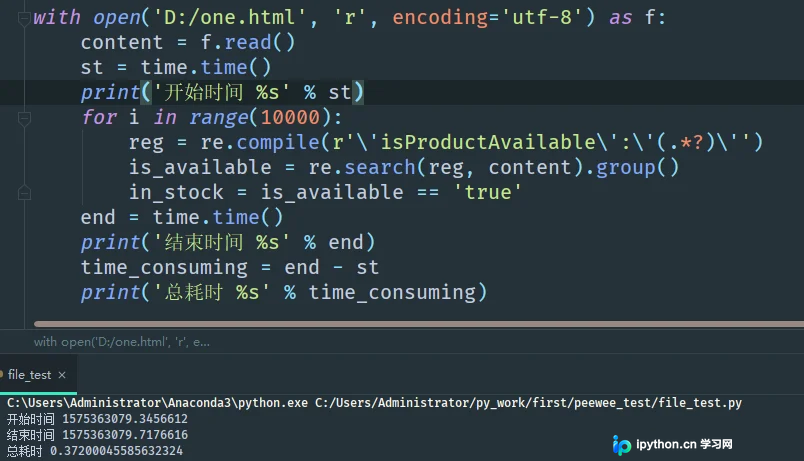
根据评论提示,若将 re.compile() 那一行代码置于迭代循环之外,相比示例中的时间速度会有所提升。但我们的业务逻辑与示例一致,即正则编译并未放在迭代外部执行。
至此,关于 Python 正则表达式中 re.compile 是否必需的讨论结束。如需了解更多相关 Python 正则表达式内容,请查阅本站往期文章或继续浏览后续相关文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















