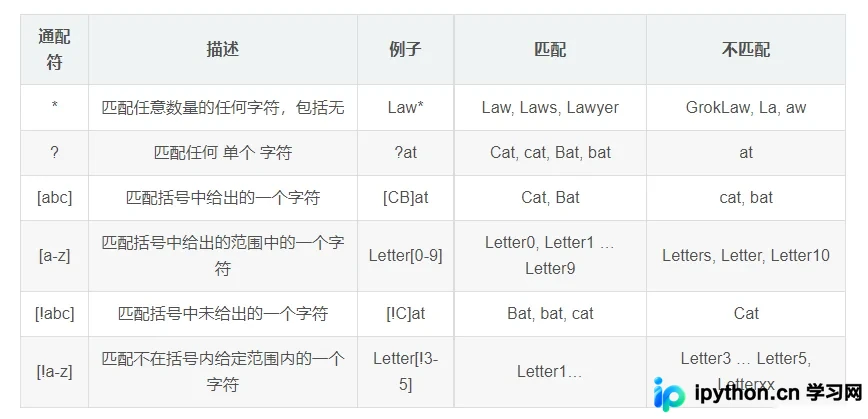
Python获取文件夹下所有文件的三种常用方法:os.listdir、glob与os.walk
本文详细介绍在Python中获取文件夹下所有文件的三种常用方法:os.listdir、glob模块以及os.walk。通过对比各方法的返回值特性、内存占用及递归能力,帮助开发者根据实际需求选择最优方案,适用于神经网络训练集读取等场景。
10-16
3




本文详细介绍在Python中获取文件夹下所有文件的三种常用方法:os.listdir、glob模块以及os.walk。通过对比各方法的返回值特性、内存占用及递归能力,帮助开发者根据实际需求选择最优方案,适用于神经网络训练集读取等场景。
本文提供基于TensorFlow 1.14的TextRNN简单实现示例,重点展示如何构建模型以预测序列中的下一个单词。文章包含完整的代码逻辑、参数设置及训练结果输出,适合希望快速理解RNN在文本序列预测中应用的开发者参考。
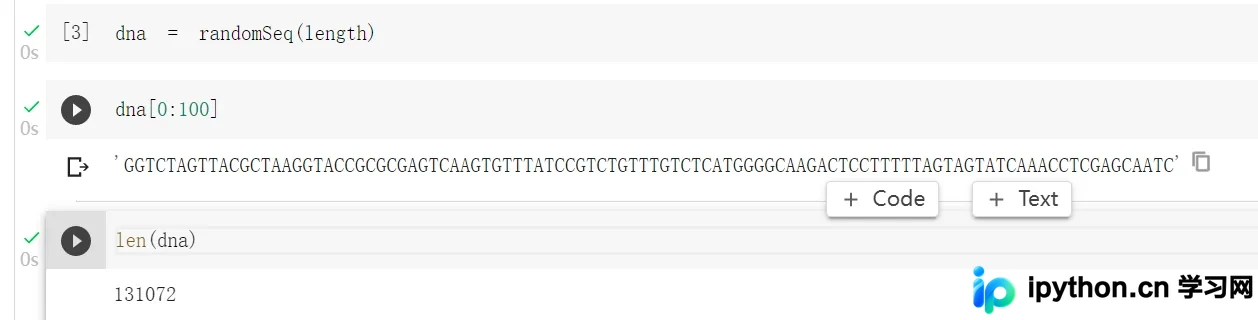
本文介绍使用Python将DNA碱基序列转换为One-Hot编码矩阵,并存储为TensorFlow专用的TFRecord格式文件的全过程。内容涵盖随机序列生成、自定义编码函数实现、字节流转换、Example构建以及数据读取与解析方法,适用于生物信息学深度学习模型训练前的数据预处理环节。
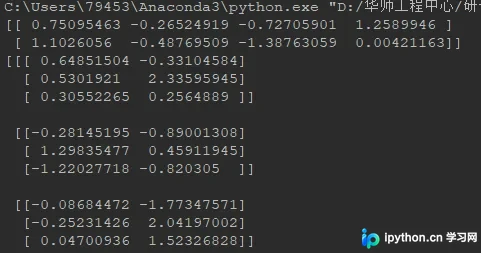
本文深入解析Python numpy库中np.random.seed()函数的核心机制与使用场景。通过对比实验,验证随机数种子对后续随机数生成的持续性影响,并探讨不同参数值如何确定随机序列的起始位置。文章指出种子参数仅作用于其定义后的下一次随机数生成,帮助开发者在机器学习和深度学习实验中实现结果的可复现性。
本文介绍Python深度学习框架TensorFlow的基础知识,涵盖张量数据结构、常量与变量定义、占位符用法及计算图原理。通过具体代码示例演示如何创建Session、执行初始化及进行矩阵运算,帮助初学者快速掌握TensorFlow核心操作。
本文介绍如何利用谷歌在ImageNet上训练的Inception-v3预训练模型进行图像分类。通过下载模型文件,编写Python代码加载图定义并读取图片,程序可将softmax概率映射为具体标签,输出识别结果及置信度分数,实现高效的图像识别功能。
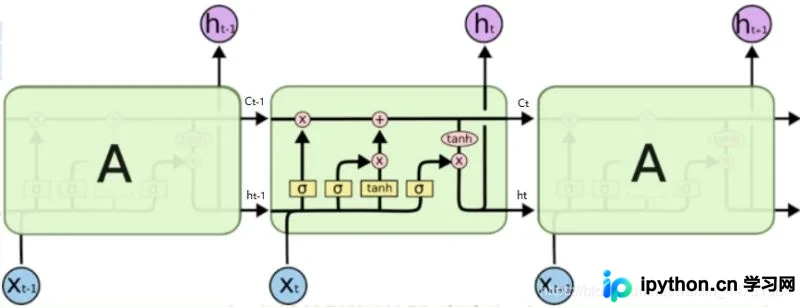
本文深入解析LSTM网络结构,详细讲解遗忘门、输入门和输出门的工作原理。重点阐述如何在Keras中通过units和input_shape参数配置LSTM,并逐步推导各门控机制的参数量计算公式。结合MNIST数据集示例代码,展示LSTM在序列数据处理中的实际应用与效果。
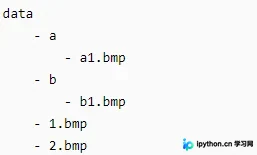
本文详解Python中遍历读取目录的两种常用方法:os.listdir与os.walk。os.listdir仅获取当前层级文件列表,而os.walk可递归遍历所有子目录。文章通过具体代码示例对比两者返回值差异,并提供了支持多后缀过滤、递归/非递归选项的完整封装函数,帮助开发者高效处理机器学习或深度学习中的文件读取需求。
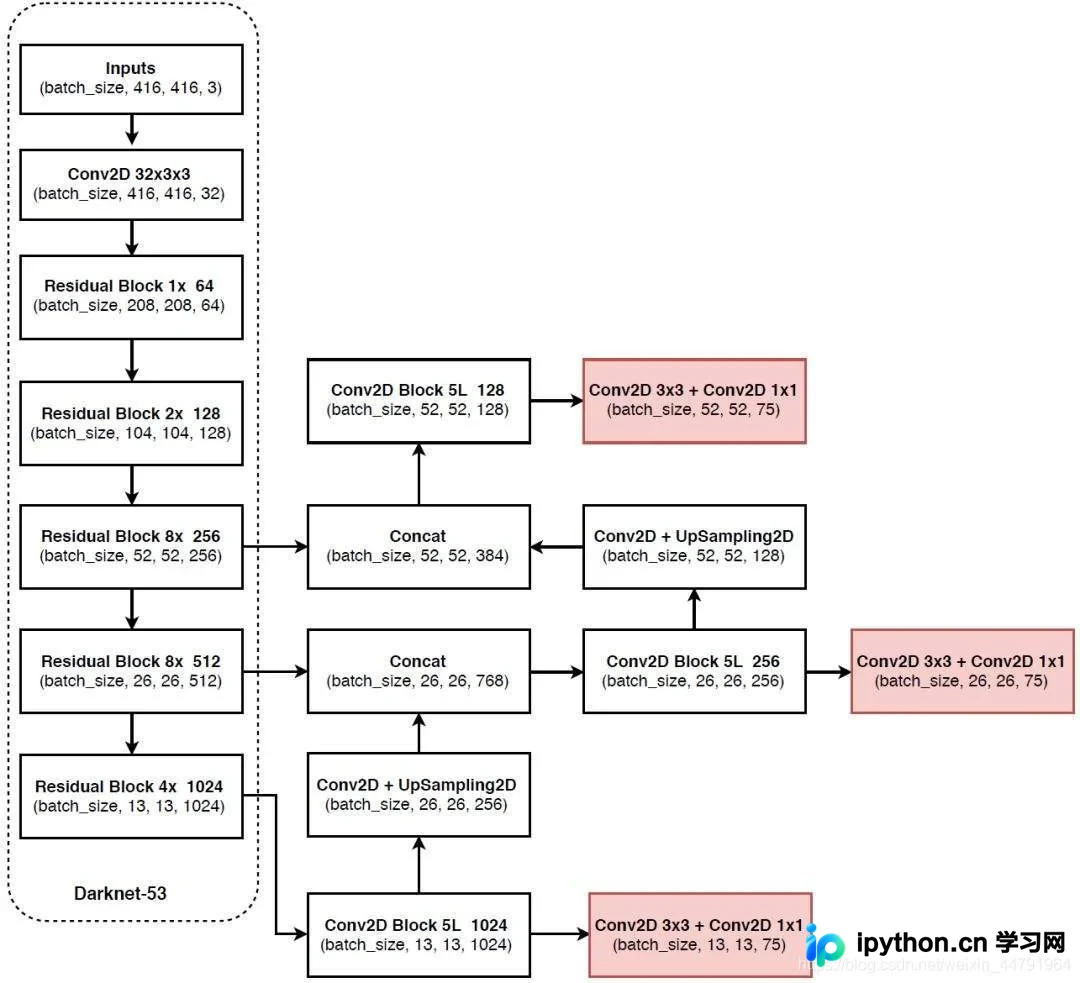
本文详细解析YOLO3目标检测模型的预测流程,涵盖Darknet53特征提取、多尺度特征层解码及非极大抑制筛选。通过Python代码复现,展示如何从网络输出还原边界框坐标与类别概率,并实现可视化结果。
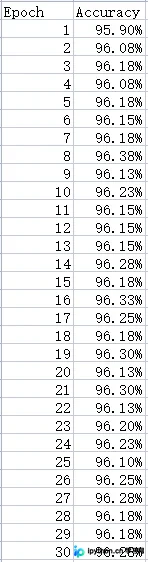
本文介绍了在 Python 中将数据写入 CSV 文件的两种常用方法。针对深度学习训练中每个 epoch 记录准确率的需求,分别演示了使用内置 csv 模块和 pandas 库进行追加写入的操作。重点讲解了如何处理追加模式下的表头重复问题,并提供了对应的代码示例与结果展示,帮助开发者快速实现日志数据的持久化存储。
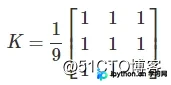
本文详细介绍 Python OpenCV 中的三种图像模糊(滤波)技术:均值滤波、高斯滤波及高斯双边滤波。通过解析 cv2.blur、cv2.GaussianBlur 和 cv2.bilateralFilter 函数的参数与原理,对比它们在去除椒盐噪声、高斯噪声及保边去噪方面的特性与适用场景,帮助开发者根据实际需求选择合适的滤波算法。
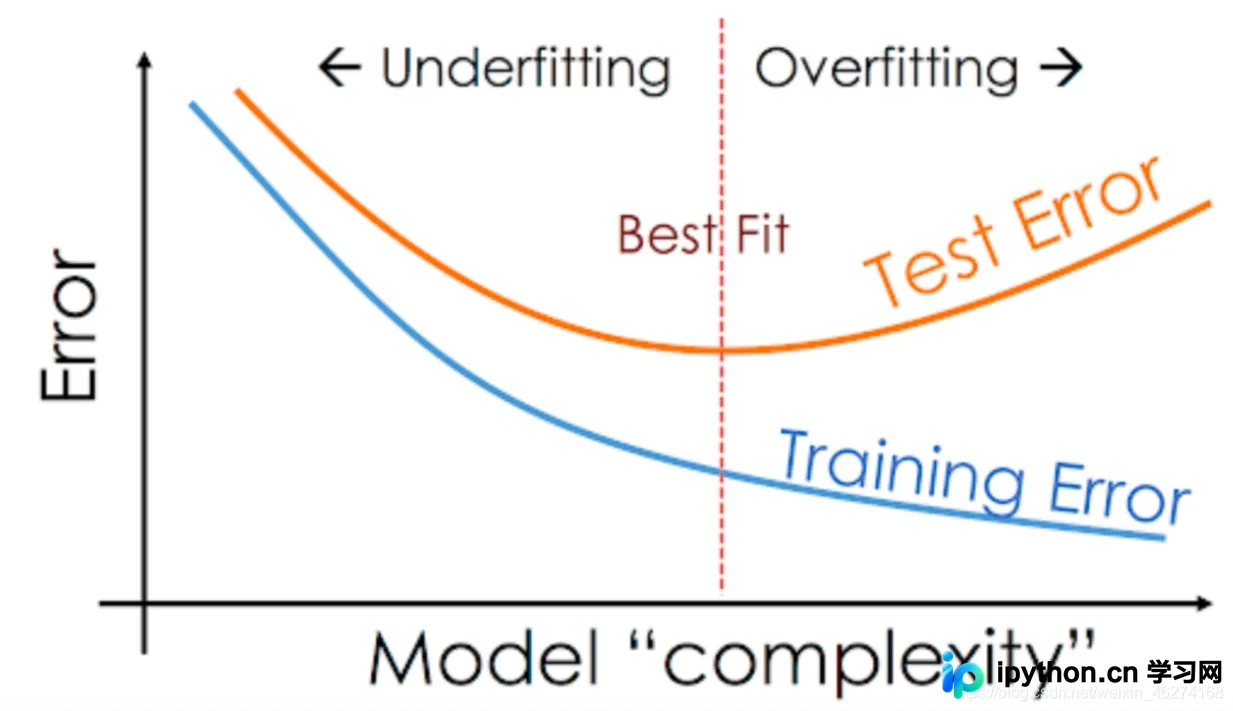
本文详解TensorFlow2中应对模型过拟合的五大策略。通过引入L2正则化约束参数、利用动量加速收敛、动态调整学习率、设置Early Stopping以及应用Dropout随机失活,有效提升测试集准确率。结合具体代码示例,帮助开发者构建更稳健的深度学习模型。