Python字符串切片详解:语法、示例与实战应用
本文详细介绍Python中字符串切片(Slicing)的核心语法,包括start、end和step参数的具体含义及使用规则。通过多个实际代码示例,演示如何获取指定范围的子字符串、使用负索引从末尾截取以及按步长提取字符。此外,还讲解了结合index函数根据特定字符定位并截取字符串的综合应用技巧,帮助开发者高效处理文本数据。
2026-10-15
0



本文详细介绍Python中字符串切片(Slicing)的核心语法,包括start、end和step参数的具体含义及使用规则。通过多个实际代码示例,演示如何获取指定范围的子字符串、使用负索引从末尾截取以及按步长提取字符。此外,还讲解了结合index函数根据特定字符定位并截取字符串的综合应用技巧,帮助开发者高效处理文本数据。
本文介绍如何在Python中将1到n的列表按步长3进行分组输出,并详细解析字符串切片中步长的用法。通过列表推导式实现分组,同时讲解正负步长的切片规则及索引计算方式,帮助开发者掌握Python序列操作的核心技巧。
本文总结了Python中去除字符串空格的几种常用方法。包括使用strip()、lstrip()和rstrip()处理首尾空格,利用replace()进行全局替换,以及结合split()和join()实现高效的全量空格移除。通过具体代码示例和结果展示,帮助开发者根据实际需求选择最合适的方法。
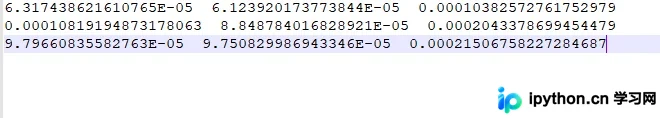
本文详解Python中读取TXT文件时split()函数的正确使用方法。通过对比带参与不带参的split(),揭示使用split(" ")引入空字符串和换行符的风险,并展示如何利用无参split()高效清理数据。文章提供将多行多列数据转换为二维列表和NumPy数组的完整代码示例,帮助开发者避免常见陷阱,提升数据处理效率。
本文介绍使用Python统计英文单词数量的方法。通过读取文本文件并按空格分割字符串,计算列表长度及空字符串数量,从而得出实际单词数。代码示例展示了从文件读取、分割到计数的完整流程,并与Word统计结果进行对比,误差在2%以内,可作为参考。
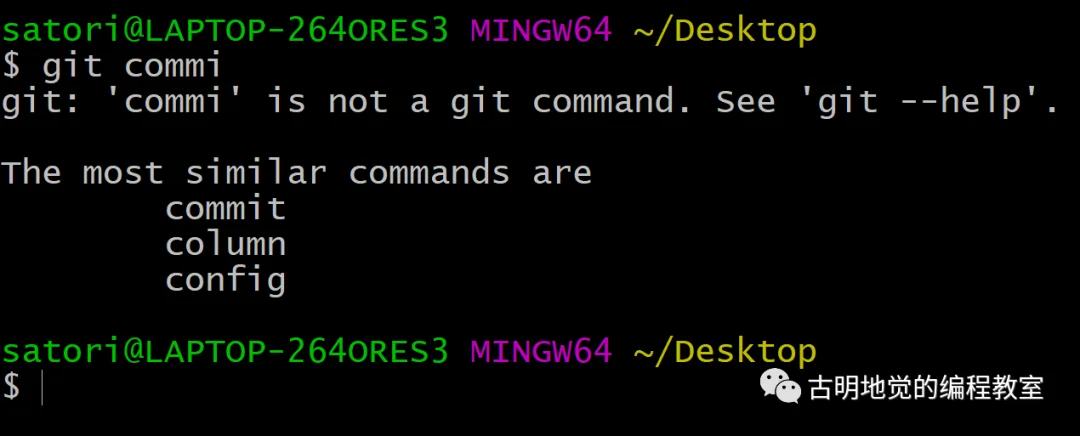
本文介绍如何使用 Python 的 fuzzywuzzy 库计算两个字符串之间的相似度。该库基于 Levenshtein Distance 算法,提供了 ratio、partial_ratio 等多种匹配模式。通过 fuzz 和 process 模块,可实现如 Git 命令输错时的相似命令推荐功能,并附带性能优化建议。
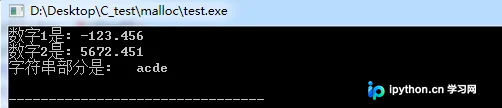
本文介绍C语言中利用strtof和strtod函数将字符串转换为单精度和双精度浮点数的方法。通过参数pEnd识别解析断点,支持十进制、十六进制及科学计数法格式,代码演示了连续解析与忽略首尾空格的完整操作流程。
本文介绍在Python中处理数字格式的两个常见问题:去除小数点后多余的0以及文件编号中的前导0。通过Decimal类的normalize()和to_integral()方法,结合自定义函数实现兼容处理,同时利用字符串格式化去除前导0,提供实用的代码示例。
本文详细介绍Python中五种字符串格式化内置方法:center用于居中填充,ljust左对齐,rjust右对齐,zfill数字补零,title首字母大写。通过具体参数说明与代码示例,解析各函数的行为逻辑、边界条件及潜在陷阱,帮助开发者掌握字符串对齐与格式化处理技巧。
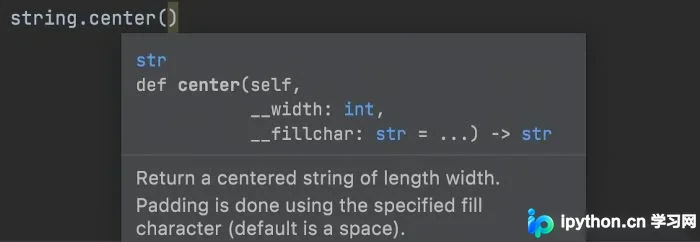
本文详细解析Python中字符串大小写转换的六种常用方法,包括lower()、upper()、capitalize()、title()、swapcase()及casefold()。重点对比lower()与casefold()在处理非ASCII字符时的差异,通过具体代码示例展示各方法的语法与运行结果,帮助开发者根据实际需求选择合适的大小写转换策略。
本文深入解析Python中两种主要的字符串格式化方式:%占位符与str.format()。详细对比了默认位置、指定索引、列表解包及字典键值对等format用法,并涵盖补零、精度控制等高级格式化技巧,帮助开发者掌握高效、灵活的字符串处理方案。
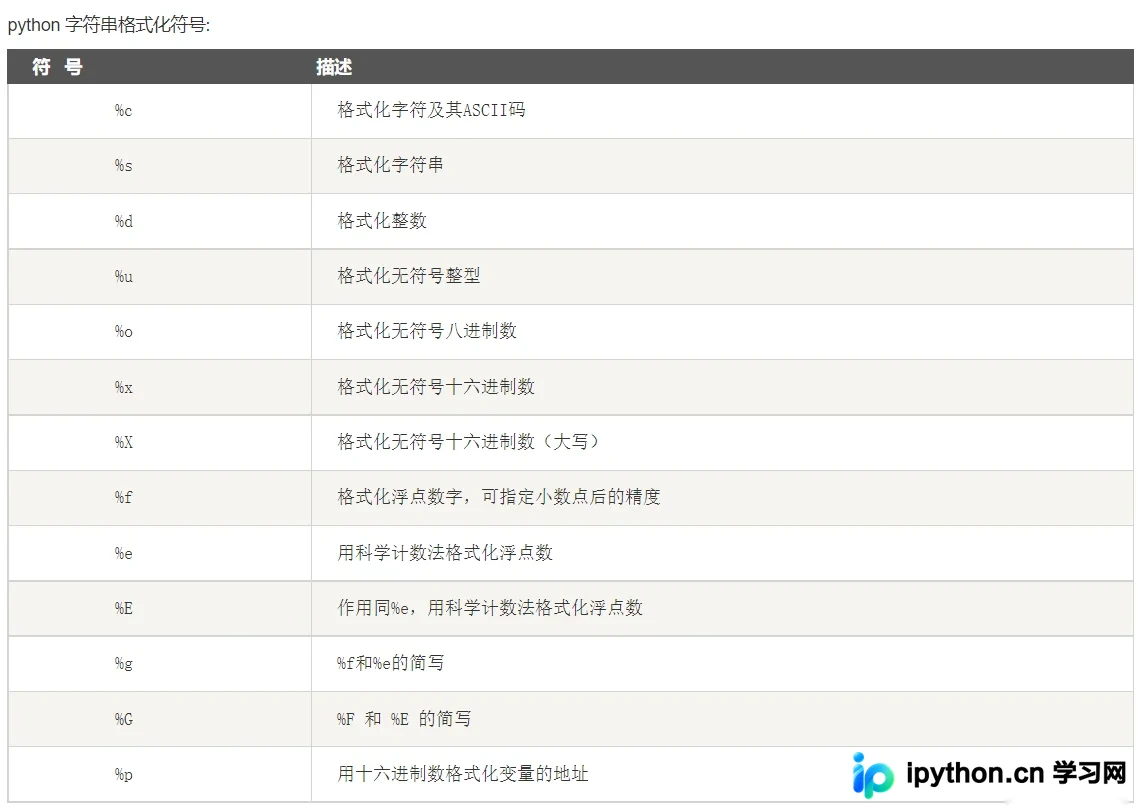
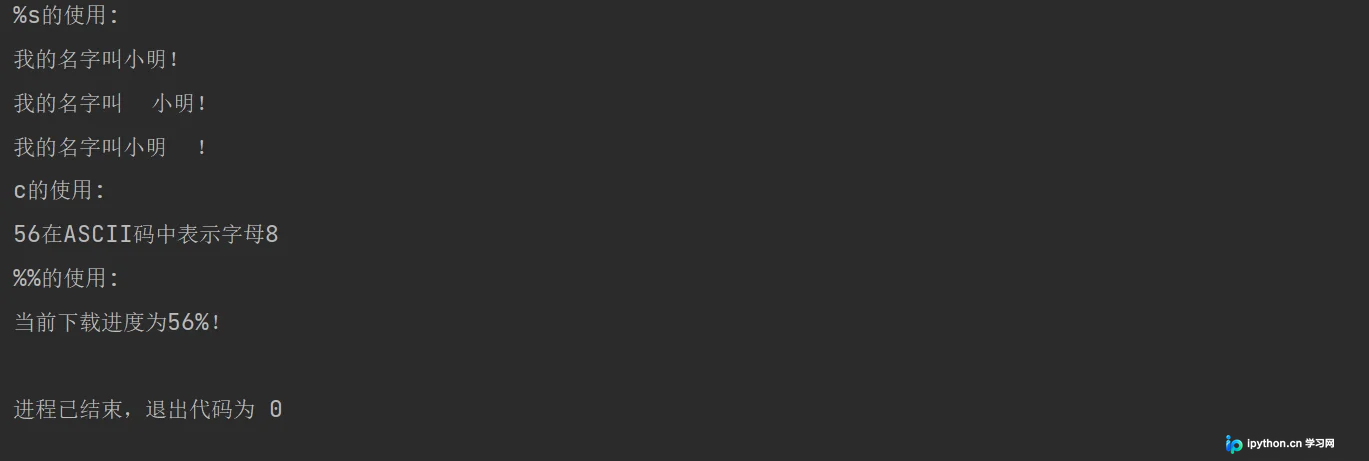
本文详细介绍Python中两种主要的字符串格式化方式:传统的%占位符和更灵活的format方法。内容涵盖%占位符对整数、浮点数、字符及特殊符号的处理,包括对齐方式、精度控制及进制前缀显示;同时解析format方法的三种用法:无位置指定、命名参数及索引指定,帮助开发者掌握高效、规范的字符串输出技巧。