


Python fuzzywuzzy 字符串相似度计算与命令纠错实现

本文介绍如何使用 Python 的 fuzzywuzzy 库计算两个字符串之间的相似度。该库基于 Levenshtein Distance 算法,提供了 ratio、partial_ratio 等多种匹配模式。通过 fuzz 和 process 模块,可实现如 Git 命令输错时的相似命令推荐功能,并附带性能优化建议。
fuzzywuzzy 与 Levenshtein 算法基础
fuzzywuzzy 是一个用于计算字符串相似度的 Python 库,其核心依据是 Levenshtein Distance(编辑距离)算法。编辑距离定义为将一个字符串转换为另一个字符串所需的最少单字符编辑操作次数,这些操作包括插入、删除或替换字符。通常情况下,计算出的编辑距离越小,表明两个字符串的相似度越高。
接下来展示该模块的基本使用方法,其调用方式十分直观:
fuzz 模块常用匹配函数演示
from fuzzywuzzy import fuzz

# 调用 fuzz.ratio 即可计算两个字符串的相似度
print(
    fuzz.ratio("古明地觉", "古明地恋")
)  # 75

# 我们看到 ratio 是完全匹配的
# 它把字符串的长度也考虑在内了
print(
    fuzz.ratio("古明地觉", "古明地觉aa")
)  # 80

# partial_ratio是非完全匹配
# 如果一方结束了,那么剩下的就不考虑了
print(
    fuzz.partial_ratio("古明地觉", "古明地觉,小五萝莉")
)  # 100

# token_sort_ratio表示忽略顺序匹配
# 但前提是多个词,以空格进行分隔
print(
    fuzz.ratio("古 明 地 觉", "古 明 地 觉"[:: -1])
)  # 25
print(
    fuzz.token_sort_ratio("古 明 地 觉", "古 明 地 觉"[:: -1])
)  # 100

# token_set_ratio表示去重匹配
# 同样:前提是多个词,以空格进行分隔
print(fuzz.ratio("a a a he", "a he"))  # 67
print(
    fuzz.token_set_ratio("a a a he", "a he")
)  # 100
在使用 git 时,若输入的命令不存在,系统会提示该命令无效。值得注意的是,git 还会进一步提示一些与错误输入命令高度相似的可用命令。
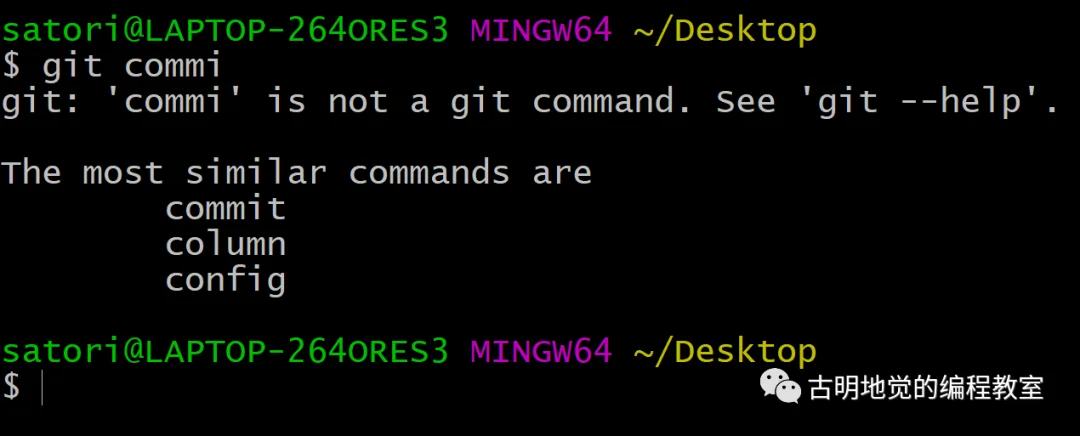
这一功能正是利用了字符串相似度计算的原理,系统会找出与用户输入错误命令最接近的几个正确命令,并予以提示。
如果我们开发一个通过命令行参数交互的程序,当用户输入不存在的命令时,也可以采用类似的纠错机制。实现这一功能的方法很简单:将所有可用命令与用户输入的错误命令逐一计算相似度,最后返回相似度最高的前 n 个结果即可。
上述 fuzz 模块的功能足以实现这一需求。此外,fuzzywuzzy 还提供了一个 extract 函数,使得这一过程更加便捷。
利用 process 模块实现命令纠错
from fuzzywuzzy import process

words = ["hello python", "hello java",
         "hello golang", "hello php"]
# 会自动和 words 里面的每一个元素进行比较
# 然后按照相似度从高到低排列
print(process.extract("hello thon", words))
"""
[('hello python', 91), ('hello php', 74),
 ('hello golang', 73), ('hello java', 64)]
"""

# 还可以传入一个 limit 参数
# 表示只返回前 limit 个,默认为5
print(
    process.extract("hello thon", words, limit=2)
)
"""
[('hello python', 91),
 ('hello php', 74)]
"""

# 返回分数最高的,此时返回一个元组
print(
    process.extractOne("hello thon", words)
)
"""
('hello python', 91)
"""
该模块的整体使用难度较低,但其核心价值在于背后的字符串相似度计算原理,建议有兴趣的读者深入探究相关算法。
在使用 fuzzywuzzy 模块时,可能会遇到如下警告信息:
UserWarning: Using slow pure-python SequenceMatcher. Install python-Levenshtein to remove this warning
性能优化与 python-Levenshtein 安装
该警告提示我们可以通过安装 python-Levenshtein 库来解决。这是一个专门用于加速字符串匹配的库,能够提供 4 到 10 倍的性能提升。即使不安装该库,fuzzywuzzy 底层也会默认使用标准库中的 difflib 进行匹配,只是会弹出上述警告而已。
至此,关于 Python 结合 fuzzywuzzy 计算字符串相似度的介绍已完成。如需了解更多相关 Python 及 fuzzywuzzy 的内容,欢迎查阅本站往期文章或继续浏览后续内容,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















