详解Python中四种关系图数据可视化的效果对比
本文基于Python的NetworkX库,详细对比了四种关系图可视化布局的效果。通过模拟DataFrame数据,分别演示了随机分布、放射状、特征值向量及图形边缘化(壳层)模型。文章提供了完整的代码实现与参数设置,帮助开发者根据数据特性选择最合适的可视化方案,以清晰展示节点间的关联关系。
2026-10-16
0



本文基于Python的NetworkX库,详细对比了四种关系图可视化布局的效果。通过模拟DataFrame数据,分别演示了随机分布、放射状、特征值向量及图形边缘化(壳层)模型。文章提供了完整的代码实现与参数设置,帮助开发者根据数据特性选择最合适的可视化方案,以清晰展示节点间的关联关系。
针对MySQL范围查询导致的索引失效及排序性能问题,详解最左匹配原则与实际建表策略。通过等值条件优先于范围条件、利用IN替代离散范围、避免Server层文件排序(filesort)等方法,有效利用索引有序性,实现查询加速。
本文深入解析C语言数据在内存中的存储机制。涵盖整型提升规则、原反补码计算原理及大小端存储模式的判断方法,并通过多个代码实例演示截断、精度丢失与符号位扩展对程序输出的影响,帮助理解底层数据行为。
本文详细演示使用Python进行学生成绩等级预测的全过程。从数据预处理、特征选取开始,分别构建单一决策树与多种集成学习模型(Bagging、Random Forest、AdaBoost、GBDT)。通过对比优化前后的模型得分,验证Bagging算法在预测精度上的优势,为教育数据挖掘提供实践参考。
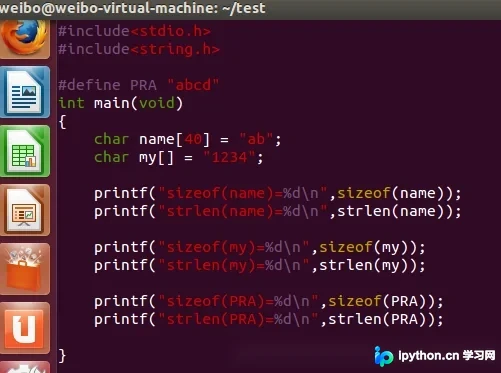
本文深入解析C语言中sizeof运算符与strlen函数的核心区别。通过代码实例说明sizeof计算变量或类型的内存字节数,而strlen统计以空字符结尾的字符串实际长度,且涉及32位与64位系统下指针大小的不同(分别为4和8字节)。掌握两者差异能有效避免内存访问错误并优化程序逻辑。
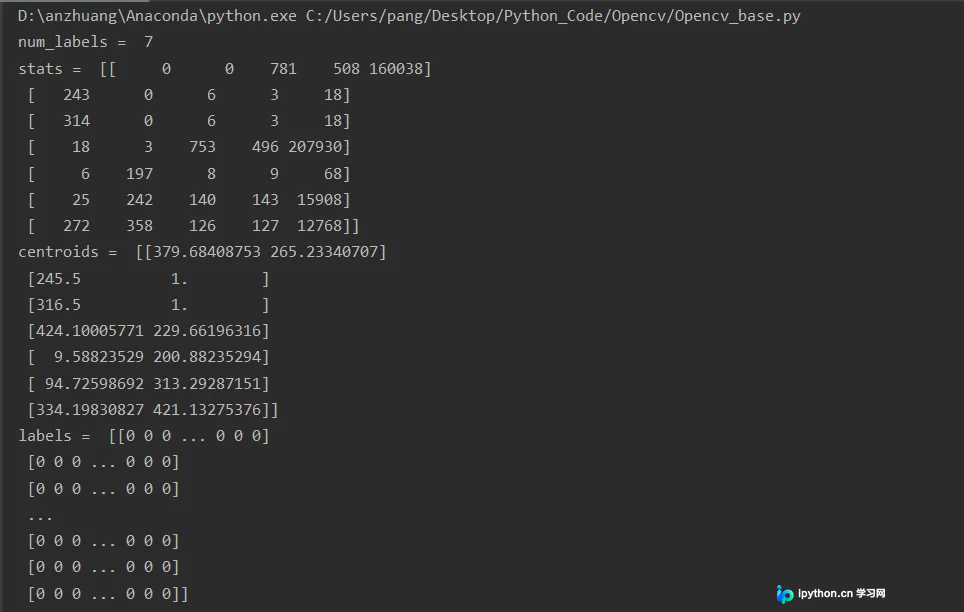
本文详细介绍OpenCV中用于连通域处理的两个核心函数:connectedComponents()与connectedComponentsWithStats()。通过对比两者在参数设置、返回值结构及信息丰富度上的差异,结合Python代码实例,演示如何从二值图像中提取连通域、获取边界框、面积及中心点等关键统计信息,并探讨预处理对检测结果的影响。
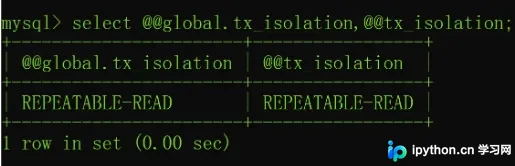
MySQL提供四种事务隔离级别以应对并发带来的数据一致性挑战。本文将详细解析读未提交、读已提交、可重复读(MySQL默认)及序列化级别的特性,重点说明脏读、不可重复读和幻读的成因与区别,并通过多会话SQL演示直观展示各隔离级别在真实场景下的行为表现。
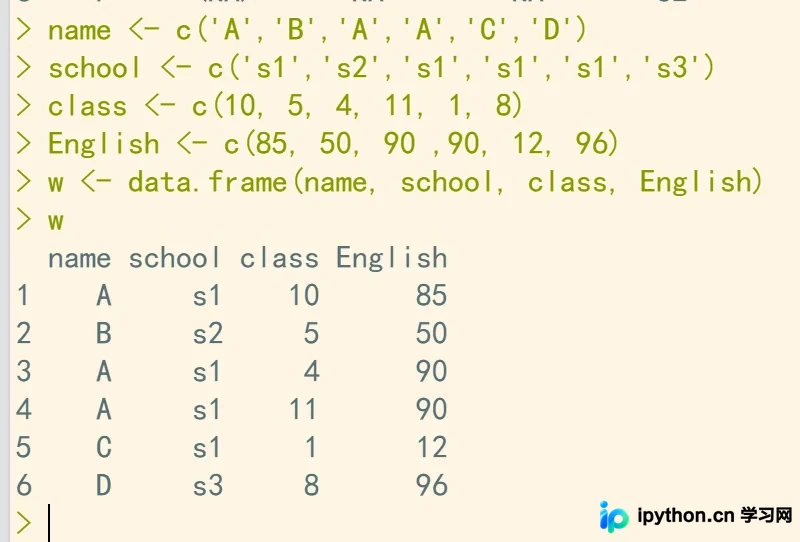
本文详细解析R语言中用于合并数据框(data.frame)的merge函数。通过创建测试数据,逐步演示如何根据指定列进行内连接、左连接、右连接及全外连接。重点讲解by、all、all.x、all.y等关键参数的实际效果,帮助用户掌握处理缺失值填充与多表关联的正确方法。
本文介绍如何使用OpenCV从图像中提取颜色和形状特征。通过转换至HSV、LAB、YCrCb等色彩空间,利用cv2.inRange进行颜色屏蔽,并结合cv2.findContours提取形状轮廓。内容涵盖色彩空间原理及具体代码实现,帮助开发者掌握基础特征提取技术。
在PHP开发中,文件缓存是优化读取速度的常见手段。主要涉及两种策略:通过include包含PHP文件执行赋值,或先序列化数据存盘再反序列化还原。实测表明,serialize方案因省去了解析与执行环节,效率显著更高。但需注意,serialize的明文存储存在信息泄露风险,而include方式则具备更好的隐蔽性与安全性。开发者应根据数据安全敏感度权衡选型。
本文以某地1958-2021年降水量数据为例,使用R语言进行时间序列建模。通过时序图、自相关图及Ljung-Box检验判断序列平稳性与纯随机性,利用auto.arima自动定阶选择最优MA(1)模型,完成参数估计与残差诊断后,对未来5年降水趋势进行可视化预测。
深入解析C语言从源代码到可执行程序的转换机制,涵盖翻译环境下的预处理、编译、汇编及链接四个核心阶段。通过Linux平台gcc命令行工具,逐步展示源码转换为机器代码的具体操作与原理,同时简述程序在运行时的内存加载与执行环境,帮助开发者构建完整的C语言底层认知体系。