


Python决策树与集成学习预测学生成绩等级:从数据预处理到模型优化

发布时间:2026-10-15 |
4人浏览过
本文详细演示使用Python进行学生成绩等级预测的全过程。从数据预处理、特征选取开始,分别构建单一决策树与多种集成学习模型(Bagging、Random Forest、AdaBoost、GBDT)。通过对比优化前后的模型得分,验证Bagging算法在预测精度上的优势,为教育数据挖掘提供实践参考。
1.数据准备
1.1 引入头文件
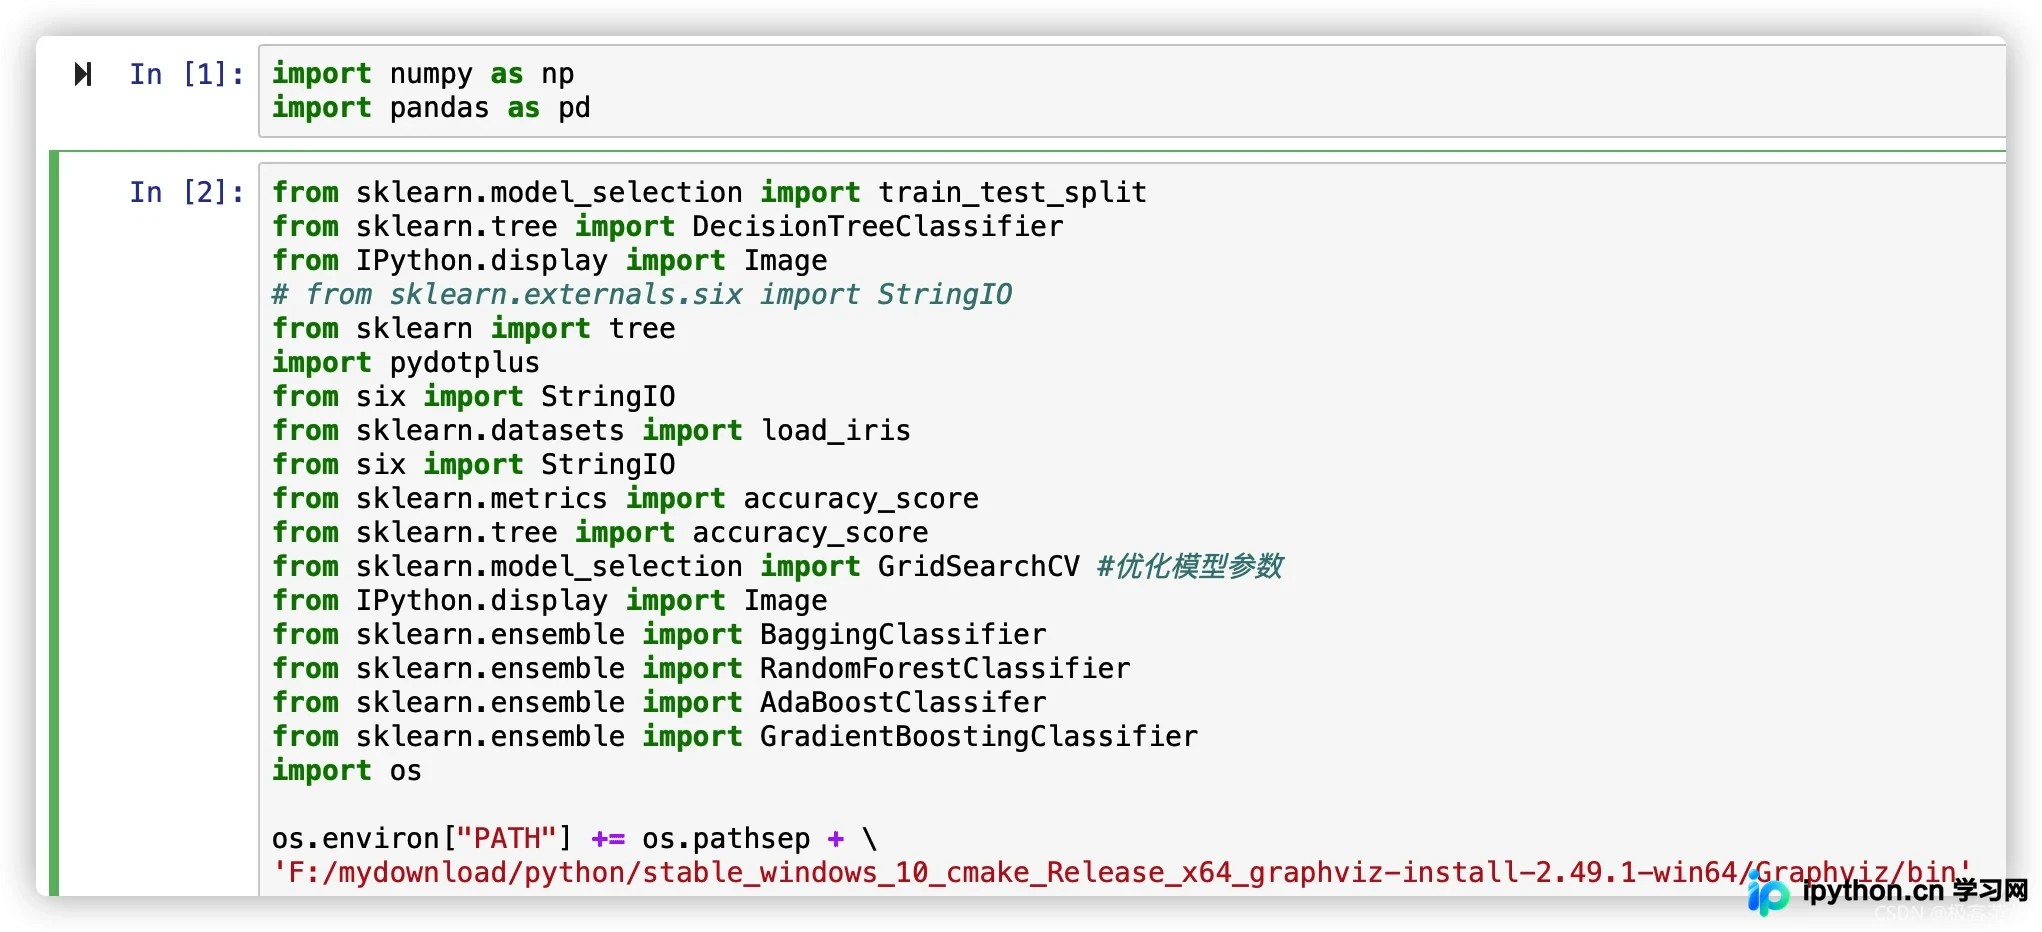
在编写代码前,需确保已安装必要的依赖库。若部分库无法通过pip直接安装,则需采用手动导入依赖的方式进行处理。
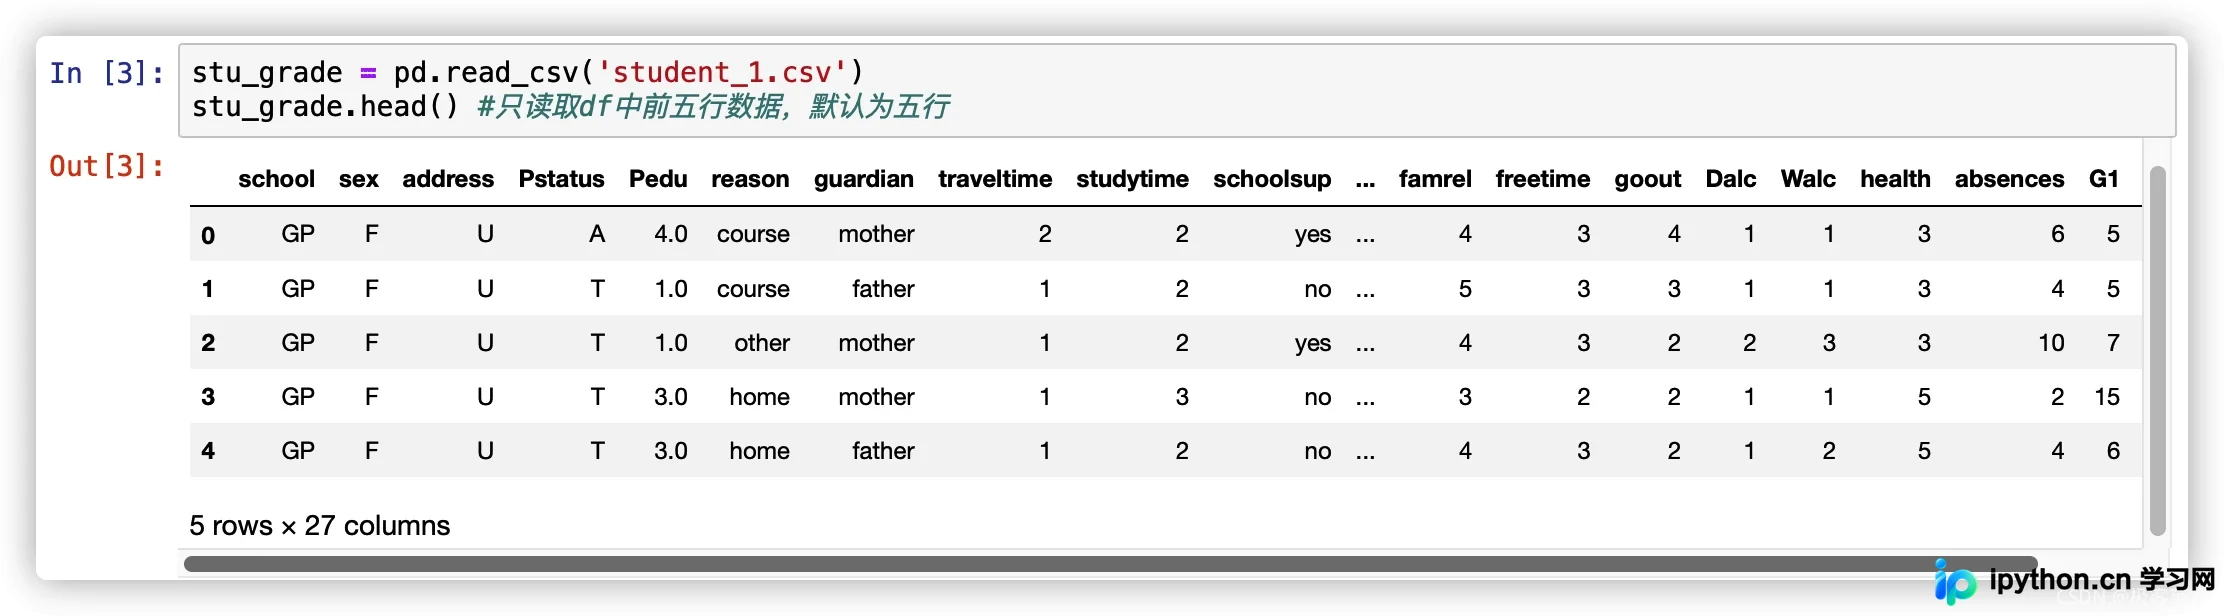
1.2 把student_1.csv数据拖入代码的同一文件夹下,同时读取文件中的数据
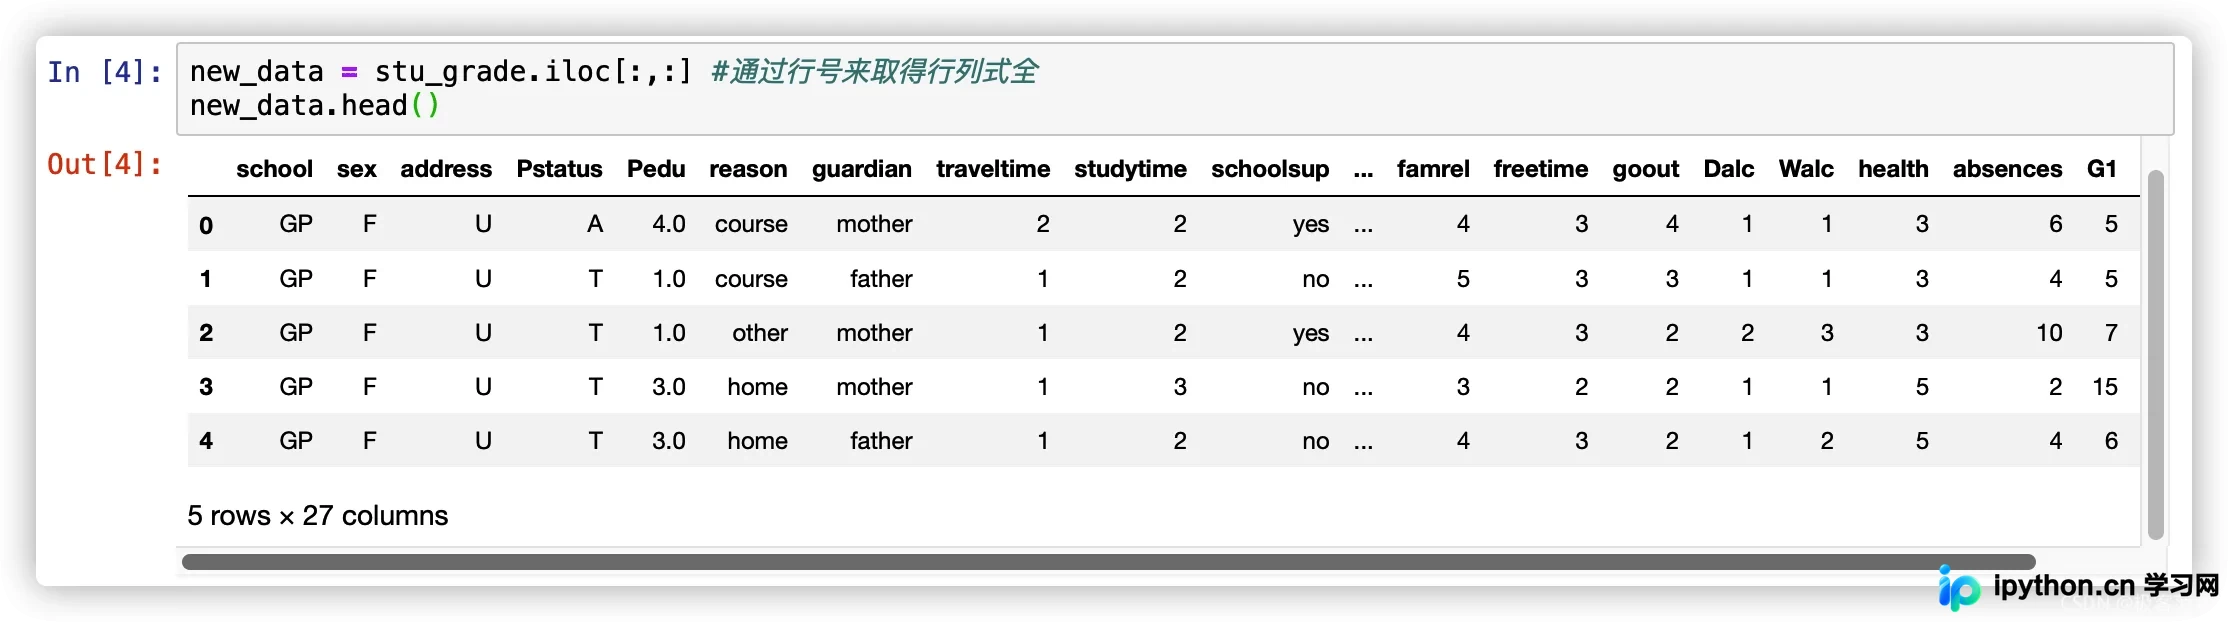
1.3 特征选取
参考课件中选取了16个特征值,本例中为了更全面地分析,采用了数据集中的所有特征值进行后续处理。
2.数据处理
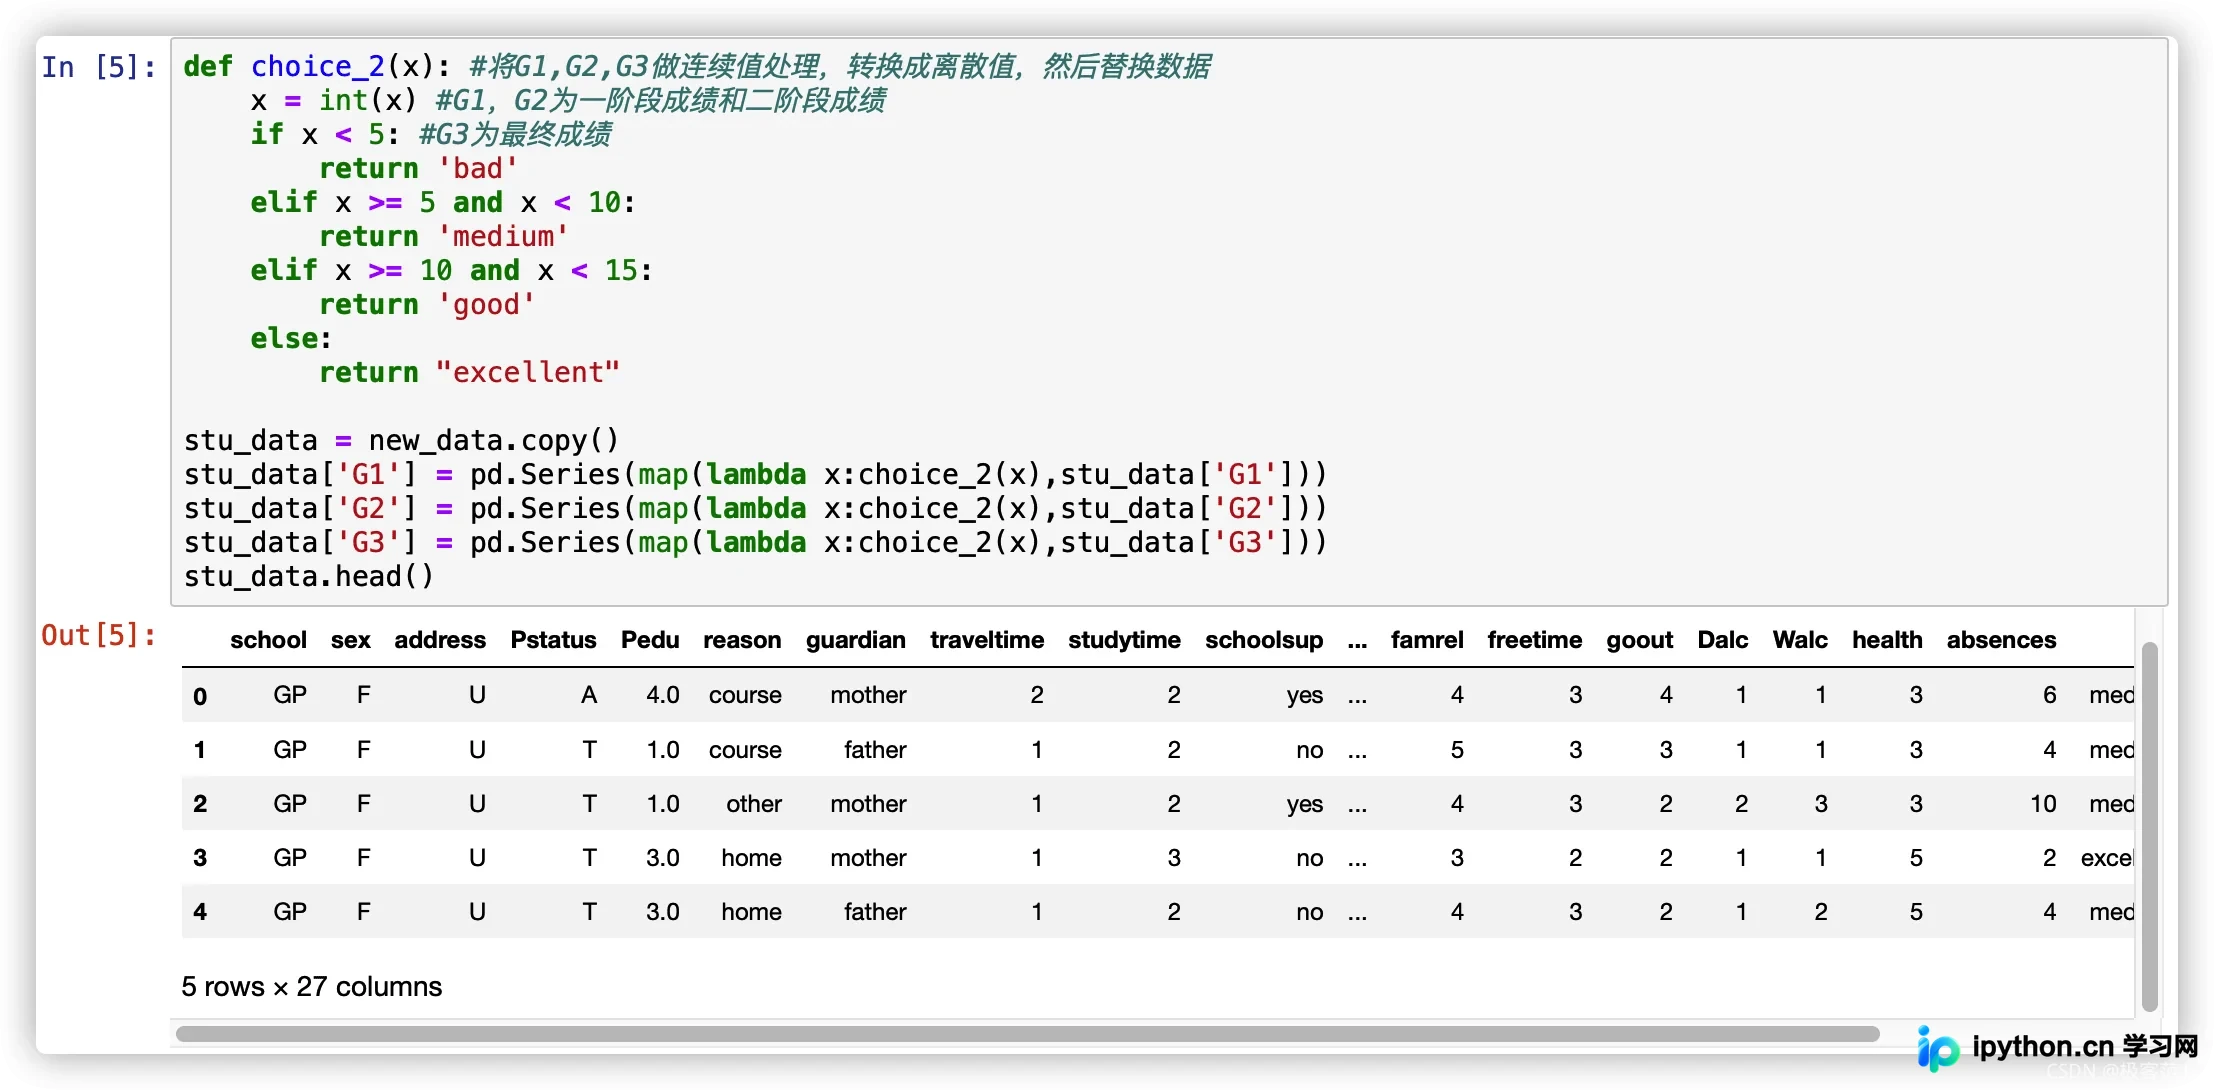
2.1 对G1、G2、G3处理
针对离散型变量进行连续化处理,并定义lambda函数以计算G1、G2和G3的具体数值。
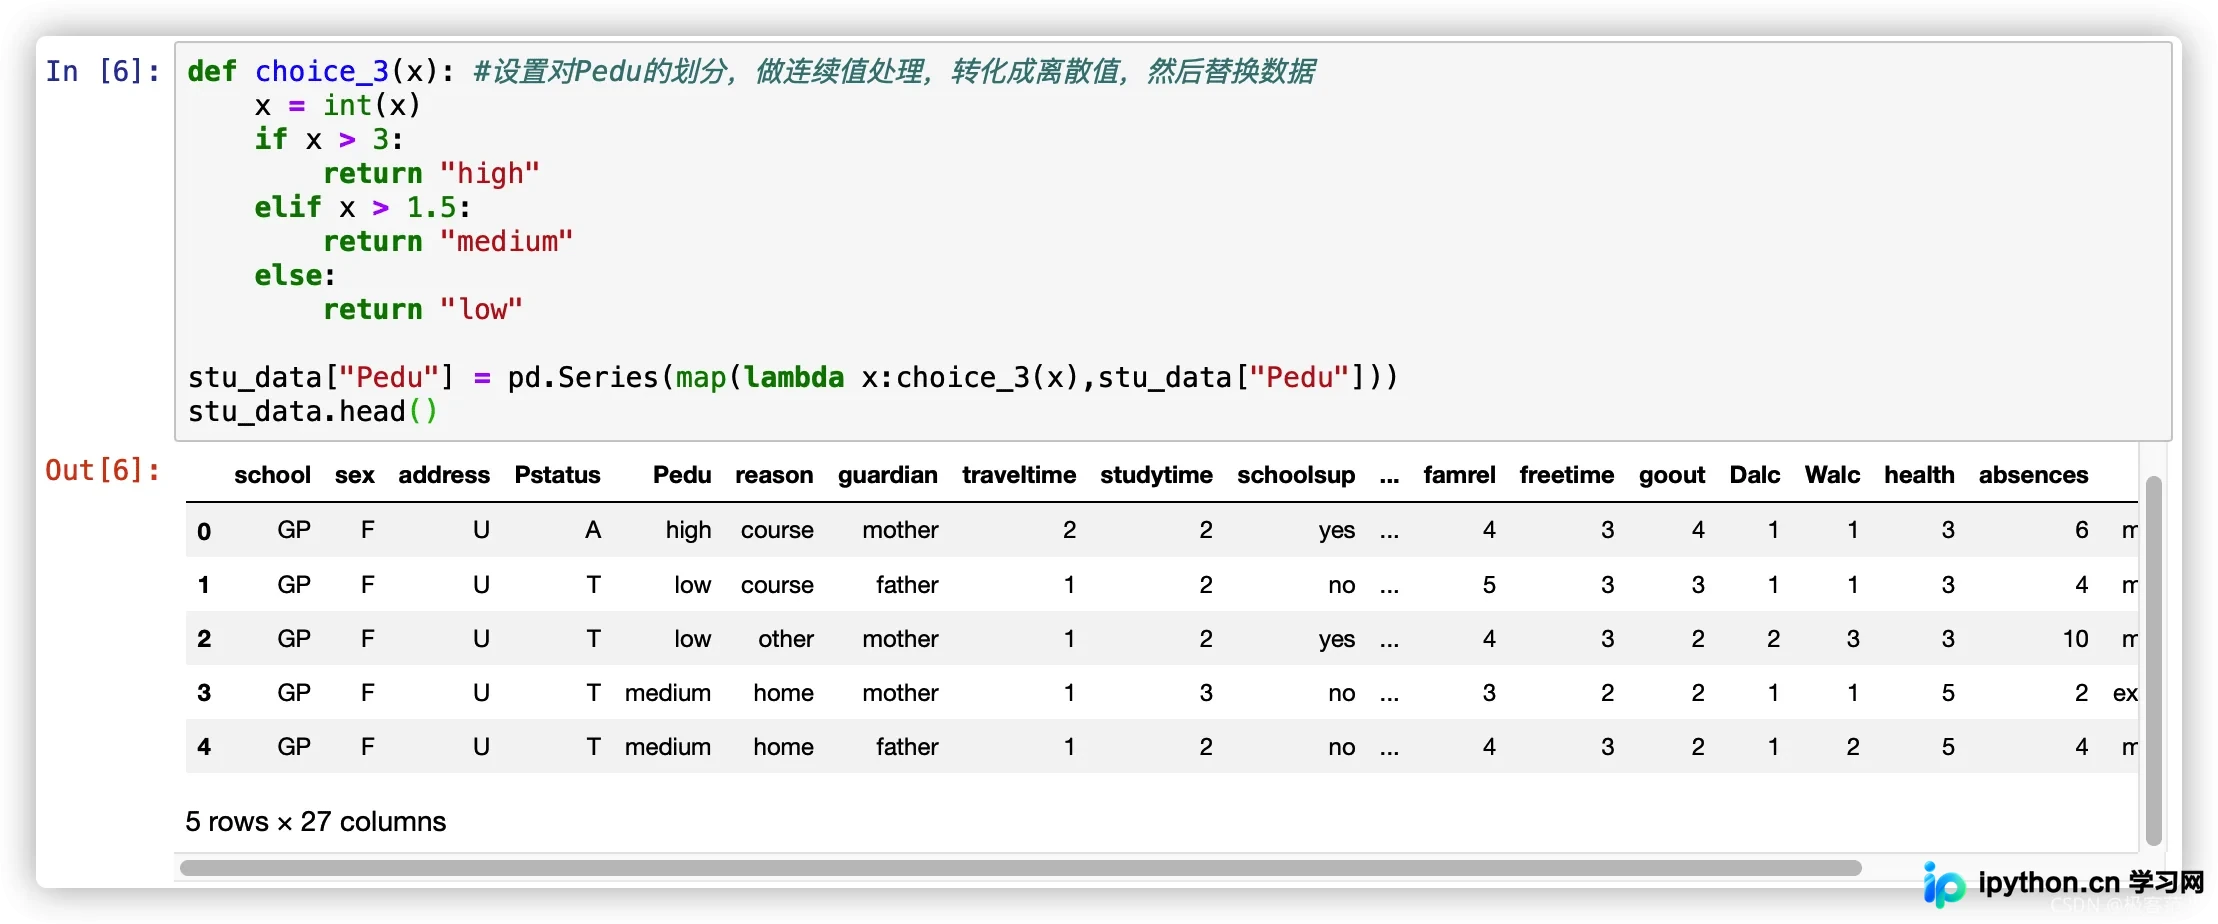
2.2 同样对Pedu参数进行连续值处理
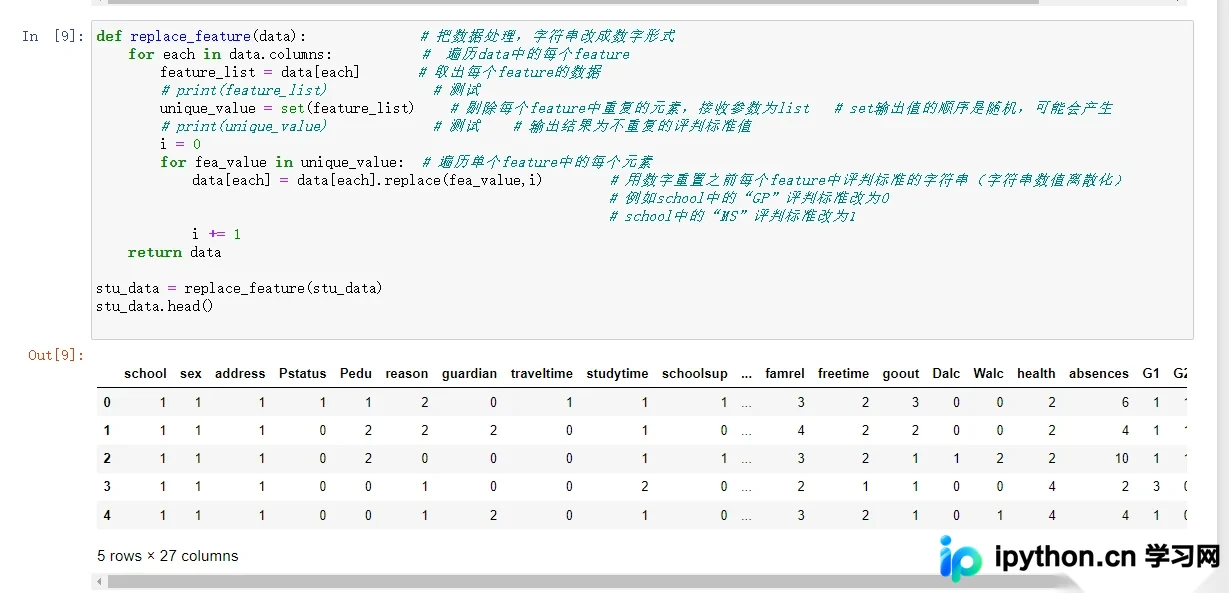
2.3 由于数据集中各参数的数值差异较大,此处将所有特征参数统一转换为数字形式,以消除量纲影响。
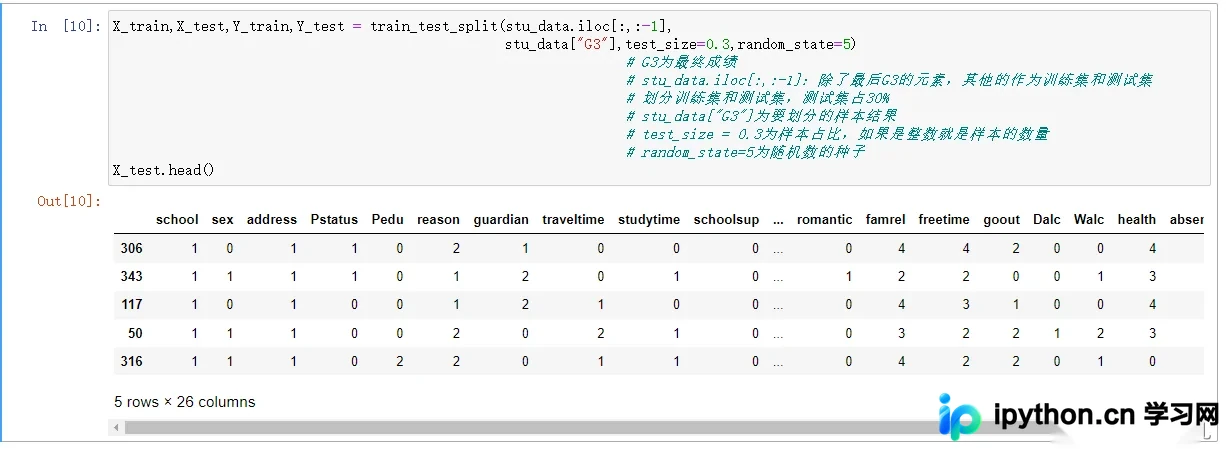
2.4 对于当前处理过的数据集,划分训练集和测试集,并设置好随机种子等其他参数
3.训练得到的模型
3.1 决策树
3.1.1 开始对训练集中的数据进行训练
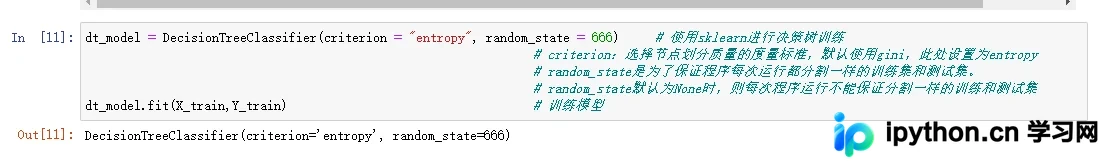
训练完成后,利用模型设置图像参数以进行可视化展示,直观呈现决策路径。
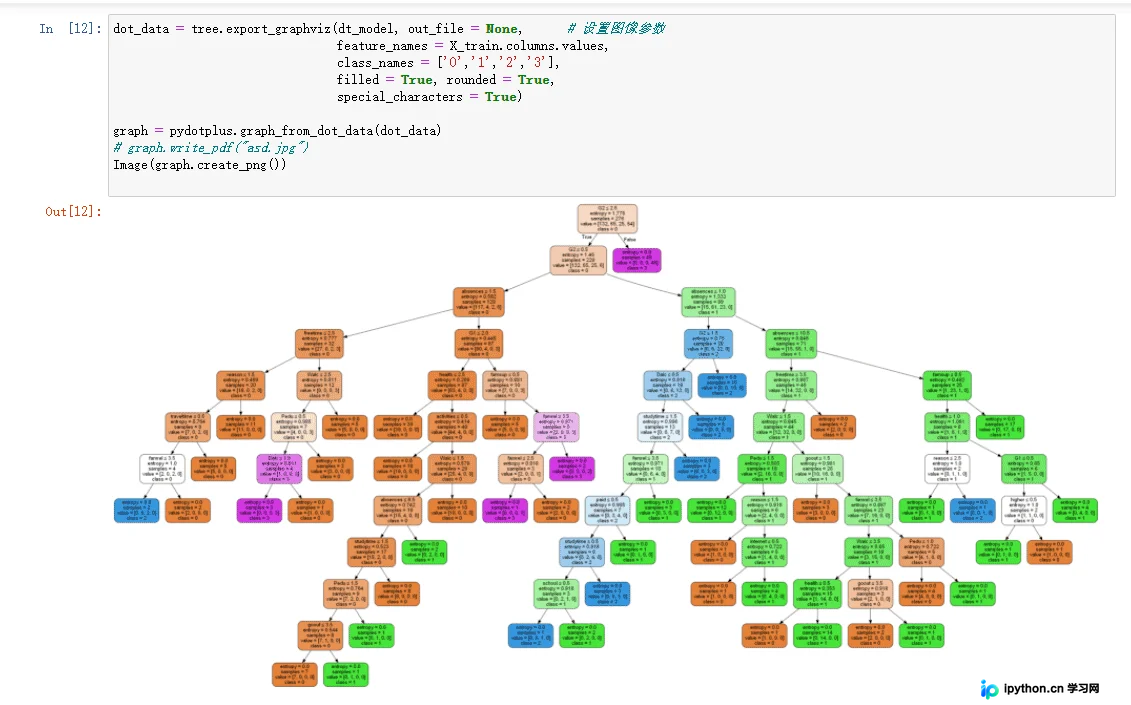
3.1.2 利用已经训练好的模型来预测G3的值
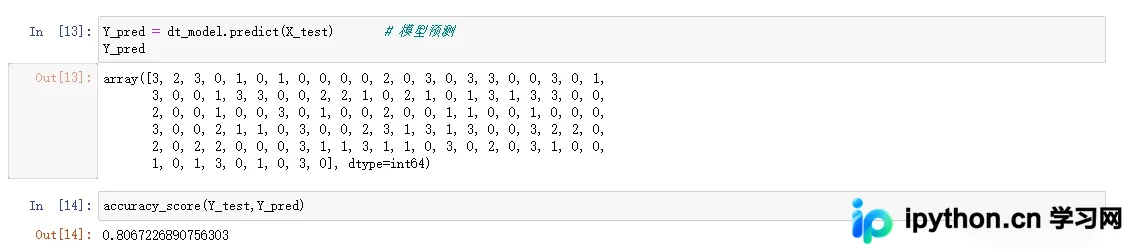
对训练好的模型进行打分评估,获取基础性能指标。
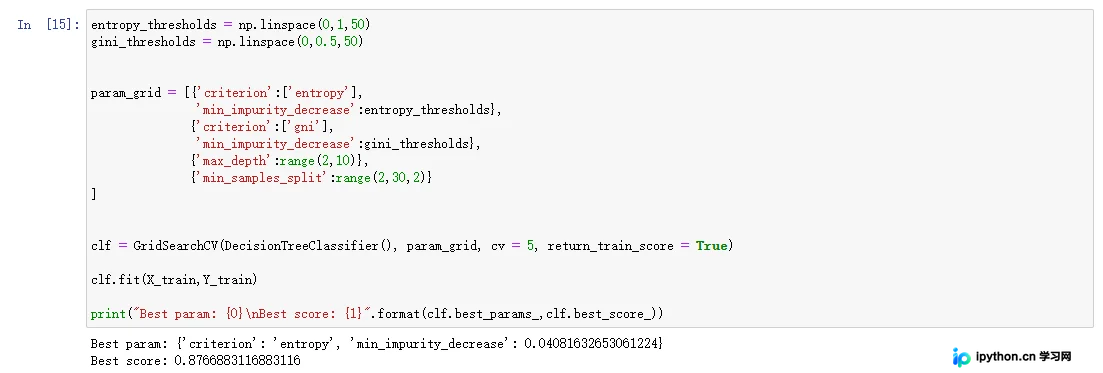
3.1.3 对模型中的参数进行优化,输出优化后最好的分数
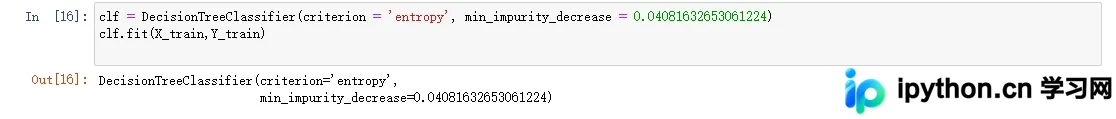
3.1.4 优化后的模型来绘制决策树
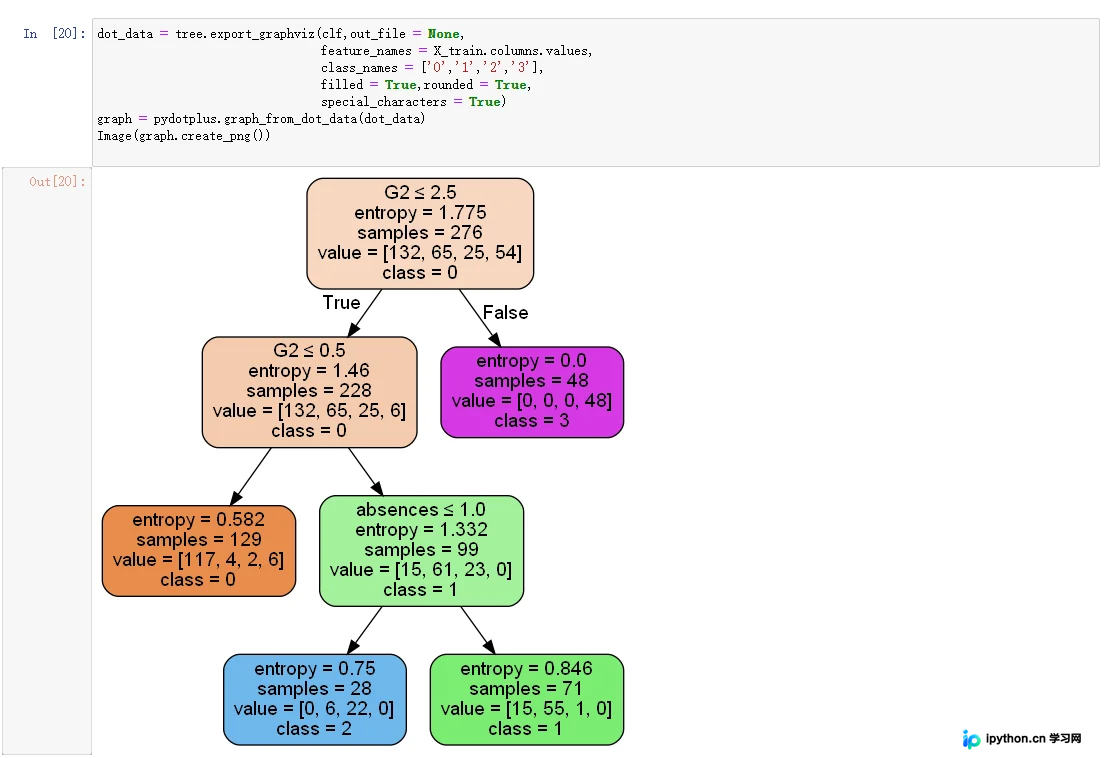
输出优化后的分数,对比优化前后的效果。
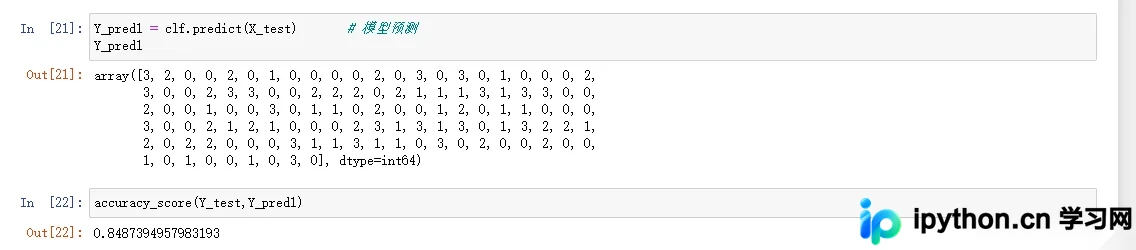
3.2 集成学习
重新划分数据集,用于后续集成学习模型的训练。

3.2.1 Decision Tree
此处采用集成学习中的多决策树策略进行模型训练,并对模型性能进行评估。
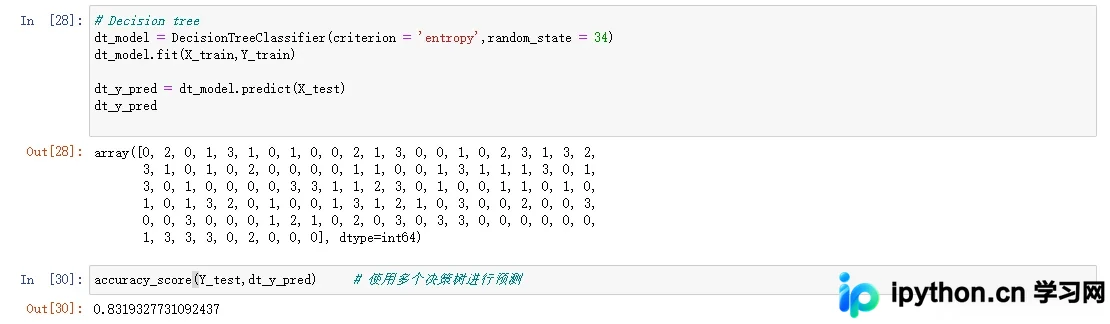
3.2.2 Bagging算法
应用集成学习中的Bagging算法训练模型,并对预测结果进行分数估测。
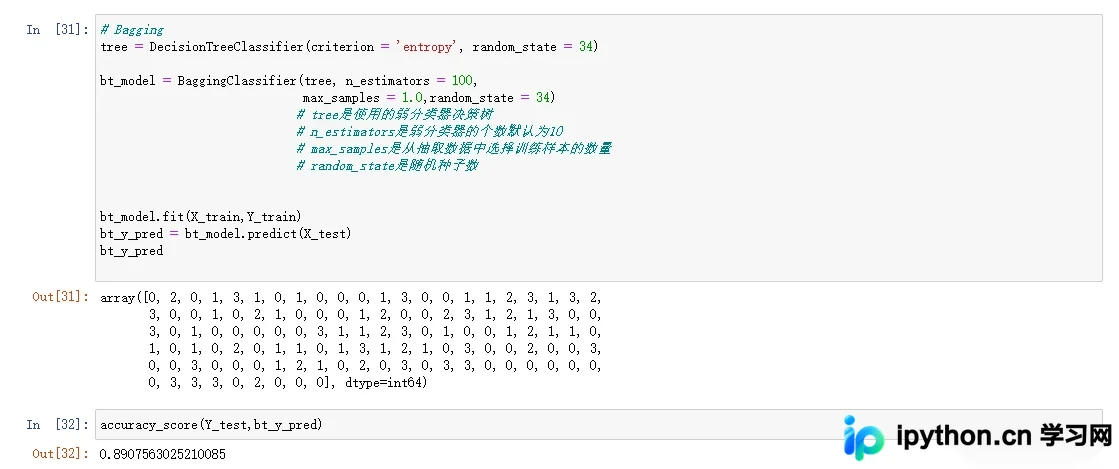
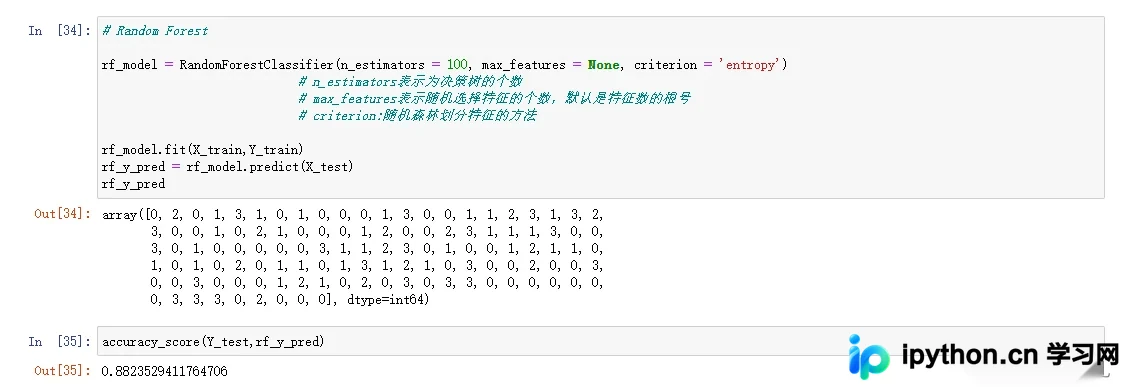
3.2.3 这里采用集成学习的Random Forest算法进行训练模型,对模型做出分数估测
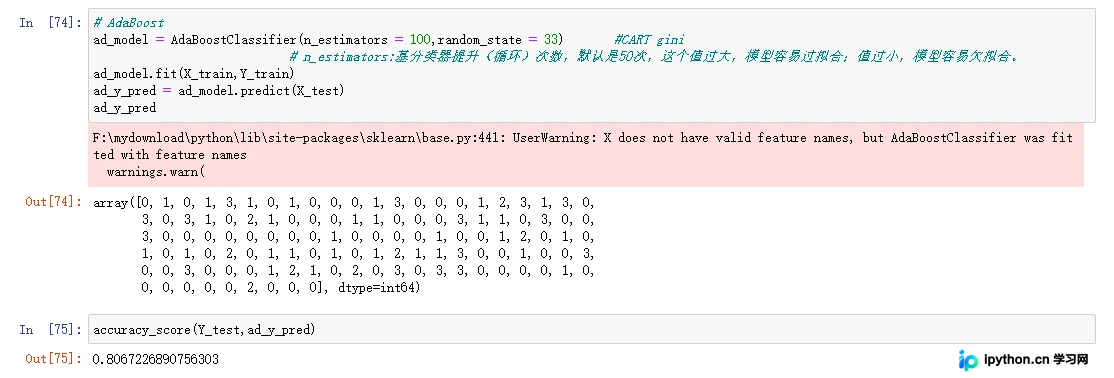
3.2.4 这里采用集成学习的AdaBoost算法进行训练模型,对模型做出分数估测
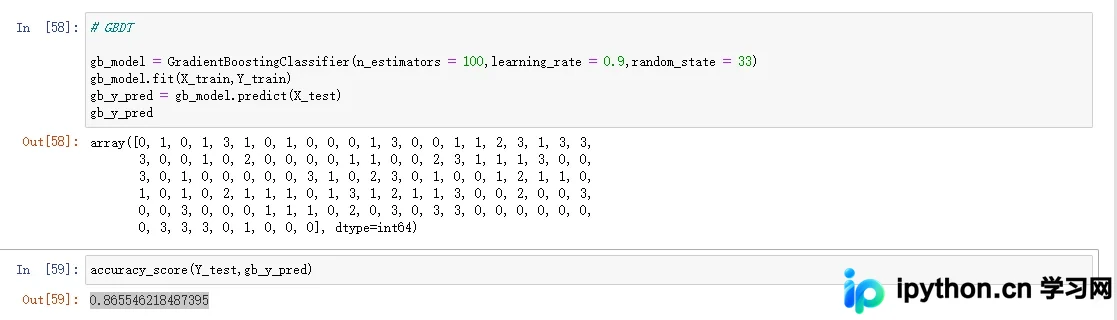
3.2.5 这里采用集成学习的GBDT算法进行训练模型,对模型做出分数估测
4.评价结果:
| 模型 | 得分 |
|---|---|
| 决策树(优化前) | 0.806 |
| 决策树(优化后) | 0.848 |
| 多个决策树 | 0.831 |
| Bagging | 0.890 |
| Random Forest | 0.882 |
| AdaBoost | 0.806 |
| GBDT | 0.865 |
5.结论分析
基于决策树和集成学习两大类模型的训练结果可以看出:两种实现方式各有优劣。
决策树在优化参数前后,预测结果有较明显的提升,且可视化图片便于观察模型结构。在集成学习中,Bagging算法的预测效果最佳,得分最高;相比之下,AdaBoost算法的表现相对较弱。
以上就是python决策树预测学生成绩等级实现详情的详细内容,更多关于python决策树预测学生成绩等级的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















