MySQL分区之KEY分区详解
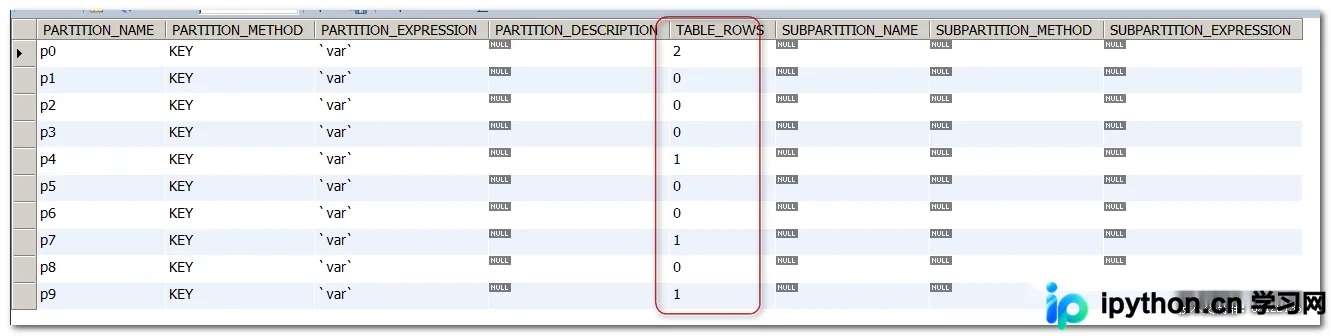
本文详解MySQL数据库的KEY分区机制。与HASH分区相比,KEY分区支持TEXT和BLOB以外的所有数据类型,并自动调用系统内置哈希函数进行分配。文章通过创建常规KEY、线性KEY分区的SQL实例,演示了分区管理的增删操作及移除分区分区定义的方法,帮助优化大数据量下的存储与查询效率。
2026-10-16
0



本文详解MySQL数据库的KEY分区机制。与HASH分区相比,KEY分区支持TEXT和BLOB以外的所有数据类型,并自动调用系统内置哈希函数进行分配。文章通过创建常规KEY、线性KEY分区的SQL实例,演示了分区管理的增删操作及移除分区分区定义的方法,帮助优化大数据量下的存储与查询效率。
本文深入解析 MySQL 8.0 引入的自增主键(AUTO_INCREMENT)持久化特性。通过对比 MySQL 5.7,详细说明该机制如何利用 redo log 防止数据库重启后的 ID 重复与业务冲突。包含完整的建表、插入、删除及重启测试步骤,帮助开发者理解版本差异并安全平滑升级。
本文详解 MySQL 如何添加联合唯一索引以约束多列数据组合的唯一性,包括 ALTER TABLE 建表后添加、CREATE INDEX 建表前创建的方法。重点解析 INSERT ... ON DUPLICATE KEY UPDATE 语句处理冲突记录的逻辑,以及使用 ALTER IGNORE TABLE 清理历史重复数据的操作。同时补充了主键、普通索引及全文索引的常见语法,帮助数据库开发高效维护数据完整性。
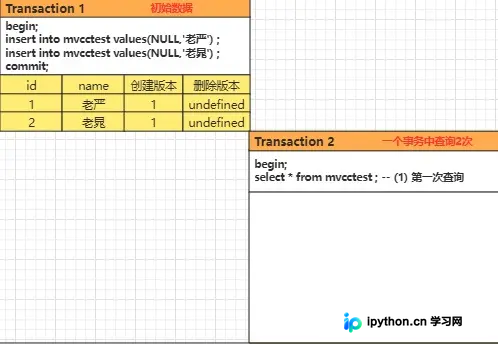
本文深入解析MySQL InnoDB存储引擎的多版本并发控制(MVCC)机制。通过区分当前读与快照读,结合DB_TRX_ID、回滚指针及Read View等核心组件,阐述如何在非阻塞状态下实现高并发读写。了解MVCC如何通过维护数据多个历史版本,确保事务在特定隔离级别下读取数据的一致性与可见性规则。
本文通过实际 SQL 操作和 EXPLAIN 执行计划,详细验证 MySQL 联合索引的最左前缀匹配原则。文章对比了单一索引与联合索引在精确查询及 LIKE 模糊查询中的表现,揭示了范围查询中断索引匹配的规则,帮助开发者在日常 MySQL 调优中正确设计和使用复合索引。
本文详细解析MySQL中REGEXP正则表达式的用法,重点阐述其与LIKE在匹配机制上的核心差异。通过整理空白元字符、字符类、断言等关键符号及SQL实例,帮助开发者掌握更灵活的条件过滤技巧,适用于模糊搜索、格式校验及数据清洗场景。
本文详解如何将项目数据库从MySQL迁移至基于PostgreSQL内核的OpenGauss。涵盖Docker容器化安装、DataGrip连接配置、SQL语法差异调整(如数据类型与函数替换)、Spring Boot后端JDBC驱动与YML配置修改,以及Vue前端通过Nginx Docker化部署的完整步骤,帮助开发者顺利完成异构数据库切换与项目上线。

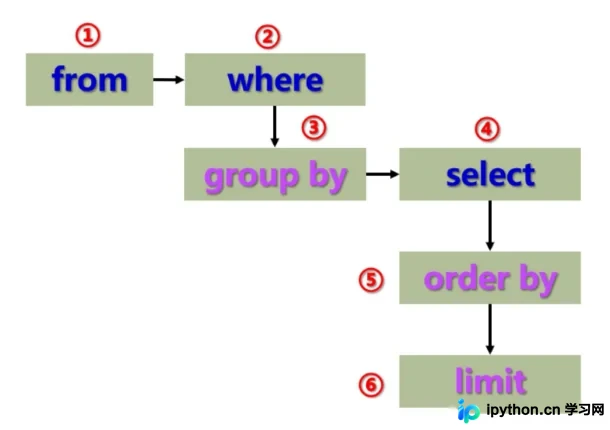
本文详解MySQL中聚合查询(COUNT/SUM/AVG/MAX/MIN)与分组过滤(GROUP BY/HAVING)的操作逻辑。同时深入解析多表联合查询,涵盖内连接、左/右外连接、自连接及子查询技巧,并通过UNION合并结果集。提供清晰执行顺序与代码示例,帮助开发者高效处理复杂数据查询。
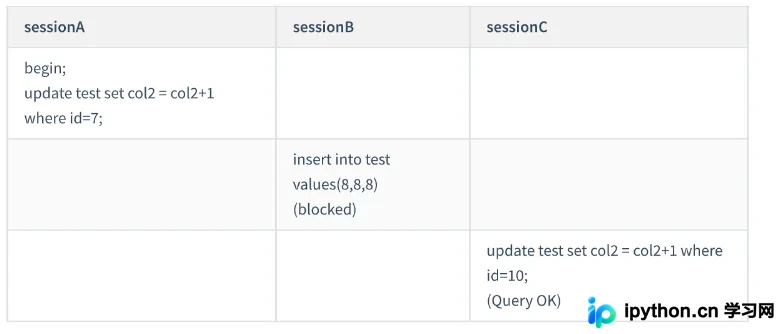
本文详解MySQL InnoDB在可重复读(RR)隔离级别下的间隙锁(Gap Lock)与Next-Key Lock加锁机制。通过两个核心原则、两个优化规则和一处潜在Bug,结合11个实际SQL执行案例,分析等值查询、范围查询、非唯一索引及ORDER BY操作下的具体锁范围,帮助开发者优先规避死锁并提升并发性能。
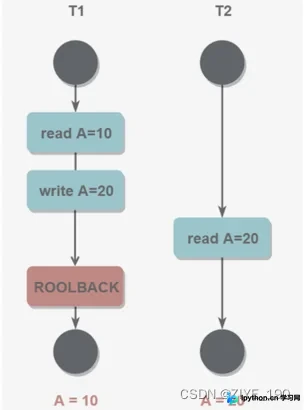
本文深入解析MySQL数据库的事务机制,详细阐述ACID四大属性(原子性、一致性、隔离性、持久性)的实际意义。对比分析读未提交、读已提交、可重复读及串行化四种隔离级别,明确其在处理脏读、不可重复读和幻读等并发问题时的表现,帮助开发者根据业务需求选择最佳配置。
本文详解MySQL多表关联查询的核心概念。首先通过第一至第三范式理解数据库设计的原子性、依赖性与冗余消除,随后讲解主外键关系及强/弱引用差异。重点演示INNER JOIN(含自连接)与LEFT/RIGHT OUTER JOIN的语法结构、执行逻辑及数据去重表现,助您掌握高效的多表数据处理技巧。
本文深入解析MySQL触发器(Trigger)的概念、优缺点及基本语法。通过“下单自动减库存”的实际案例,演示如何创建、查看和管理触发器。重点讲解如何利用NEW和OLD关键字获取数据状态,并提供一种基于SQL异常中断的防超卖优化方案,帮助开发者实现数据层面的自动化校验与联动操作。



