


MySQL聚合查询与多表连接操作详解

掌握MySQL聚合查询(如COUNT、SUM)与分组过滤(GROUP BY配合HAVING),并理解多表联合查询的执行逻辑是数据处理的基础。本文将详细说明聚合函数的使用场景、分组后的条件筛选方法,以及内连接、外连接和子查询的语法规范,最后介绍如何使用UNION合并查询结果。
一、聚合查询:行级计算与分组统计
聚合查询主要用于对表格中的数据进行统计运算,常见函数包括统计行数、求和、平均值、最大值和最小值。在使用这些函数时,通常针对数值型字段进行计算,非数值字段进行求和或平均无实际意义。
第1步:常用聚合函数应用
以下是基础聚合函数的典型应用场景:
COUNT(*):统计表中的总行数,包括NULL值记录。COUNT(列名):统计指定列中非NULL值的行数。SUM(列名):计算指定列数值的总和,常用于财务或成绩统计。AVG(列名):计算数值类型的平均值。MAX(列名)/MIN(列名):找出数值的最大值或最小值。
-- 统计学生表总行数
SELECT COUNT(*) FROM student;
-- 统计数学成绩总分(仅针对及格以上数据)
SELECT SUM(math) FROM student WHERE math > 60;
-- 计算平均总分
SELECT AVG(math + chinese + english) FROM student;
-- 获取数学最高分
SELECT MAX(math) FROM student;
第2步:使用 GROUP BY 进行分组
当需要按特定维度(如部门、角色、班级)进行分类统计时,使用GROUP BY子句。核心规则是:SELECT列表中出现的非聚合字段,必须包含在GROUP BY子句中。其他想要展示的统计数据,必须包裹在聚合函数内。
-- 查询每个角色的最高工资、最低工资和平均工资
SELECT role, MAX(salary), MIN(salary), AVG(salary)
FROM emp
GROUP BY role;
第3步:使用 HAVING 进行分组后过滤
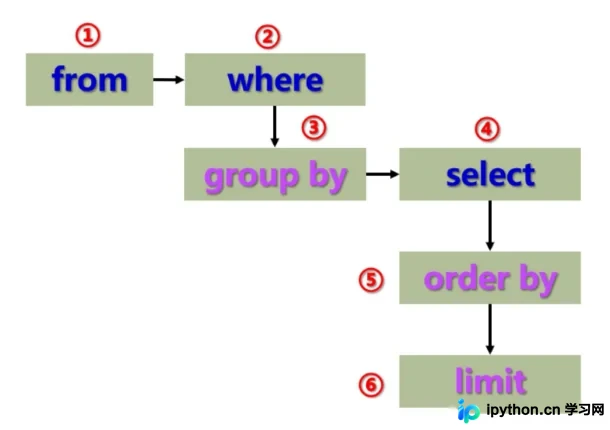
分组完成后,若需对统计结果进行筛选,不能使用WHERE,而应使用HAVING。WHERE用于分组前过滤原始数据,HAVING用于分组后过滤聚合结果。两者结合使用时,执行顺序为先WHERE后HAVING。
以下图片展示了SQL语句的逻辑执行顺序,有助于理解各子句的作用阶段:
-- 显示平均工资低于1500的角色及其平均工资
SELECT role, AVG(salary)
FROM emp
GROUP BY role
HAVING AVG(salary) < 1500;
二、联合查询:多表数据关联
多表查询本质上是基于多个表的数据构建笛卡尔积,随后通过连接条件筛选有效数据。相比旧式的逗号分隔多表查询,现代SQL推荐使用显式的JOIN语法以提高可读性和维护性。
第1步:内连接(INNER JOIN)
内连接返回两个表中匹配的行。如果某个表中的数据在另一个表中没有对应匹配项,则该行不会出现在结果集中。这是最常用的连接方式。
-- 查询“张三”同学的成绩(使用 INNER JOIN)
SELECT sco.score
FROM student AS stu
INNER JOIN score AS sco ON stu.id = sco.student_id
AND stu.name = '张三';
第2步:外连接(LEFT/RIGHT JOIN)
外连接保留了主表的完整数据。左连接(LEFT JOIN)保证左侧表的所有记录都显示,右侧表若无匹配则填NULL;右连接反之。适用于查看未产生关联的主记录。
-- 左外连接:保留表1所有记录
SELECT 字段名 FROM 表名1 LEFT JOIN 表名2 ON 连接条件;
-- 右外连接:保留表2所有记录
SELECT 字段名 FROM 表名1 RIGHT JOIN 表名2 ON 连接条件;
第3步:自连接(Self Join)
自连接指同一张表与其自身进行连接,通常用于比较同一实体在不同条件下的状态,例如比较同一学生不同科目的成绩。
-- 查找数学成绩比语文成绩高的学生信息
-- 假设数学course_id=1,语文course_id=2
SELECT s1.*
FROM score s1, score s2
WHERE s1.student_id = s2.student_id
  AND s1.score > s2.score
  AND s1.course_id = 1
  AND s2.course_id = 2;
第4步:子查询(Subquery)
子查询是将一个SELECT语句嵌入到另一个SQL语句中。根据返回值数量可分为单行和多行子查询。
1. IN 与 EXISTS 的选择
- IN:将子查询结果放入内存进行比较。适合子查询结果集较小的情况,执行效率较高。
- EXISTS:不生成临时结果集,而是通过循环逐行判断是否存在匹配。若主查询数据量大且子查询有索引,
EXISTS可能更高效,但需注意其执行计划依赖于数据库优化器,且可读性稍弱。
-- 查询选修了“语文”或“英文”课程的成绩
SELECT * FROM score
WHERE course_id IN (SELECT id FROM course WHERE name IN ('语文', '英文'));

-- 使用 EXISTS 实现相同逻辑
SELECT * FROM score sco
WHERE EXISTS (
    SELECT 1 FROM course cou
    WHERE cou.id = sco.course_id
    AND cou.name IN ('语文', '英文')
);
三、合并查询结果集
当需要将两个结构相同(列数和数据类型一致)的查询结果垂直合并时,可使用集合操作符。主要区别在于是否去除重复记录。
第1步:使用 UNION
UNION会自动去除结果集中的重复行。如果业务明确知道两条数据源不可能重复,可以使用UNION ALL以获得更好的性能,因为它跳过去重步骤。
-- 合并ID小于3的课程和名为“英文”的课程,自动去重
SELECT * FROM course WHERE id < 3
UNION
SELECT * FROM course WHERE name = '英文';
-- 合并结果并保留重复行
SELECT * FROM course WHERE id < 3
UNION ALL
SELECT * FROM course WHERE name = '英文';本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















