Python查看数据类型与格式
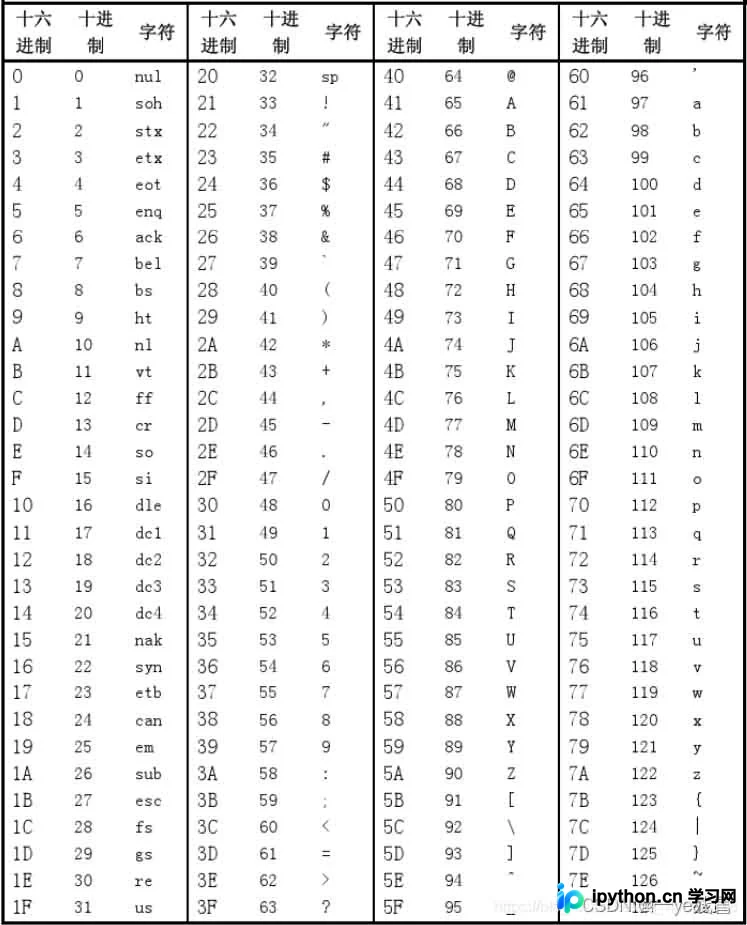
本文介绍Python中查看数据类型的常用方法,涵盖Numpy数组与Pandas数据框的类型判断。重点解析bytes、bytearray与string的区别,演示数字、ASCII及汉字在bytes类型下的创建、转换、切片与迭代操作,帮助开发者准确处理二进制数据。
2026-10-16
0



本文介绍Python中查看数据类型的常用方法,涵盖Numpy数组与Pandas数据框的类型判断。重点解析bytes、bytearray与string的区别,演示数字、ASCII及汉字在bytes类型下的创建、转换、切片与迭代操作,帮助开发者准确处理二进制数据。
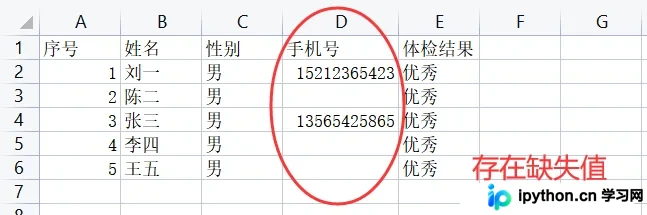
本文介绍如何使用Python的pandas库将宽表转换为窄表。通过pd.melt函数重塑数据结构,并结合dropna处理空值,最终导出为Excel文件。该方法简化了数据分析流程,提升了办公效率。
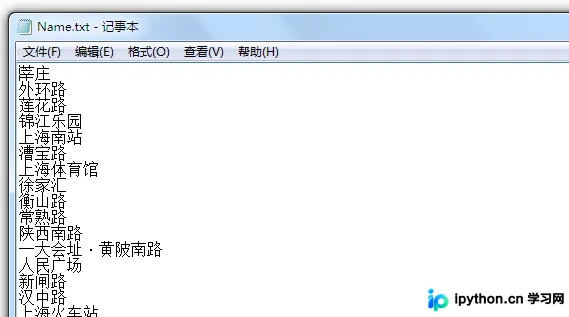
本文介绍如何利用C++语言处理文本数据,统计地铁站点名称中各汉字的出现频率。通过读取包含站名的文件,首先对数据进行去重处理,随后逐字遍历并记录字符次数,最后根据频次进行降序排序输出。该方法展示了基础的文件I/O、字符串操作及数组管理技巧。
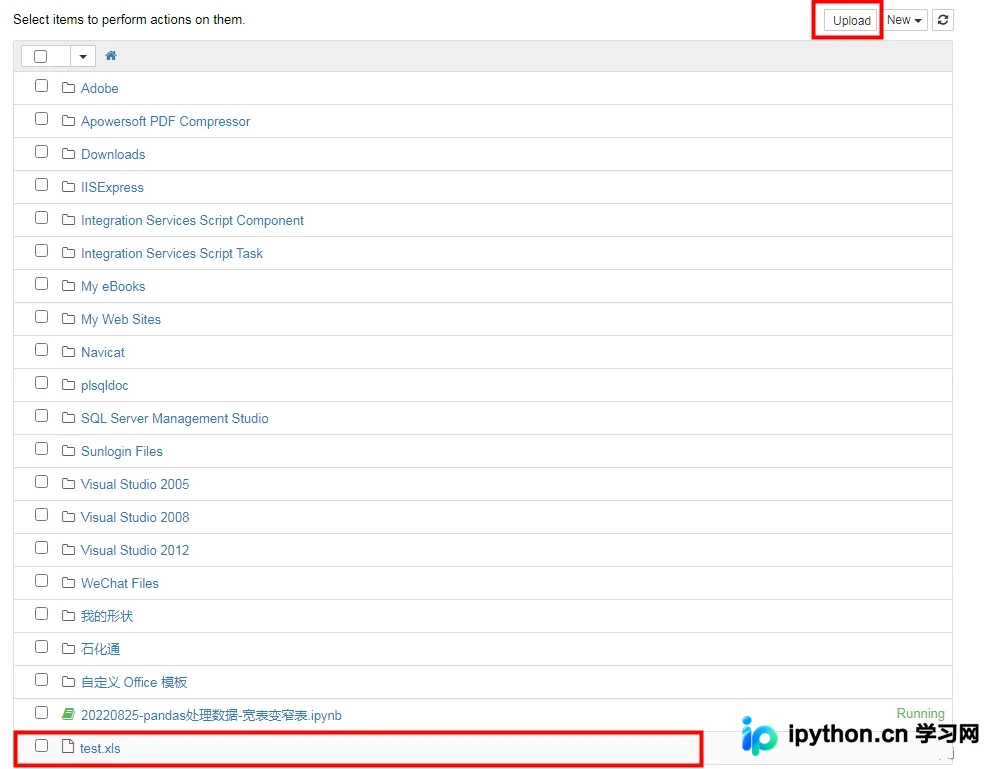
本文介绍如何使用Python的Pandas库读取和写入.xlsx格式文件。通过示例演示了如何指定Sheet名、表头及读取特定列,并展示了如何修改Excel数据后保存为新文件,确保原始数据不受影响。
本文详细介绍如何使用Python pandas库中的read_json函数将JSON文件或字符串转换为数据框。文章通过具体示例演示了records、index、columns、values及split五种orient格式的参数配置与输出结果,并补充了compression压缩加载与encoding编码设置方法,帮助开发者高效处理结构化JSON数据。
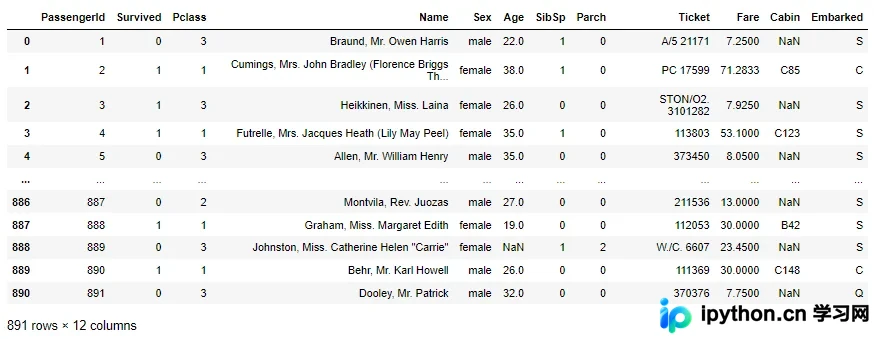
本文深入解析Pandas库中的query()方法,通过Titanic数据集演示如何替代传统的方括号索引进行更简洁的数据筛选。涵盖字符串匹配、变量引用、多条件组合、缺失值处理、索引查询及列间比较等核心用法,帮助开发者提升数据处理效率。
本文深入解析Python处理大型数据集的性能优化方案。通过对比串行处理、多进程池(multiprocessing)、joblib并行处理及批处理技术,展示如何显著缩短280万行数据的清洗耗时。重点介绍利用tqdm实现可视化进度监控,并提供从基础到高级的并行处理代码示例与性能数据对比。
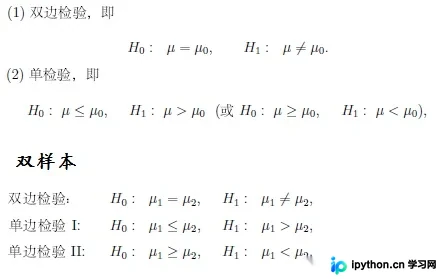
本文系统梳理R语言中常用的数据检验方法,包括正态性检验(W检验、K检验)、相关性检验(Pearson、Spearman)、均值与方差的t检验,以及卡方、Fisher和Wilcoxon等非参数检验。提供各检验的适用场景、R函数调用方式及P值解读,帮助读者快速掌握数据分析中的核心检验逻辑。
本文深入解析Python中的索引与切片机制,涵盖列表、NumPy多维数组及Pandas Series/DataFrame的访问方式。重点剖析一维至N维数组的切片规则、区间差异(闭区间与左闭右开),以及Pandas中ix弃用与iloc/loc的正确用法,结合工程实战中的常见错误与混合数据结构风险,提供完整的避坑指南。
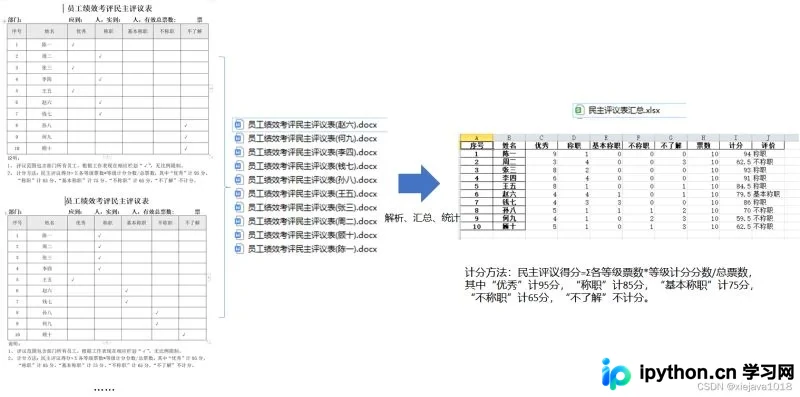
本文介绍利用Python自动化处理年度民主评议表的完整方案。通过docx解析Word文档中的评价表格,使用pandas进行数据汇总与加权计分,最终将结果写入Excel文件。代码不足80行,涵盖从安装依赖、读取目录、解析表格、计算评分到导出文件的全流程,适用于批量处理员工评价数据。
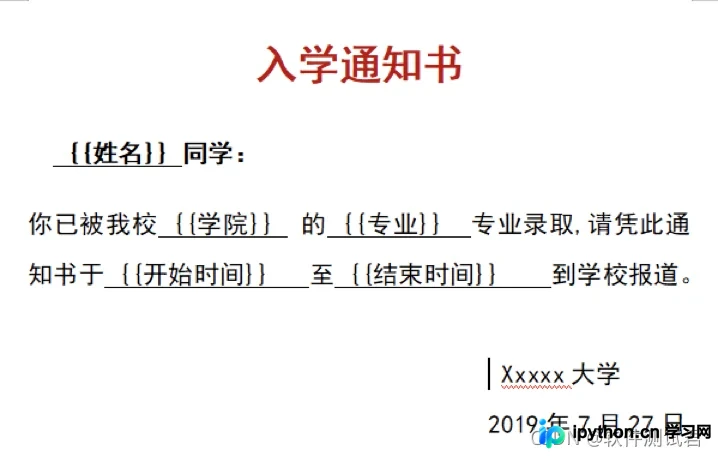
本文介绍如何使用Python的docxtpl和pandas库,通过预设Word模板批量生成包含特定数据的文档。文章详细讲解了环境配置、库安装、CSV数据读取、模板渲染及文件保存的完整流程,并提供了常见错误(如乱码、权限问题)的解决方案,适用于需要处理大量重复性文档生成的场景。
本文详细介绍pandas库中DataFrame.set_index方法的具体使用。涵盖key、drop、append、inplace及verify_integrity等核心参数的含义与配置,通过实例演示如何指定单列或多列作为索引,以及如何构建多级索引和原地修改数据框,帮助开发者高效处理数据索引。



