Python自动化处理PDF:合并、拆分、加密与水印添加实战
本文详解利用Python进行PDF文件自动化处理的方法。通过PyPDF2库实现PDF文件的批量合并与按页拆分,结合加密功能保护文档安全。此外,介绍使用ReportLab生成水印文件并批量添加至PDF的技术细节,提供完整代码示例与效果展示,适用于办公自动化场景。
2026-10-16
0



本文详解利用Python进行PDF文件自动化处理的方法。通过PyPDF2库实现PDF文件的批量合并与按页拆分,结合加密功能保护文档安全。此外,介绍使用ReportLab生成水印文件并批量添加至PDF的技术细节,提供完整代码示例与效果展示,适用于办公自动化场景。
本文详解Python中python-dotenv库的使用,介绍如何通过.env文件安全隔离数据库密码等敏感配置,避免硬编码风险。重点解析load_dotenv函数的override参数及路径指定方法,结合Flask官方推荐实践,帮助开发者实现代码与配置的分离管理。
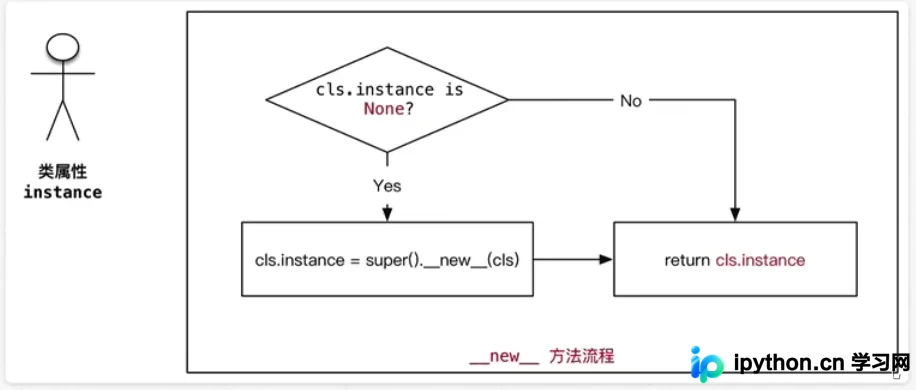
本文详细介绍 Python 中单例模式的两种核心实现方式。首先通过重写 __new__ 方法确保类仅创建唯一实例,解决对象引用问题;随后针对初始化方法重复调用的痛点,引入类属性标记机制,实现初始化逻辑仅执行一次。文章包含完整代码示例,帮助开发者掌握高效、安全的单例模式编写技巧。
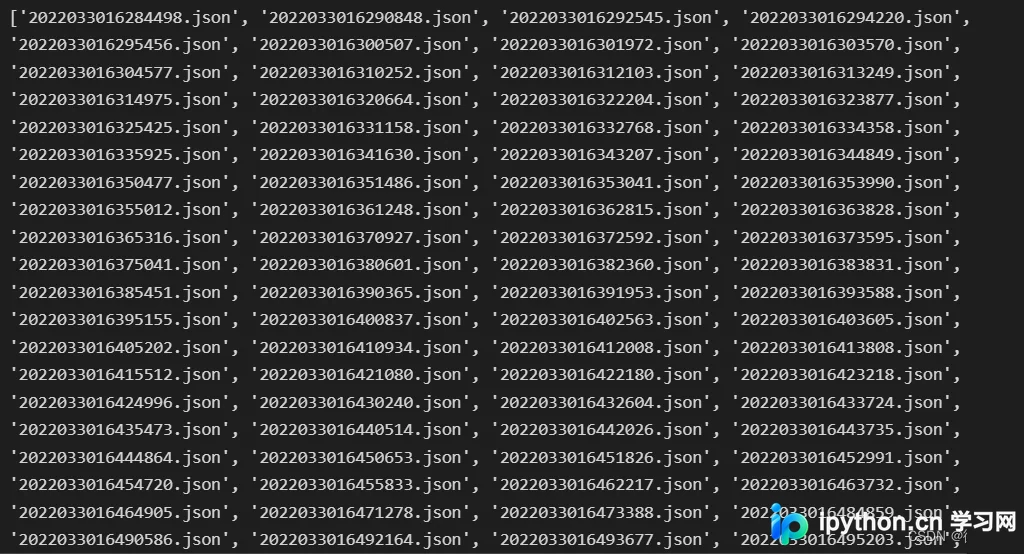
本文介绍如何使用 Python 和 OpenCV 库,从 LabelMe 等工具生成的 JSON 标注文件中提取矩形坐标,并将其绘制回原始图像。通过遍历文件夹获取文件列表,解析 JSON 中的 shapes 节点获取左上角和右下角坐标,利用 cv2.rectangle 函数在图像上画出对应边框,最终保存处理后的图像。
本文解析Python爬虫中因服务器使用Brotli压缩导致的中文乱码问题。详细说明了如何识别Accept-Encoding头中的br格式,通过手动导入brotli库或使用httpx自动处理来正确解码数据,并提供了修改请求头以禁用br压缩的替代方案。
本文详细解析Python中正则表达式模块re的group()方法。通过实例说明如何利用括号进行分组匹配,解释group()、group(0)与group(n)的区别。重点分析匹配失败返回None导致的AttributeError,以及未定义分组引发的IndexError,帮助开发者避免常见编码错误。
本文介绍Python3中常见的GBK编码错误,提供忽略非法字符的URL处理方案,以及将GBK数据转换为十六进制文本存储再还原的方法,确保数据完整性。
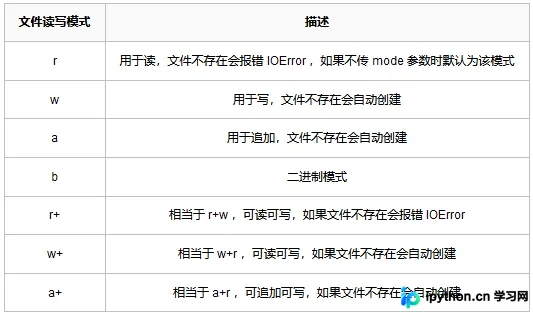
本文详细介绍Python中文件操作的核心方法。涵盖open函数的基本用法及常见读写模式(r, w, a等)和二进制模式;讲解read、readline、readlines的区别;演示覆盖写入与追加写入的代码实现;分析未关闭文件导致的读取问题;最后通过try...finally和with语句优化代码,确保文件资源安全释放。
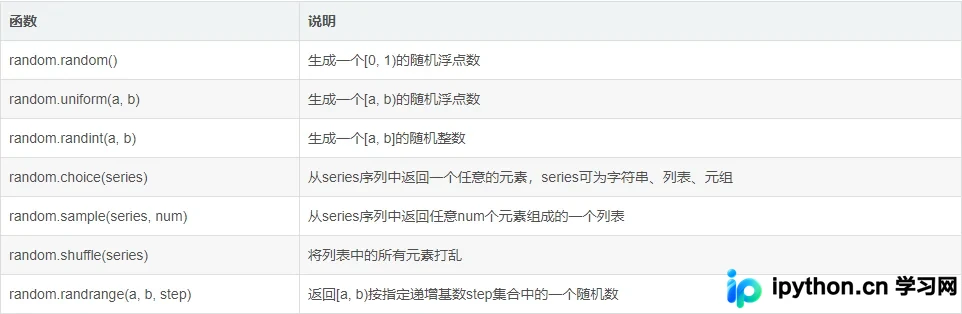
本文详细介绍Python中生成随机数字和字符的两种主要方式。首先解析内置random库,涵盖random.randint、choice及sample等函数的具体用法与代码示例。其次介绍Faker库的安装与配置,演示如何生成姓名、地址、身份证等多样化伪数据。通过对比两种方案,帮助开发者根据实际需求选择合适的数据生成工具。
本文介绍在Python中处理数字格式的两个常见问题:去除小数点后多余的0以及文件编号中的前导0。通过Decimal类的normalize()和to_integral()方法,结合自定义函数实现兼容处理,同时利用字符串格式化去除前导0,提供实用的代码示例。
本文详细解析Python中模块的三种主要分类:系统内置模块、开源第三方模块以及自定义模块。通过介绍os、requests、django等常见库的功能,帮助开发者理解如何有效引用和管理不同来源的代码模块,同时强调自定义模块命名需避免与内置模块冲突的注意事项。
本文详细介绍如何使用Python及Pandas库从日期数据中提取30余种常用信息。涵盖年月日时分秒、星期、周次、季度、闰年判断、时间间隔计算及字符串时段转换等核心功能,通过具体代码示例展示read_excel、dt模块、apply、lambda及getattr等方法的实际应用,助力数据竞赛与日常开发。