Python 2 中文编码处理与文件读写详解
本文详细解析 Python 2 中处理中文编码的常见陷阱与解决方案。涵盖如何正确设置文件编码声明、理解 str 与 unicode 的区别,以及在 Windows 环境下处理 ANSI 和 UTF-8 文件时的编码转换技巧。重点讲解了 BOM 头处理、print 输出机制及跨平台编码兼容性问题,帮助开发者避免中文乱码错误。
10-16
5




本文详细解析 Python 2 中处理中文编码的常见陷阱与解决方案。涵盖如何正确设置文件编码声明、理解 str 与 unicode 的区别,以及在 Windows 环境下处理 ANSI 和 UTF-8 文件时的编码转换技巧。重点讲解了 BOM 头处理、print 输出机制及跨平台编码兼容性问题,帮助开发者避免中文乱码错误。
本文介绍Python3中常见的GBK编码错误,提供忽略非法字符的URL处理方案,以及将GBK数据转换为十六进制文本存储再还原的方法,确保数据完整性。
本文详解Python中文件的创建与写入操作。重点解析open()函数的参数与返回值,深入对比w、w+、a、ab等写入模式的区别与适用场景。针对Windows系统中文编码问题提供解决方案,并通过自动创建包及自定义换行类两个实战案例,展示文件操作的高级应用技巧。
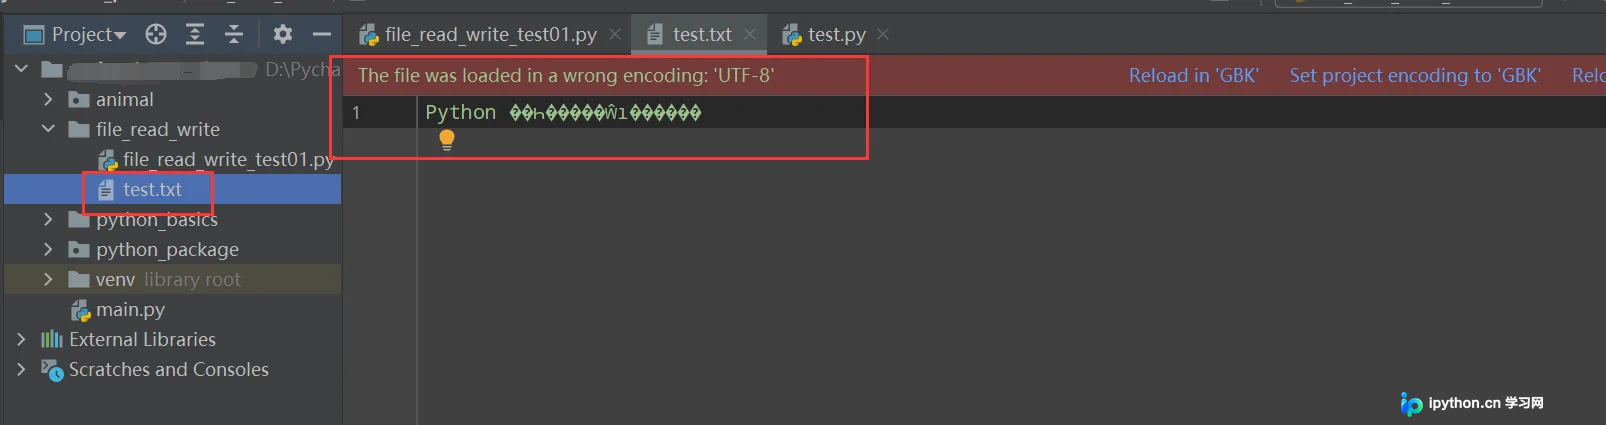
在C#中,若需按字节长度(如中文占2字节)对字符串进行等宽截取或分页,可使用Encoding.Default.GetByteCount统计字节。本文提供基于ArrayList实现的GetSeparateSubString函数示例,该函数遍历字符并按指定字符数阈值累加字节,实现精确截断。适用于GB2312/GBK等双字节编码环境下的固定宽度显示处理。
本文介绍 Python 中 os.listdir() 函数在处理包含中文文件或文件夹的路径时可能出现的乱码问题。重点解析 Python 2 与 Python 3 在编码处理上的差异,指出 Python 3 默认 UTF-8 编码无需额外转码,而 Python 2 需使用 unicode() 进行转换,并提供具体代码示例与注意事项。
本文介绍了Python中解压ZIP文件时常见的中文乱码问题及其解决方法。由于ZipFile模块在处理中文文件名时可能遇到编码问题,导致解压后的文件名显示异常。文章提供了三种解决方案,包括创建文件名映射表、修改源码解码格式以及手动处理文件写入和文件夹创建。推荐采用手动处理的方式,以确保文件名正确显示。
在使用Python lxml库解析HTML数据时,常因网页编码与程序解码不一致导致中文显示为乱码。本文介绍通过XPath定位节点后,利用encode('ISO-8859-1').decode('UTF-8')方法进行编码转换的技巧,有效解决数据抓取中的字符显示异常问题。
PHP无法正确解析带BOM头的UTF-8文件,会导致页面输出空白或中文乱码。本文提供一段可批量扫描并自动移除目录下所有文件BOM头的PHP脚本,同时介绍EditPlus和UltraEdit等常用编辑器的免BOM保存设置,快速解决因Windows记事本存储引起的编码兼容问题。
本文介绍Python中处理16进制字符串与中文互转的方法。针对Python 2中u'\xe6\x97\xa0\xe5\x90\x8d'类型编码问题,通过encode('raw_unicode_escape')解决。同时演示如何将包含16进制字符的UTF-8字符串解码为中文,以及将中文字符串转换为16进制表示。
本文深入解析Python中字符串编码转换机制,重点探讨UnicodeEncodeError错误的成因。通过对比encode与decode的作用,分析不同编码文件(如utf-8与gb2312)对字符串默认编码的影响,并提供判断字符串类型及处理系统默认编码的实用代码示例,帮助开发者彻底解决Python中的乱码与编码报错问题。
本文针对Python3爬虫中常见的编码错误,深入解析Unicode与bytes的转换机制。详细说明了字符串encode与bytes decode的区别,以及在不同文件写入模式('w'与'wb')下如何正确处理编码参数。通过网页抓取实例,展示了如何避免TypeError和UnicodeEncodeError,确保数据正确存储。
本文介绍如何使用Python将TXT文件内容逐行读取并转换为字典对象。通过按空格分割行数据,利用冒号提取键值对,最终生成包含多个字典的列表。代码特别处理了中文字符的编码问题,确保写入新文件时数据格式正确,适合需要批量处理结构化文本数据的场景。



