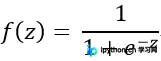Python模块分类详解:内置、第三方与自定义
本文详细解析Python中模块的三种主要分类:系统内置模块、开源第三方模块以及自定义模块。通过介绍os、requests、django等常见库的功能,帮助开发者理解如何有效引用和管理不同来源的代码模块,同时强调自定义模块命名需避免与内置模块冲突的注意事项。
2026-10-16
0



本文详细解析Python中模块的三种主要分类:系统内置模块、开源第三方模块以及自定义模块。通过介绍os、requests、django等常见库的功能,帮助开发者理解如何有效引用和管理不同来源的代码模块,同时强调自定义模块命名需避免与内置模块冲突的注意事项。
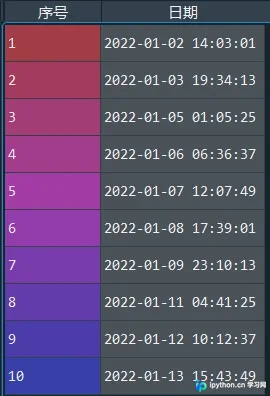
本文详细介绍如何使用Python及Pandas库从日期数据中提取30余种常用信息。涵盖年月日时分秒、星期、周次、季度、闰年判断、时间间隔计算及字符串时段转换等核心功能,通过具体代码示例展示read_excel、dt模块、apply、lambda及getattr等方法的实际应用,助力数据竞赛与日常开发。
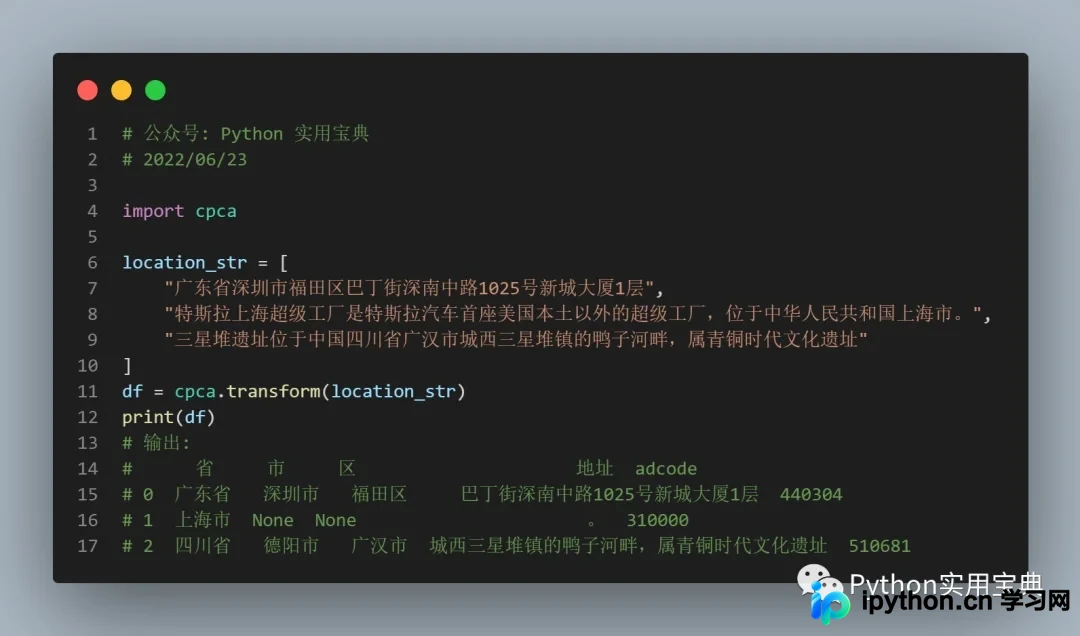
本文介绍Python中Cpca模块的使用方法,该模块可自动从文本中提取省、市、区名称及行政区划代码。通过简单几行代码即可实现批量地址解析,并支持通过pos_sensitive参数获取提取位置。此外,结合folium库还可将提取结果在地图上以热力图形式可视化展示,解决NLP任务中地理位置识别的繁琐问题。
本文对比了Python中去除字符串指定字符的四种常用方法。通过实际案例,详细解析了strip系列方法处理两端空白、切片拼接处理固定位置字符、replace与re.sub处理任意位置字符,以及translate方法高效删除多种不同字符(如Unicode组合符号)的应用场景与代码实现。
本文详细介绍在 Python 3.8 环境中安装 TensorFlow CPU 版本的步骤。通过 Anaconda 创建虚拟环境,利用清华镜像源加速下载,并验证 cp38 兼容性。涵盖环境创建、激活、安装及测试全流程,适用于 TensorFlow 2.3.x 版本的本地部署。
本文详细解析Python pandas库中pd.cut()与pd.qcut()两个数据离散化函数的区别。pd.cut()基于固定区间或数量进行等距划分,而pd.qcut()基于分位数确保各区间样本数量一致。文章通过具体代码示例对比了参数如bins、q、right、include_lowest及duplicates的使用场景,帮助开发者根据数据分布特征选择合适的离散化方法。
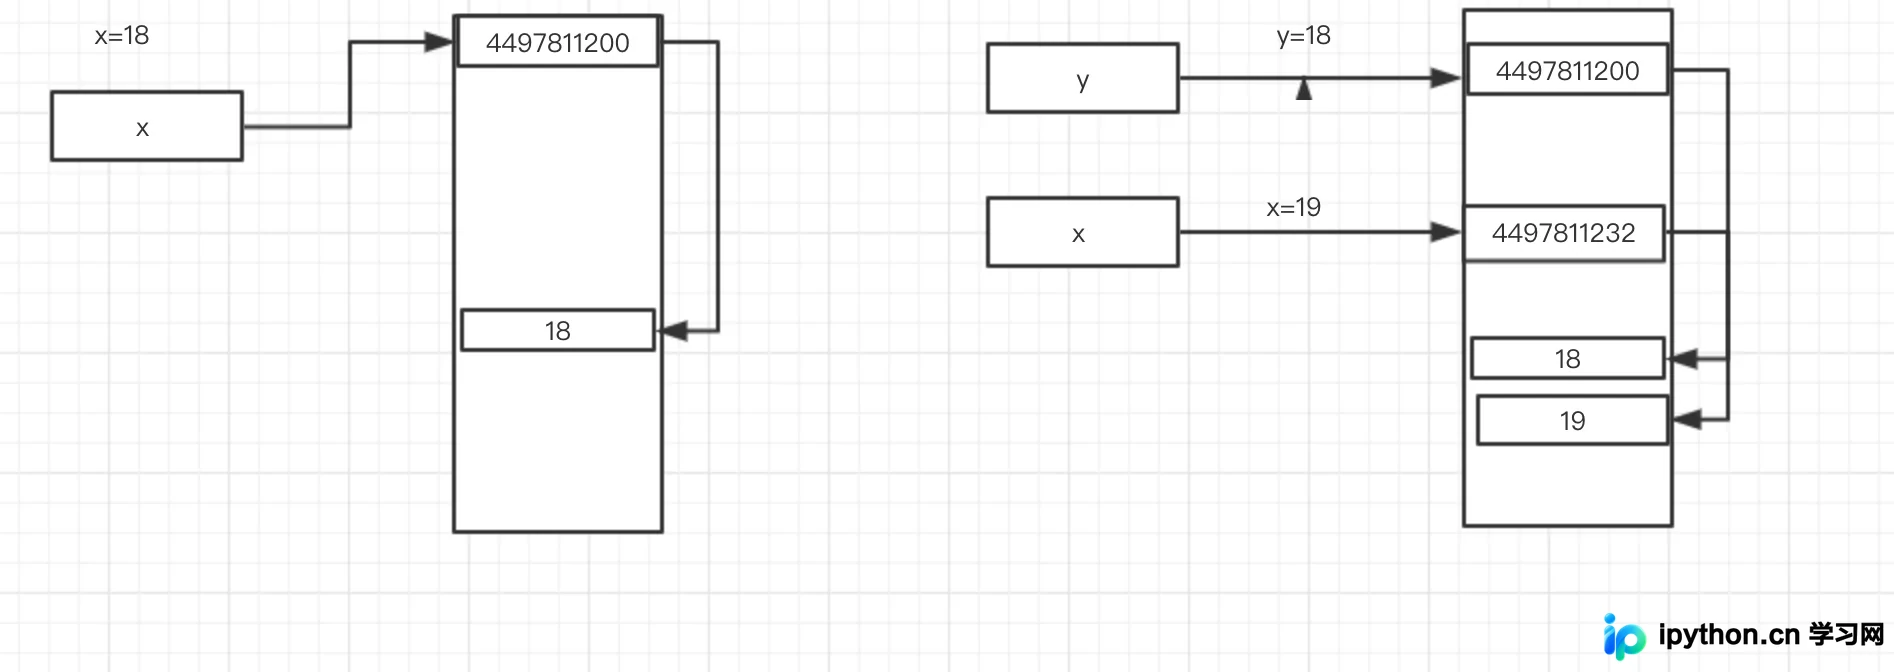
本文深入解析Python中可变与不可变数据类型的核心区别。通过内存地址(id)的变化规律,阐明不可变类型(如int、str、tuple)在赋值时创建新对象,而可变类型(list、dict、set)在原地修改。重点解析元组包含可变元素时的特殊行为,帮助开发者理解引用机制与内存管理。
本文详解Python中JSON与字典的对应关系,涵盖JSON数据的增删改查、键值对操作及文件读写。重点解析如何通过Python脚本实现JSON文件的递归遍历、格式化输出及编码处理,提供核心代码示例与注意事项,帮助测试工程师高效处理JSON数据。
本文详细解析Python中字符串大小写转换的六种常用方法,包括lower()、upper()、capitalize()、title()、swapcase()及casefold()。重点对比lower()与casefold()在处理非ASCII字符时的差异,通过具体代码示例展示各方法的语法与运行结果,帮助开发者根据实际需求选择合适的大小写转换策略。
本文详细介绍在Python中计算1到100累加和的三种实现方式。通过for循环、while循环以及内置函数sum与reduce的组合应用,展示不同场景下的代码写法。内容涵盖基础语法示例及结果输出,帮助初学者理解循环结构与数值计算逻辑。
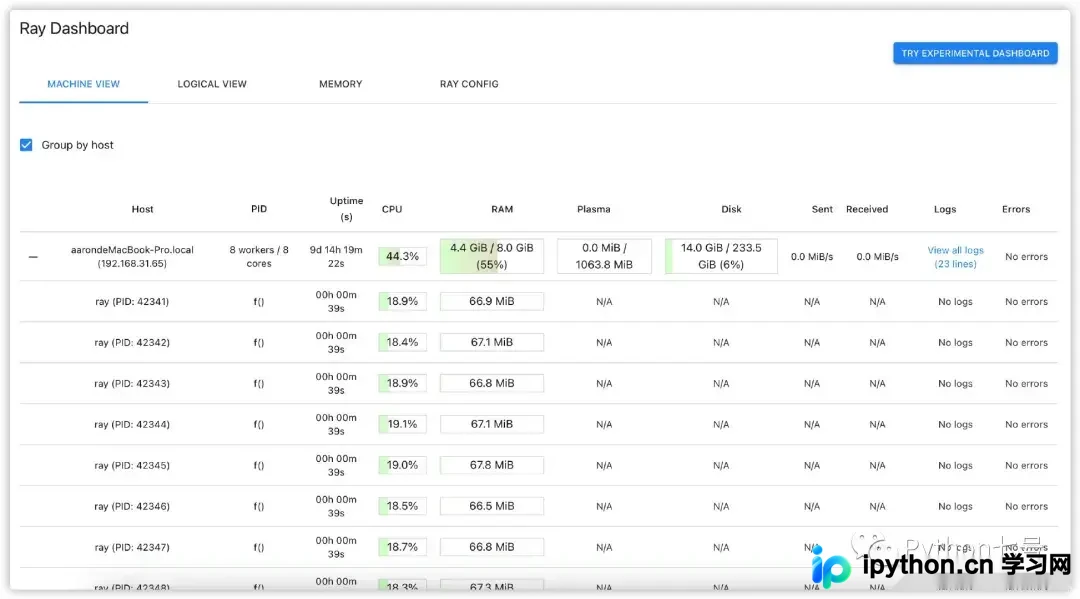
本文详细介绍如何利用Python的Ray框架实现高效分布式计算。内容涵盖Ray的核心特性、安装方法、单机分布式代码示例,以及基于Docker的多节点集群搭建与任务调度实战,帮助开发者快速掌握分布式并行处理技术。
本文详细介绍 TensorFlow 中常用的四种激活函数:Sigmoid、Tanh、ReLU 和 Softplus。分析各自的数学特性、优缺点(如梯度消失、计算速度、零均值等),并提供对应的 TensorFlow API 调用示例,帮助开发者根据模型需求选择合适的非线性激活方式。