


Python使用Cpca模块提取省市区并绘制热力图

本文介绍Python中Cpca模块的使用方法,该模块可自动从文本中提取省、市、区名称及行政区划代码。通过简单几行代码即可实现批量地址解析,并支持通过pos_sensitive参数获取提取位置。此外,结合folium库还可将提取结果在地图上以热力图形式可视化展示,解决NLP任务中地理位置识别的繁琐问题。
在进行自然语言处理(NLP)任务时,经常需要从文本中识别并提取省、市、区等地理信息。尽管可以通过构建关键词表进行手动匹配,但这种方法需要预先搜集大量数据,流程相对繁琐。
这里推荐一个名为Cpca的Python模块。只需将字符串传入该模块,即可自动返回其中包含的省、市、区关键词,并支持在地图上进行标注展示。
1.环境准备
在开始之前,请确保您的电脑已正确安装Python和pip。若未安装,可参考相关Python安装指南进行配置。
(可选1) 若您的主要用途是数据分析,建议直接安装Anaconda,其已内置Python和pip环境。
(可选2) 推荐使用VSCode编辑器,因其具备诸多开发优势。
请选择以下任意一种方式输入命令以安装依赖库:
1. Windows系统:打开命令提示符(Cmd),可通过“开始-运行-CMD”路径进入。
2. MacOS系统:打开终端(Terminal),可通过command+空格搜索Terminal打开。
3. 若使用VSCode或PyCharm编辑器,可直接点击界面下方的Terminal标签页。
pip install cpca请注意,目前cpca模块仅支持Python 3及以上版本。
在Windows环境下安装时,可能会遇到如下报错信息:
Building wheel for pyahocorasick (setup.py) ... error解决方法是前往官网下载Microsoft Visual C++ Build Tools并安装VC++构建工具,随后重新执行pip install cpca命令即可解决该问题。
2.基本用法
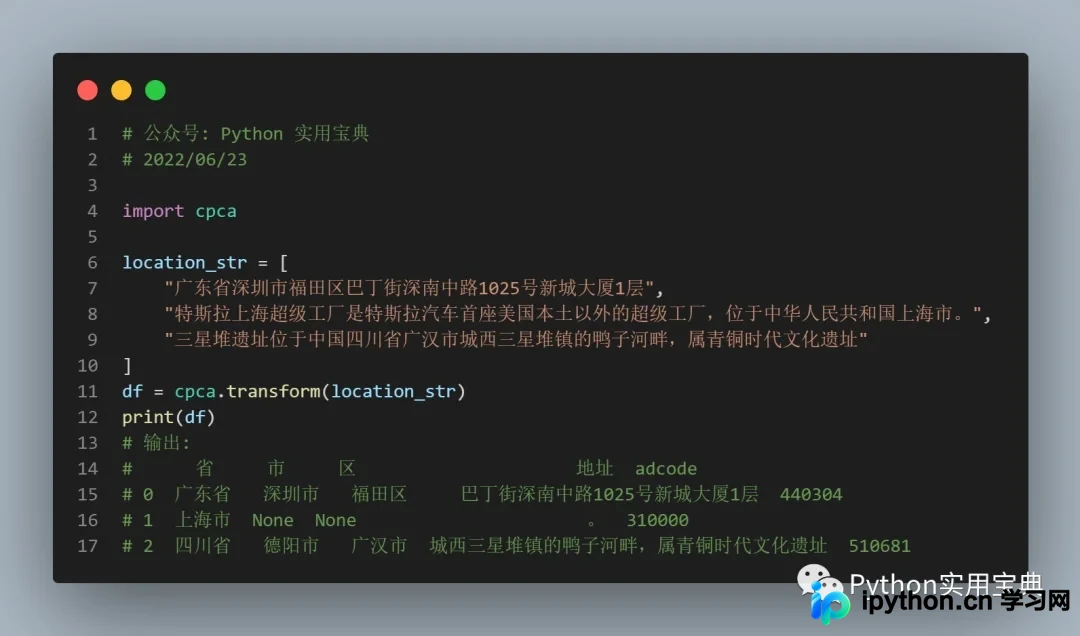
仅需两行代码即可实现基础的省市区提取功能:
# 公众号: Python 实用宝典
# 2022/06/23

import cpca

location_str = [
    "广东省深圳市福田区巴丁街深南中路1025号新城大厦1层",
    "特斯拉上海超级工厂是特斯拉汽车首座美国本土以外的超级工厂,位于中华人民共和国上海市。",
    "三星堆遗址位于中国四川省广汉市城西三星堆镇的鸭子河畔,属青铜时代文化遗址"
]
df = cpca.transform(location_str)
print(df)
运行效果如下所示:
省 市 区 地址 adcode 0 广东省 深圳市 福田区 巴丁街深南中路1025号新城大厦1层 440304 1 上海市 None None 。310000 2 四川省 德阳市 广汉市 城西三星堆镇的鸭子河畔,属青铜时代文化遗址 510681
值得注意的是第三行数据中的广汉市,cpca模块不仅识别出了县级市广汉市,还能自动关联并匹配其代管的德阳市,功能十分强大。
如果您希望了解程序是从字符串的具体哪个位置提取出省市区名称的,可以添加pos_sensitive=True参数:
# 公众号: Python 实用宝典
# 2022/06/23

import cpca

location_str = [
    "广东省深圳市福田区巴丁街深南中路1025号新城大厦1层",
    "特斯拉上海超级工厂是特斯拉汽车首座美国本土以外的超级工厂,位于中华人民共和国上海市。",
    "三星堆遗址位于中国四川省广汉市城西三星堆镇的鸭子河畔,属青铜时代文化遗址"
]
df = cpca.transform(location_str, pos_sensitive=True)
print(df)
运行效果如下:
(base) G:\push\20220623>python 1.py 省 市 区 地址 adcode 省_pos 市_pos 区_pos 0 广东省 深圳市 福田区 巴丁街深南中路1025号新城大厦1层 440304 0 3 6 1 上海市 None None 。310000 38 -1 -1 2 四川省 德阳市 广汉市 城西三星堆镇的鸭子河畔,属青铜时代文化遗址 510681 9 -1 12
该参数标记出了识别到省、市、区的关键索引位置(index)。需要注意的是,对于如德阳市这类特殊识别情况,其位置标记可能会显示为-1。
3.高级应用
该模块还支持从大段文本中批量识别多个地区信息:
# 公众号: Python 实用宝典
# 2022/06/23

import cpca

long_text = "对一个城市的评价总会包含个人的感情。如果你喜欢一个城市,很有可能是喜欢彼时彼地的自己。"\
    "在广州、香港读过书,工作过,在深圳买过房、短暂生活过,去北京出了几次差。"\
    "想重点比较一下广州、深圳和香港,顺带说一下北京。总的来说,觉得广州舒适、"\
    "香港精致、深圳年轻气氛好、北京大气又粗糙。答主目前选择了广州。"
df = cpca.transform_text_with_addrs(long_text, pos_sensitive=True)
print(df)
运行效果如下:
(base) G:\push\20220623>python 1.py 省 市 区 地址 adcode 省_pos 市_pos 区_pos 0 广东省 广州市 None 440100 -1 44 -1 1 香港特别行政区 None None 810000 47 -1 -1 2 广东省 深圳市 None 440300 -1 58 -1 3 北京市 None None 110000 71 -1 -1 4 广东省 广州市 None 440100 -1 86 -1 5 广东省 深圳市 None 440300 -1 89 -1 6 香港特别行政区 None None 810000 92 -1 -1 7 北京市 None None 110000 100 -1 -1 8 广东省 广州市 None 440100 -1 110 -1 9 香港特别行政区 None None 810000 115 -1 -1 10 广东省 深圳市 None 440300 -1 120 -1 11 北京市 None None 110000 128 -1 -1 12 广东省 广州市 None 440100 -1 143 -1
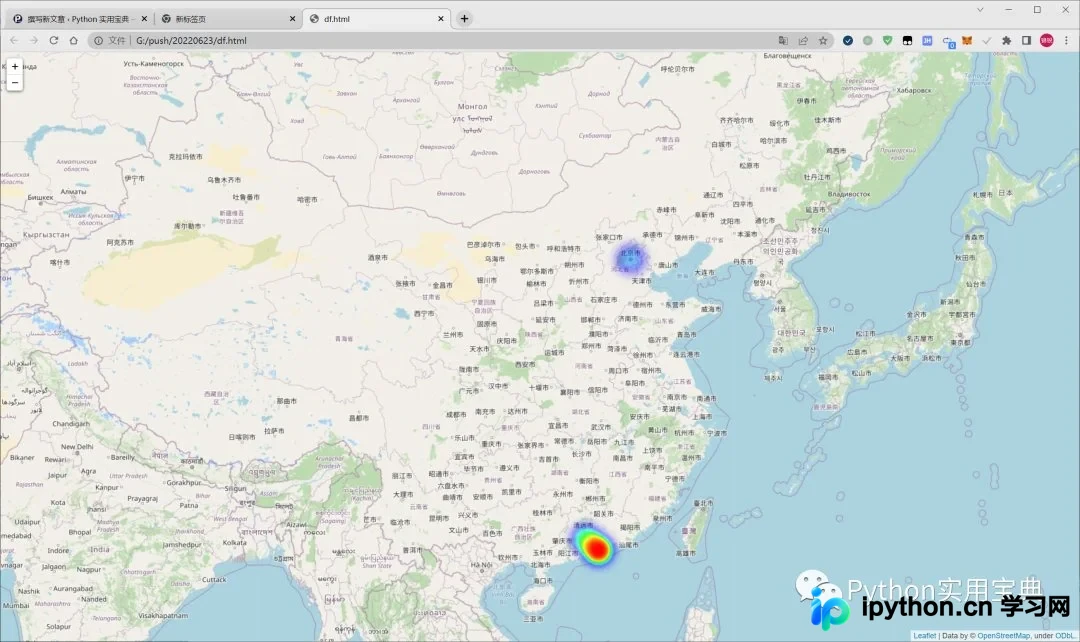
此外,模块内置了简单的绘图工具,可以将上述提取的数据以热力图的形式绘制在地图上:
# 公众号: Python 实用宝典
# 2022/06/23

import cpca
from cpca import drawer

long_text = "对一个城市的评价总会包含个人的感情。如果你喜欢一个城市,很有可能是喜欢彼时彼地的自己。"\
    "在广州、香港读过书,工作过,在深圳买过房、短暂生活过,去北京出了几次差。"\
    "想重点比较一下广州、深圳和香港,顺带说一下北京。总的来说,觉得广州舒适、"\
    "香港精致、深圳年轻气氛好、北京大气又粗糙。答主目前选择了广州。"
df = cpca.transform_text_with_addrs(long_text, pos_sensitive=True)
drawer.draw_locations(df[cpca._ADCODE], "df.html")
运行过程中可能会遇到如下错误提示:
(base) G:\push\20220623>python 1.py Traceback (most recent call last): File "1.py", line 12, in <module> drawer.draw_locations(df[cpca._ADCODE], "df.html") File "G:\Anaconda3\lib\site-packages\cpca\drawer.py", line 41, in draw_locations import folium ModuleNotFoundError: No module named 'folium'
只需使用pip安装该依赖库即可:
pip install folium随后重新运行代码,当前目录下将生成df.html文件。双击打开该文件,即可看到如下效果:
使用方法是否简便?今后在进行地点识别任务时,使用该模块即可满足大部分需求。
更多详细细节请访问该项目的GitHub主页查阅,该项目的README文档完全由中文编写,阅读起来非常轻松:
本文关于Python实现识别文字中的省市区并绘图的介绍到此结束,更多相关Python识别文字中省市区的内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















