Python使用Cpca模块提取省市区并绘制热力图
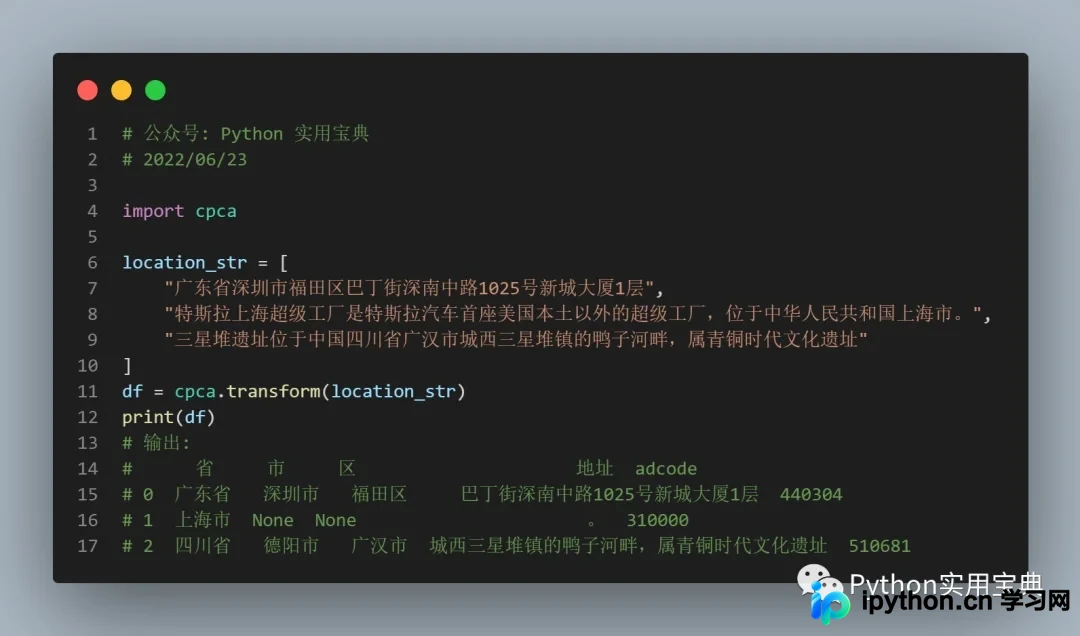
本文介绍Python中Cpca模块的使用方法,该模块可自动从文本中提取省、市、区名称及行政区划代码。通过简单几行代码即可实现批量地址解析,并支持通过pos_sensitive参数获取提取位置。此外,结合folium库还可将提取结果在地图上以热力图形式可视化展示,解决NLP任务中地理位置识别的繁琐问题。
10-16
1




本文介绍Python中Cpca模块的使用方法,该模块可自动从文本中提取省、市、区名称及行政区划代码。通过简单几行代码即可实现批量地址解析,并支持通过pos_sensitive参数获取提取位置。此外,结合folium库还可将提取结果在地图上以热力图形式可视化展示,解决NLP任务中地理位置识别的繁琐问题。
本文介绍如何使用Python的re模块构建一个简单的表达式分词器(Tokenizer)。通过定义命名捕获组的正则表达式模式,利用scanner和match方法将字符串解析为标记流。文章还讲解了如何过滤空格标记,并重点分析了正则表达式匹配顺序对子串匹配的影响,提供了正确的模式排列建议。
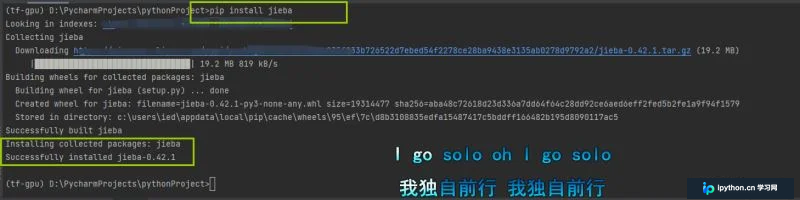
本文详解Python jieba库的中文分词原理,介绍基于词库与动态规划的算法机制。重点解析精确模式、全模式及搜索引擎模式的区别与适用场景,并通过jieba.lcut等常用函数展示代码实操,涵盖安装、自定义新词及不同模式下的分词效果对比。
本文介绍如何使用Python的re模块构建简易分词器。通过定义命名捕获组匹配标识符、运算符和数字,利用scanner和match方法解析字符串。重点讲解模式顺序对子串匹配的影响及过滤空格的技巧,并推荐PyParsing等专业库处理复杂语法。
本文介绍Python中全角与半角字符转换的实现原理及代码。全角字符Unicode范围通常为0xFF01~0xFF5E,半角为0x21~0x7E,空格需单独处理(全角12288,半角32)。通过chr()、ord()函数结合偏移量计算,可高效完成非中文及符号的全半角互换,适用于NLP数据预处理。
本文详细讲解杰卡德距离与环比算法的原理及Python实现。杰卡德距离通过1减去相似系数衡量集合差异,环比则对比报告期与上一时期水平以反映逐期发展速度。文章提供基于jieba分词的杰卡德系数计算代码及环比增长率计算示例,帮助开发者理解并应用这两种统计与NLP常用算法。
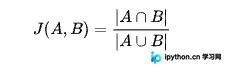
本文介绍如何在Python中利用HanLP库进行简繁体中文转换。通过CharTable类实现基础字符正规化,并深入演示简体、繁体、台湾繁体及香港繁体之间的多向转换方法,涵盖s2tw、tw2s等核心API的使用场景与代码示例。
本文介绍5个常用的Python自然语言处理库,包括NLTK、TextBlob、Spacy、Gensim和CoreNLP。详细讲解标记、词干提取等核心术语,并提供各库的安装命令与基础代码示例,帮助开发者快速上手NLP预处理任务。
本文介绍如何使用Python和SpaCy库,通过预处理标题、生成文本对并计算余弦相似度,递归地过滤掉内容相似的重复文档。该方法适用于归档清理、歌词去重等场景,能有效保留唯一性文档并释放存储空间。
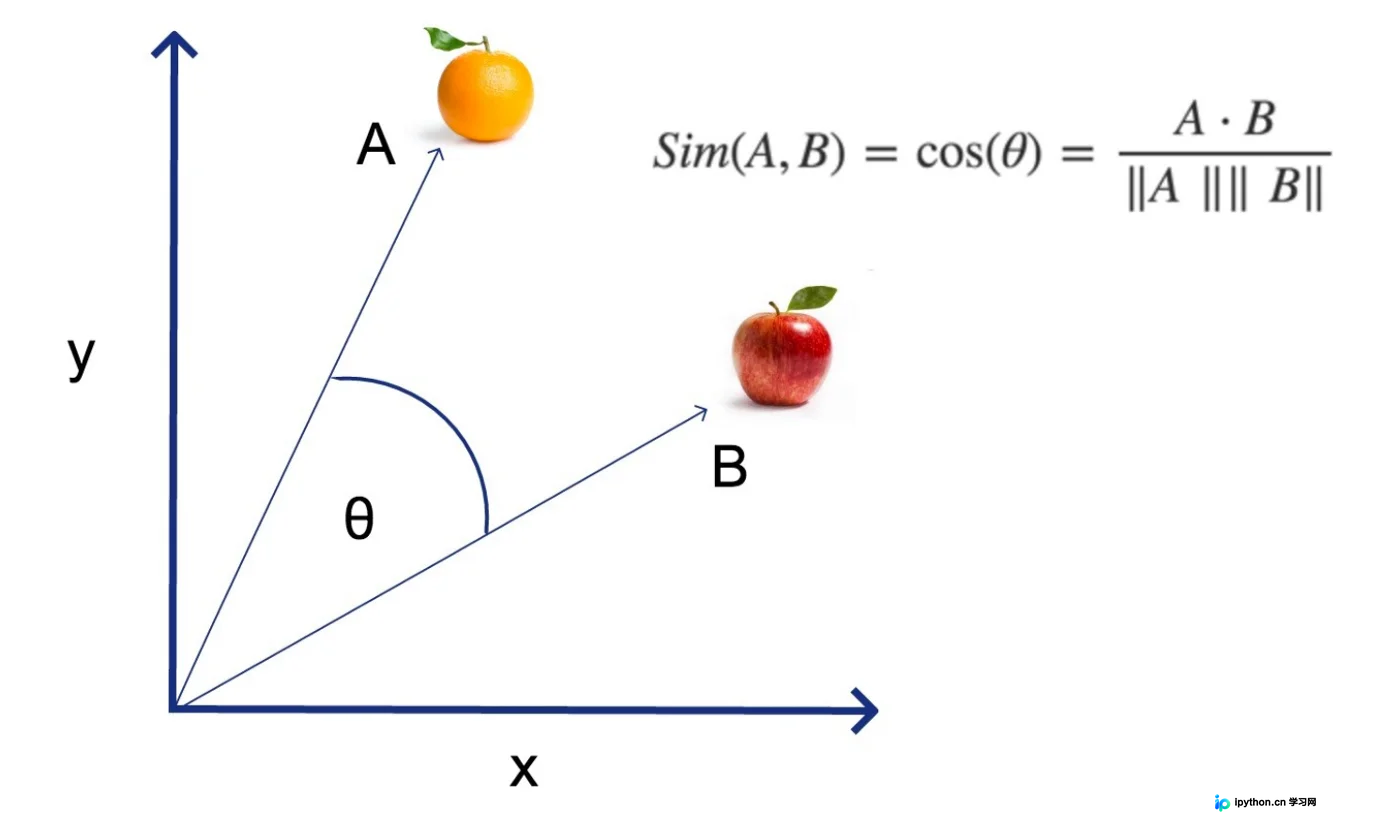
本文详解Python jieba库的三种核心分词模式:精确模式、全模式及搜索引擎模式,并通过代码实例展示jieba.cut()、jieba.lcut()及jieba.cut_for_search()的具体用法与输出差异。此外,文章还介绍了利用jieba.posseg模块进行词性标注及动词提取的实操方法,帮助开发者掌握中文文本处理的关键技术。
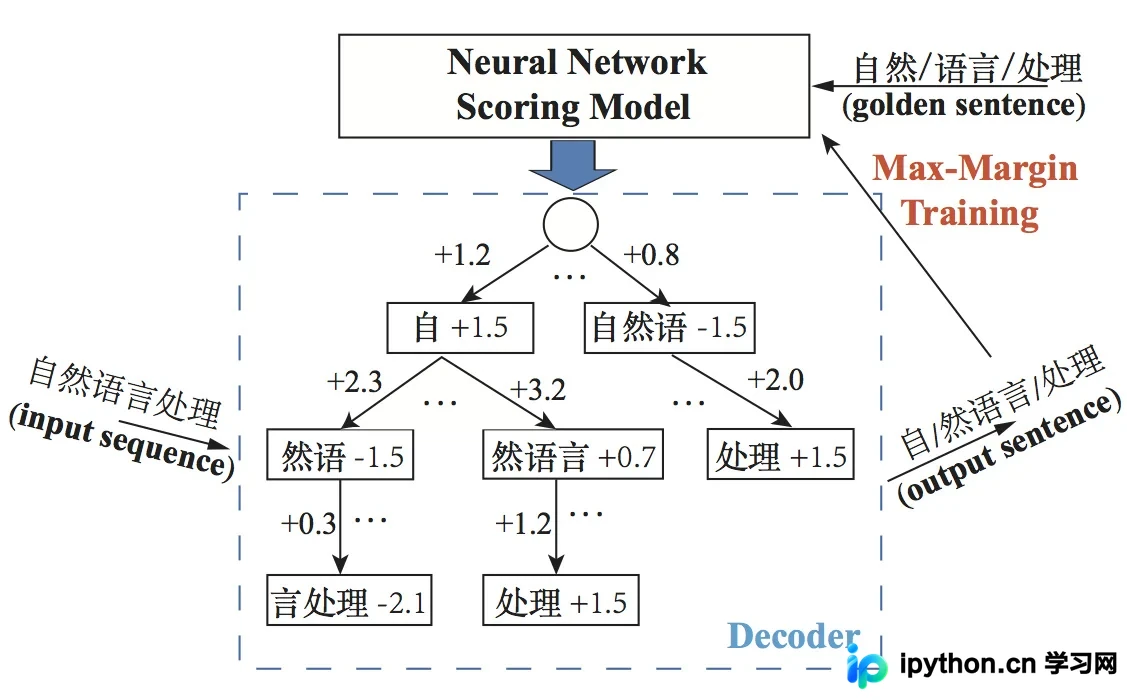
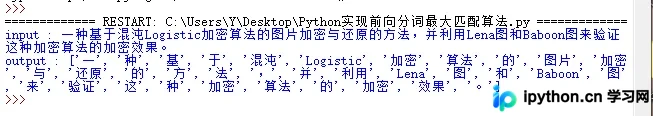
本文详细介绍基于词表的中文分词方法,重点讲解前向最大匹配算法的原理与Python实现。通过定义最大词长、递归匹配字典及主循环处理,演示如何对包含英文、数字及特定术语的中文句子进行有效分词,并提供完整代码供参考。
本文对比分析Python中常用的中文分词库jieba与pkuseg。详细讲解jieba的三种分词模式、自定义词典及停用词处理,并介绍pkuseg的多领域预训练模型优势。通过京东评论数据实例,对比两者在分词准确率与执行速度上的表现,为不同场景下的分词工具选择提供参考。