怎么让Python报错信息显示为中文
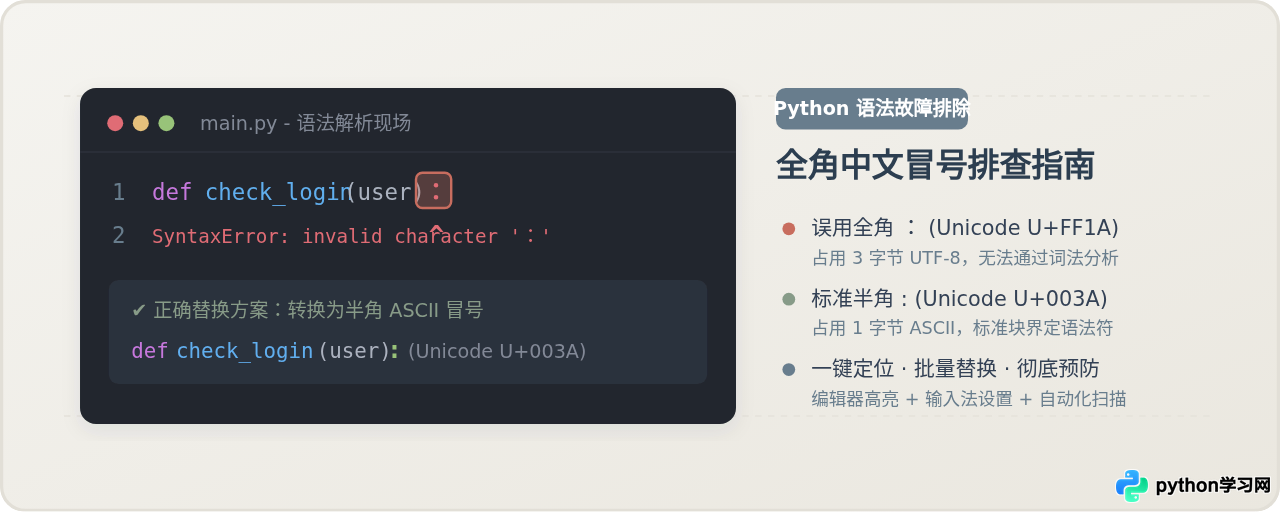
介绍如何让Python默认的英文报错堆栈转换为易读的中文解释,包括第三方工具friendly-traceback的配置与使用步骤、实现机制对比及适用场景分析。



介绍如何让Python默认的英文报错堆栈转换为易读的中文解释,包括第三方工具friendly-traceback的配置与使用步骤、实现机制对比及适用场景分析。
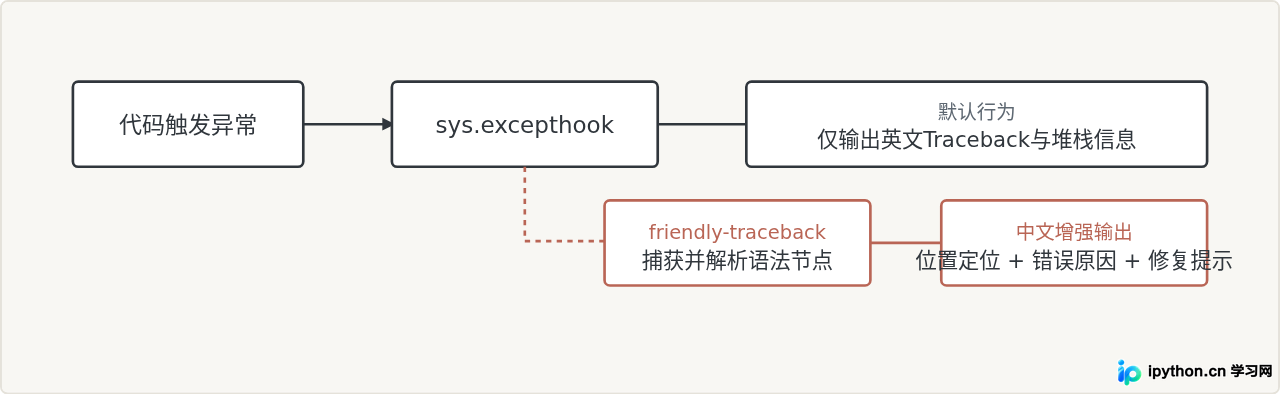
针对Python开发中因误输入中文全角冒号引发SyntaxError报错的问题,深入解析Unicode编码成因与版本差异,提供终端行号定位、全局批量替换的操作步骤,以及编辑器高亮与输入法防范配置方案。
本文介绍在Ubuntu系统中使用Python matplotlib时,如何安装Windows字体以解决字体缺失报错,并通过修改rcParams配置实现中文字体显示。
本文详解 Python 爬虫中因 URL 包含中文导致 UnicodeEncodeError 的原因及解决方案。通过 urllib.parse.quote 对链接进行编码转换,可有效避免 ASCII 解码异常,确保爬虫程序正常抓取含中文参数的网页内容。
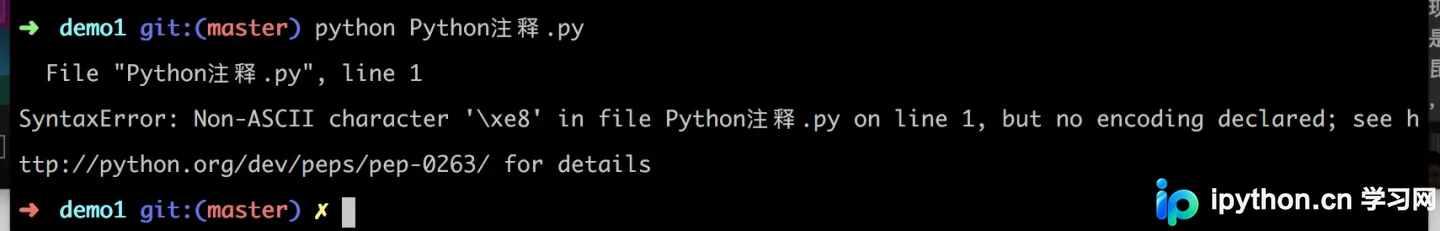
本文介绍Python2中运行包含中文代码时出现的SyntaxError: Non-ASCII character错误。通过解释器未声明编码导致,解决方法是在文件顶部添加#coding=utf-8或#-*- coding:utf-8 -*-声明,使解释器默认使用UTF-8解析,从而支持中文注释和字符串。
本文针对Python中使用f.write写入中文时出现的编码错误问题,提供了两种有效的解决方案。主要原因为默认编码方式不匹配,建议显式指定UTF-8编码进行写入,或通过修改系统默认编码来解决,确保中文内容能正确保存至文件。
本文介绍Python中写入含中文字符串到文件时出现的UnicodeEncodeError错误。提供两种解决方法:一是使用codecs模块打开文件并指定utf-8编码;二是通过sys.setdefaultencoding设置默认编码。详细步骤与代码示例帮助开发者快速修复该问题。
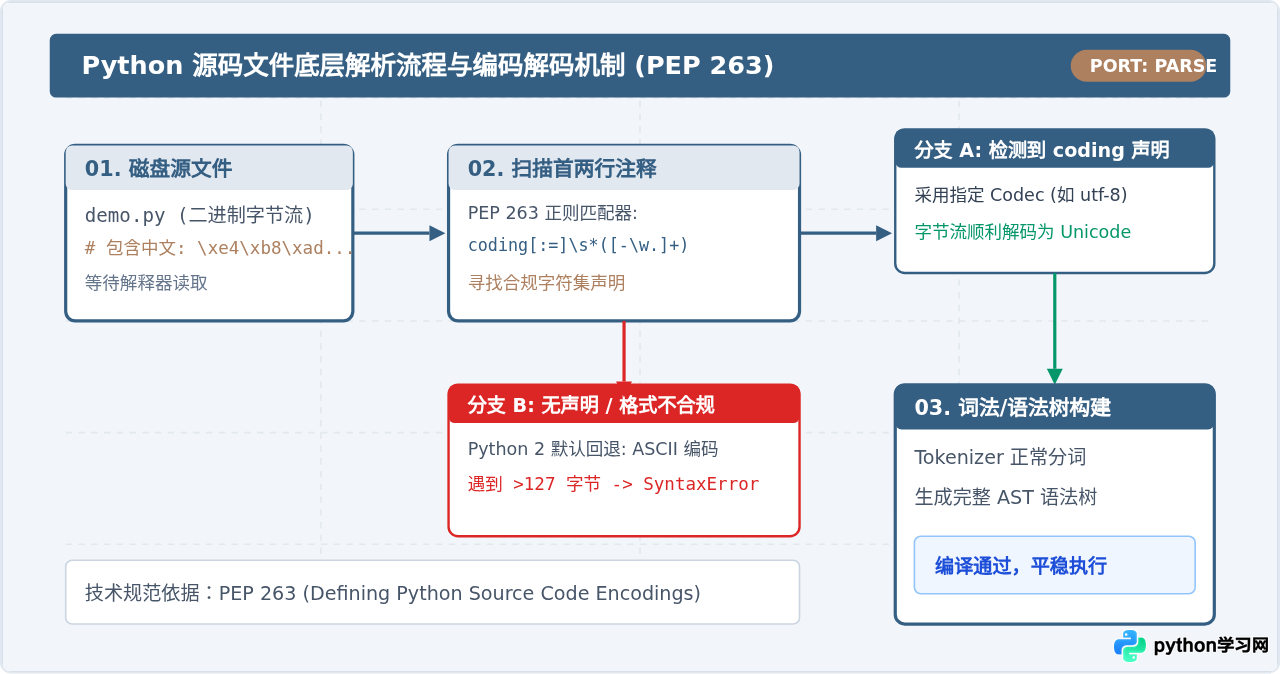
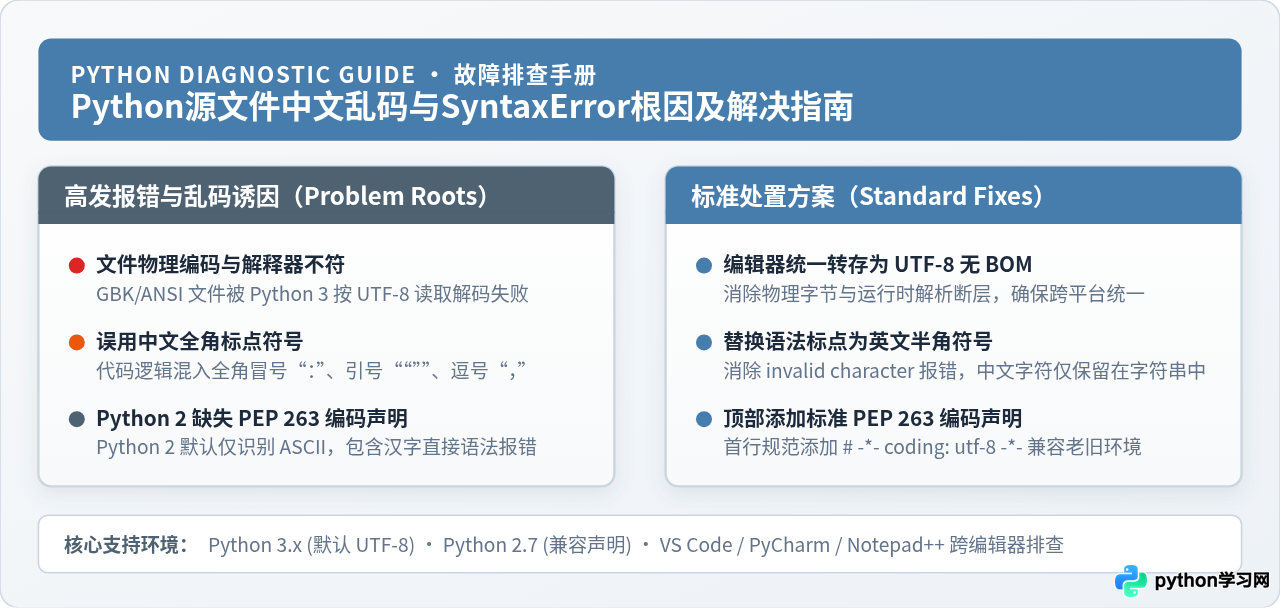
全面解决Python脚本中文注释引发的SyntaxError报错与编辑器、控制台乱码问题。详细拆解Python 2与Python 3编码机制差异、PEP 263标准声明规范、主流编辑器物理文件转码及终端环境代码页校准的标准操作流程。
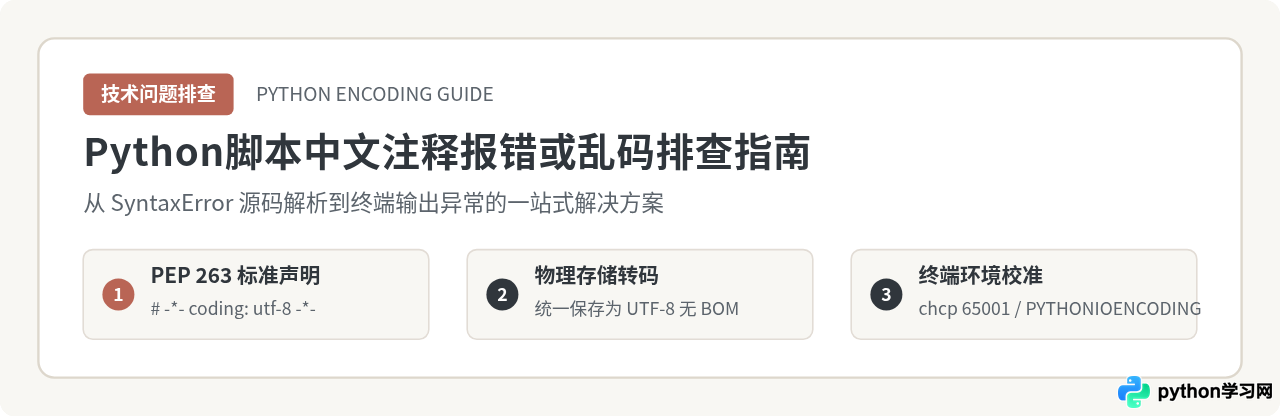
针对Python源文件中包含中文导致的SyntaxError语法报错与控制台输出乱码问题,系统讲解其底层诱因,并提供统一UTF-8无BOM保存、全角标点排查、PEP 263编码声明及终端代码页适配的标准解决流程。
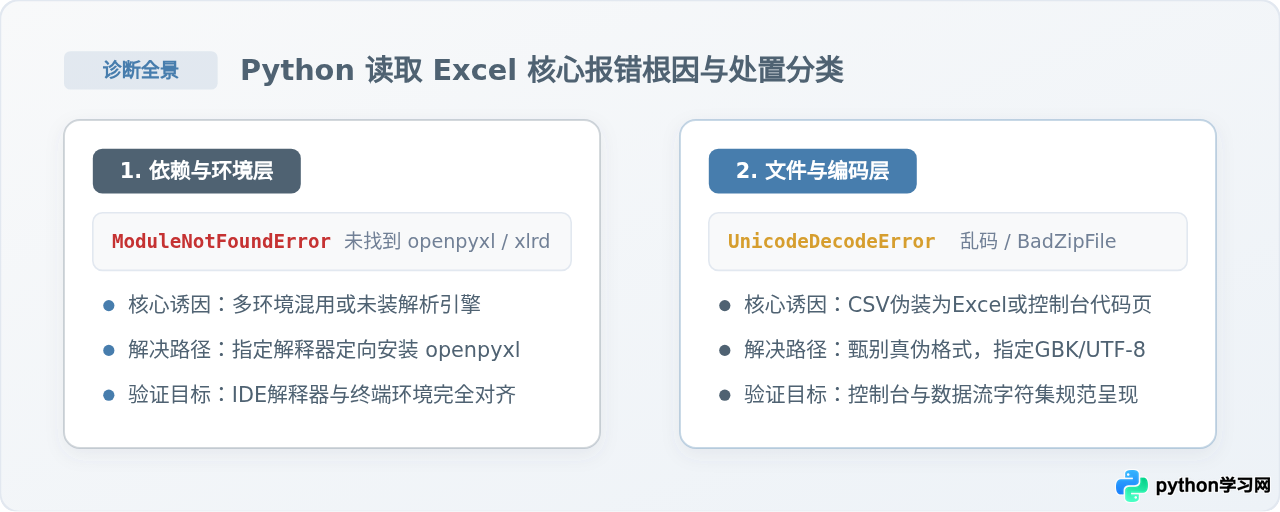
针对Python使用Pandas或原生库读取Excel表格时常见的ModuleNotFoundError模块缺失与中文乱码、UnicodeDecodeError报错,提供从引擎安装、环境对齐到文件真伪识别与编码修复的完整排查与解决指南。
本文介绍Python3中网络请求路径包含中文时引发的UnicodeEncodeError错误。通过示例展示如何利用urllib.parse.quote对中文参数进行编码,从而解决浏览器自动处理而代码需手动编码的问题,确保请求正常发送。
深入解析在Python源文件中编写中文注释时出现SyntaxError报错的原因,系统讲解PEP 263编码声明规范、# -*- coding: utf-8 -*-的作用机制、正确位置及常见陷阱。