


Python源文件中的中文注释报错?# -*- coding:utf-8 -*-的作用解析

在编写 Python 脚本时,如果代码中包含中文注释或中文字符串,运行程序时可能会直接中断并抛出 SyntaxError: Non-ASCII character ... but no encoding declared 异常。该报错的核心原因是解释器未能识别源文件的字符编码格式。通过在文件前两行中添加规范的编码声明(例如 # -*- coding: utf-8 -*-),可以明确告知解释器采用 UTF-8 编码读取源码字节流,从而彻底解决中文解析失败的问题。
一、报错现象与发生根源剖析
当我们在 Python 文件中添加中文说明或文档注释时,执行文件可能会看到类似如下的终端报错输出:
SyntaxError: Non-ASCII character '\xe4' in file demo.py on line 2, but no encoding declared; see http://python.org/dev/peps/pep-0263/ for details该错误是由 Python 源码解析机制直接触发的。计算机存储的代码本质上是磁盘上的二进制字节流(Bytes),解释器在执行代码前,必须先将这些字节解码为对应的文本字符(Unicode 字符串),然后再进行词法分析和语法分析(AST 构建)。
在 Python 2 体系中,默认的源文件字符集为纯 ASCII 编码。ASCII 编码仅涵盖 0 到 127 范围内的基础西文字符,根本不包含中文字符所使用的多字节编码(例如 UTF-8 中的 3 字节表示,或 GBK 中的 2 字节表示)。一旦词法分析器读到大于 127 的字节(如上述报错中的十六进制字节 \xe4),而文件头部又没有任何编码声明时,解释器便无法确定该字节属于何种编码,出于语法严谨性保护,直接抛出语法错误并终止运行。
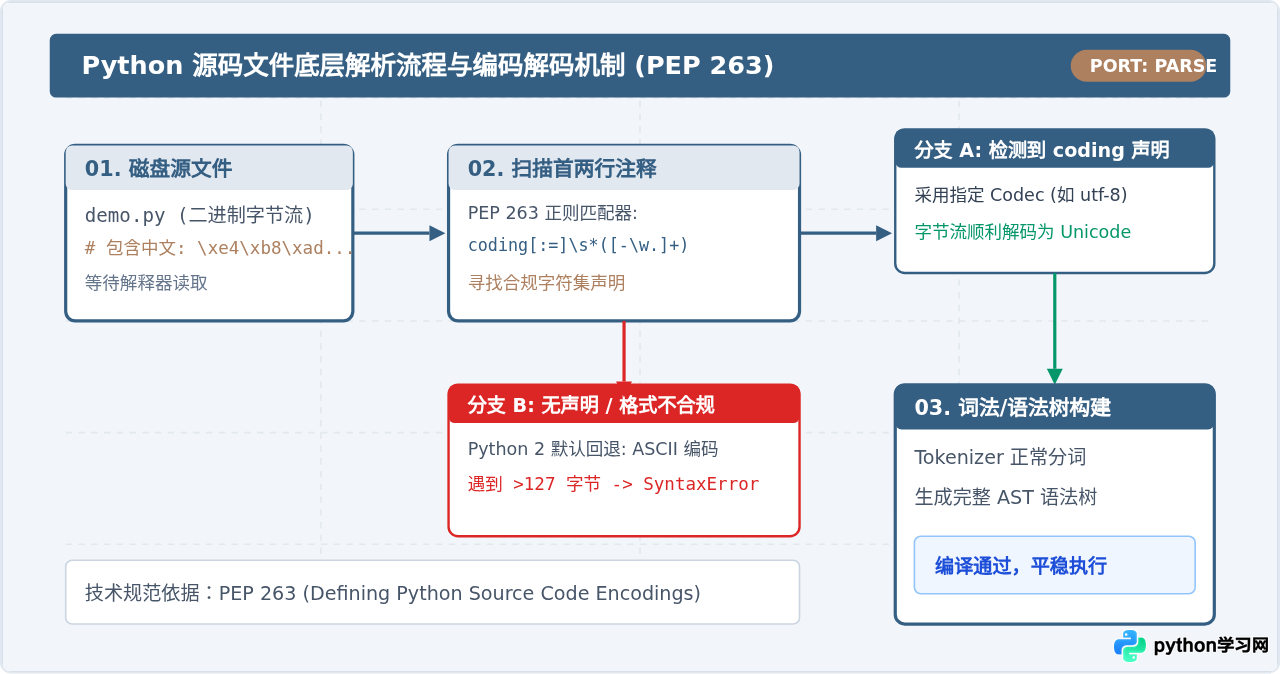
二、# -*- coding: utf-8 -*- 的作用原理与规范形式
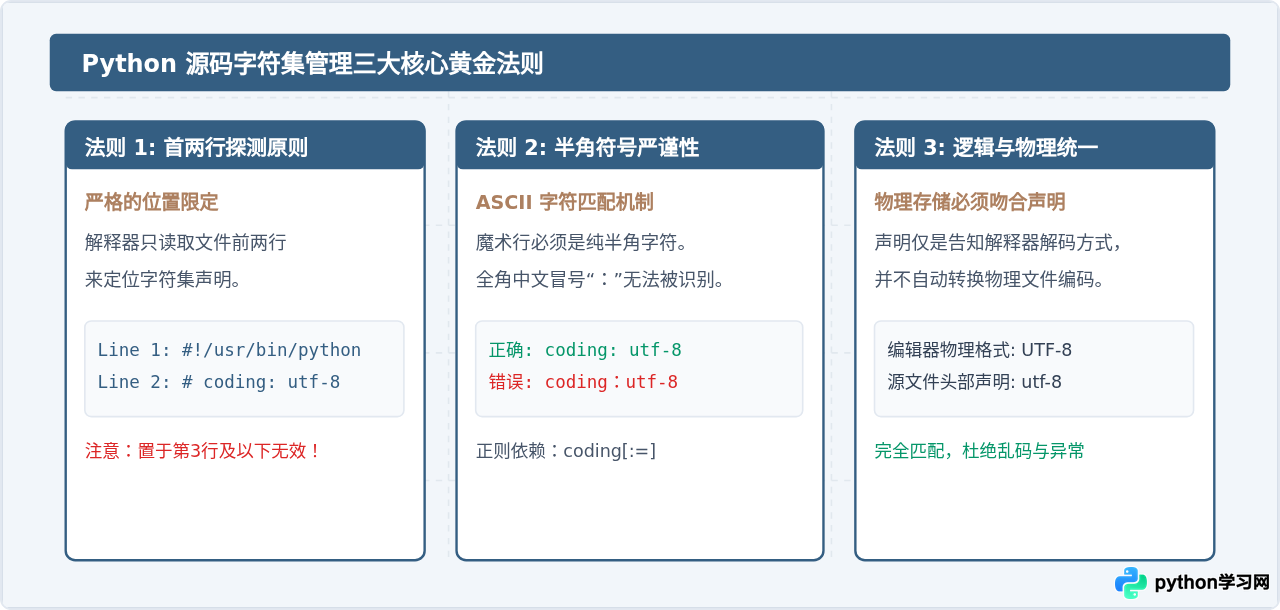
为了让解释器准确理解包含非 ASCII 字符的源代码,Python 社区制定了 PEP 263 标准。该规范允许开发者在源码文件的前两行放置特定的魔术注释,通知解析器使用指定的编码表进行字符反序列化。
1. 标准魔术注释解析
最常见也是兼容性最好的声明形式如下:
# -*- coding: utf-8 -*-这一行代码并非 Python 的执行逻辑语句,而是写给词法解析器阅读的元数据指令。其中各个组成部分的实际作用如下:
#:Python 中的单行注释前缀。确保在运行时它被当作注释忽略,不会影响语法执行。coding: utf-8:核心键值对。这是 PEP 263 规则真正匹配并提取的部分,指明当前文件采用 UTF-8 字符集解码。-*-:源自 Emacs 等经典文本编辑器的排版标记,主要用于让编辑器自动启用对应的编码模式进行保存,Python 解释器在正则提取时会自动忽略这些装饰符号。
2. 语法等价形式
除了带 -*- 的 Emacs 风格,PEP 263 还支持以下符合正则标准的合法写法:
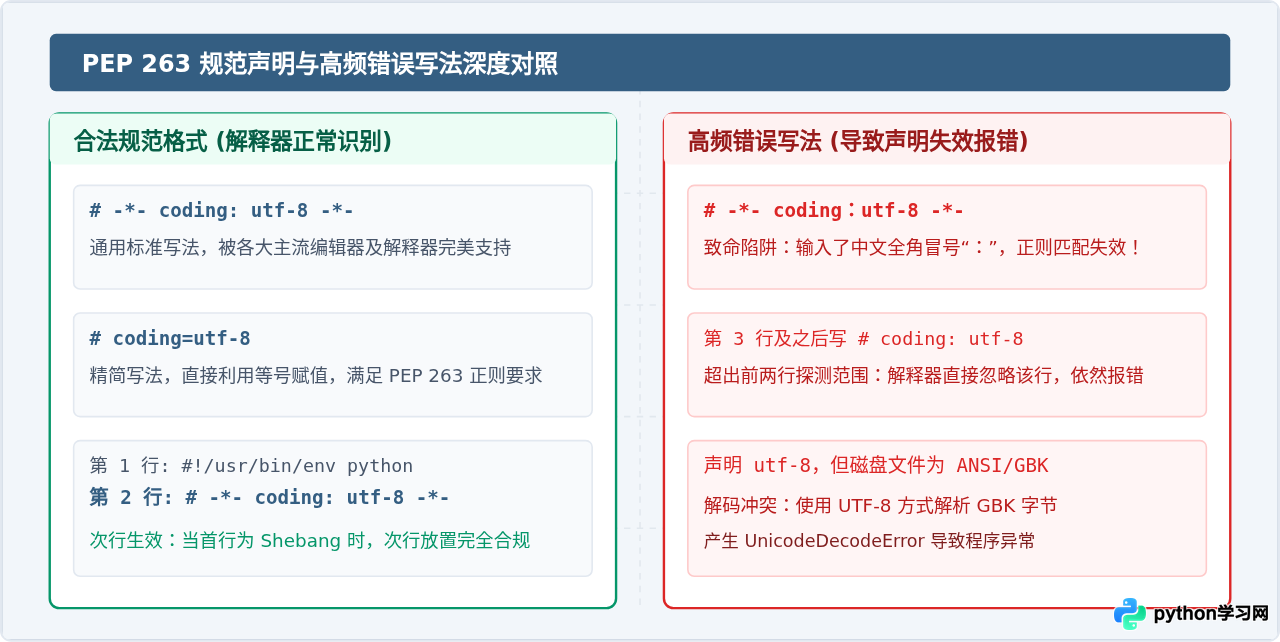
# coding=utf-8
# coding: utf-8
# vim: set fileencoding=utf-8 :
以上写法在语法层面上完全等效,只要满足正则式 coding[:=]\s*([-\w.]+),Python 解释器均可正确提取编码名称。
三、排查与规范修复的标准化操作步骤
遇到中文注释报错时,请按照以下五个标准化步骤逐步排查并解决:
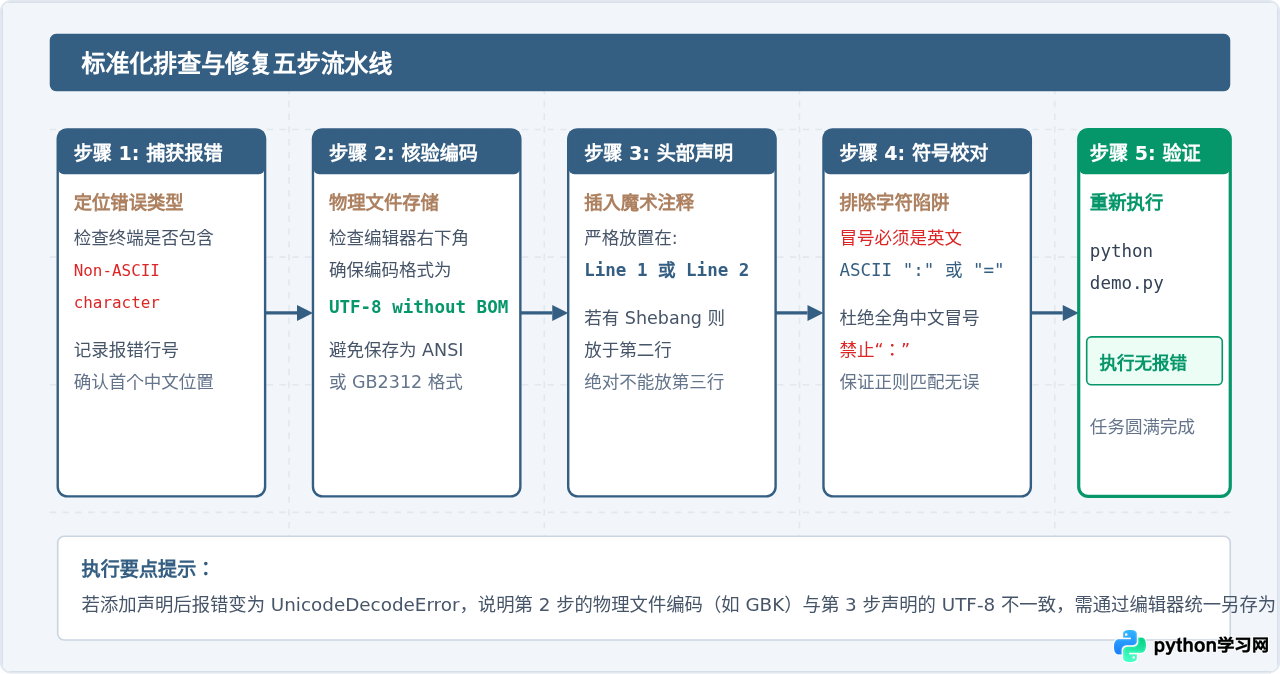
操作步骤细节:
- 步骤一:检查并定位报错位置。在报错日志中明确指出哪一行存在非 ASCII 字节。通常只要该行包含汉字(无论在注释中还是在未加
u前缀的字符串中),都会触发检查。 - 步骤二:检查物理文件的保存编码。在现代编辑器(如 VS Code、PyCharm、Sublime Text)的右下角状态栏中,查看当前文件编码是否为 UTF-8。如果是 GB2312、GBK 或 Windows 默认的 ANSI 编码,请在编辑器中点击编码名称并选择“通过编码保存(Save with Encoding)”重新保存为 UTF-8。
- 步骤三:在代码顶部添加规范编码声明。在源文件的第一行添加如下内容:
如果脚本需要直接在 Linux/macOS 终端中通过# -*- coding: utf-8 -*-./demo.py运行,第一行必须保留 Shebang(解释器路径说明),此时编码声明顺延至第二行:#!/usr/bin/env python # -*- coding: utf-8 -*- - 步骤四:特别核对冒号及符号类型。请特别注意键盘输入法状态。正如标题中提示的
# -*- coding:utf-8 -*-,如果冒号不慎输入为中文全角冒号“:”,由于该字符本身属于多字节中文字符,不仅无法被 PEP 263 的 ASCII 正则匹配,甚至声明行自身就会直接诱发 Non-ASCII 报错!因此,必须确保coding:中的冒号为半角英文字符(ASCII 58)。 - 步骤五:重新运行脚本验证结果。保存文件后重新在控制台执行代码,确认不再抛出语法错误,中文输出或注释均正常工作。
四、Python 2 与 Python 3 的编码机制演进对比
很多初学者会产生一个疑问:为什么在一些新安装的环境中,源文件即便完全不写 # -*- coding: utf-8 -*-,中文注释也不会报错?这主要取决于当前运行环境是 Python 2 还是 Python 3。
| 对比维度 | Python 2.x (已退役) | Python 3.x (现代标准) |
|---|---|---|
| 默认源码编码 | ASCII | UTF-8 (PEP 3120) |
| 无声明时的中文注释 | 直接抛出 SyntaxError 报错中断 | 默认正常识别与执行,不会报错 |
| 字符串默认类型 | str 为字节串(Bytes),Unicode 需显式写 u'中文' |
str 默认为 Unicode 字符,字节流使用 bytes |
| 是否仍需写 coding 声明 | 必须书写,否则无法处理中文 | 非必须;若保存为 UTF-8 可省略,但书写仍完全合法 |
最佳实践建议:在现代 Python 3 项目中,只要源码文件按照业界标准保存为无 BOM 的 UTF-8 编码,即可完全省略 # -*- coding: utf-8 -*-。但如果你的代码库需要同时维护存量 Python 2 环境,或者作为独立模块分发,显式保留该声明能够提供最大程度的跨环境兼容性保障。
五、常见问题与注意事项
1. 文件保存为带 BOM 的 UTF-8 是否可行?
不建议。Windows 系统下的某些编辑器(如老版记事本)保存 UTF-8 文件时可能会在开头插入三个隐藏的不可见字节(\xef\xbb\xbf,即 BOM 标记)。在部分早期 Python 版本或特定环境下,BOM 字节可能会直接干扰词法分析器,导致语法错误。务必在现代编辑器中选择 UTF-8 without BOM(无签名 UTF-8)进行保存。
2. 为什么写了 # -*- coding: utf-8 -*- 后控制台中文打印仍出现乱码?
需要明确区分“源码语法解析错误”与“终端输出显示乱码”:
- 头部编码声明的作用是让 Python 解释器正确将文件内容读取解析为语法树,避免报
SyntaxError。 - 而控制台运行
print打印出现乱码(如出现“锟斤拷”或问号),属于运行期输出流(stdout)的编码与操作系统终端(如 Windows CMD 默认的 CP936/GBK 代码页)不匹配所致。解决该问题需通过调整终端环境变量(例如在 Python 中配置PYTHONIOENCODING=utf-8或chcp 65001)来适配。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















