


Python 网络爬虫实战:模拟登录流程详解

发布时间:2026-10-13 |
5人浏览过
本文详解利用Python进行网站模拟登录的完整流程。通过开发者工具分析Network请求,提取登录所需的隐藏参数,并使用requests库建立Session以维持状态。文章展示了如何获取HTML源码、正则提取数据、提交POST请求以及获取登录后页面内容,提供基础代码参考。
与直接抓取公开网页信息不同,实现模拟登录功能需要向服务器发送特定的认证数据,例如用户名和密码等凭证。
对一个网站进行模拟登录通常包含以下主要步骤:
第一步是定位并提取登录页面中的隐藏字段信息,并将其保存(若目标网站无需额外隐藏信息,则此筛选步骤可省略)。
第二步是将收集到的数据进行提交。
第三步是获取登录成功后的页面信息。
以下是完整的实现代码示例。
<span style="font-size: 14px;"># -*- coding: utf-8 -*-
import requests
def login():
 session = requests.session()
 # res = session.get('http://my.its.csu.edu.cn/').content
 login_data = {
 'userName': '3903150327',
 'passWord': '136510',
 'enter': 'true'
 }
 session.post('http://my.its.csu.edu.cn//', data=login_data)
 res = session.get('http://my.its.csu.edu.cn/Home/Default')
 print(res.text)
login()</span>
一、筛选并获取隐藏信息
打开浏览器开发者工具(按F12),切换到Network(网络)面板,手动执行一次登录操作。在请求列表中找到第一个登录请求,查看其Header(标头)底部的data数据段,这里包含了登录所需的关键信息。若需修改其中的隐藏字段,请留意此处配置。
首先获取目标网页的HTML源码内容。
res = session.get('http://my.its.csu.edu.cn/').content
随后利用正则表达式对源码进行筛选,提取出所需的隐藏信息。
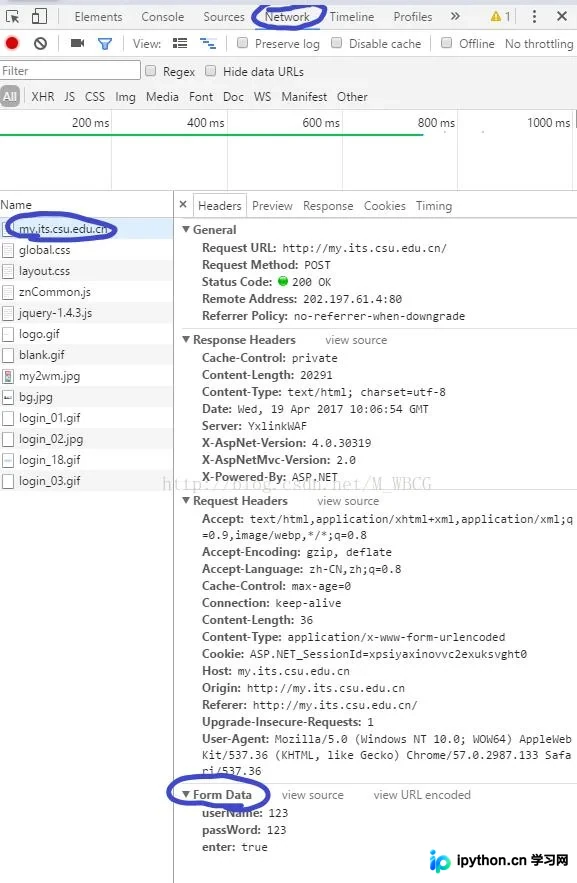
二、提交登录信息
在源码中定位表单提交的action(动作地址)和method(提交方法)。
使用相应的HTTP请求方法。
session.post('http://my.its.csu.edu.cn/(这里就是提交的action)', data=login_data)
通过该方法将数据提交至服务器。
三、获取登录后的信息
当信息提交成功后,模拟登录即告完成。
接下来即可获取并处理登录后的页面数据。
res = session.get('http://my.its.csu.edu.cn/Home/Default').content
以上关于Python网络爬虫模拟登录的简单实例讲解完毕,希望能为读者提供参考与帮助,欢迎继续支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















