



很多 VAE 教程都能把模型训练起来,但一到生产环境,问题就会集中暴露:损失函数选错,KL 和重构项量级不一致,导出 ONNX 时接口耦合过深,或者上线加载 checkpoint 直接报错。要把一个基于 PyTorch 的 VAE 真正做成可维护的生成式方案,关键不在“能不能训”,而在训练目标、推理接口和权重加载这三层是否从一开始就设计正确。
下面按实现链路逐项拆开:先看为什么重构损失不能随手用 MSELoss,再说明 torch.no_grad() 在 VAE 里该放在哪、不该放在哪,最后落到部署中最常见的 ONNX 导出和 checkpoint 加载问题。读完后,你可以据此快速判断现有代码是训练目标偏了,还是工程接口本身不适合上线。
重构损失为什么不能直接用 MSELoss
VAE 的目标本质上不是“把像素差值压小”这么简单,而是做概率建模。模型输出通常会对应某种显式分布,因此重构项应该和分布假设匹配,而不是习惯性套一个 MSELoss。
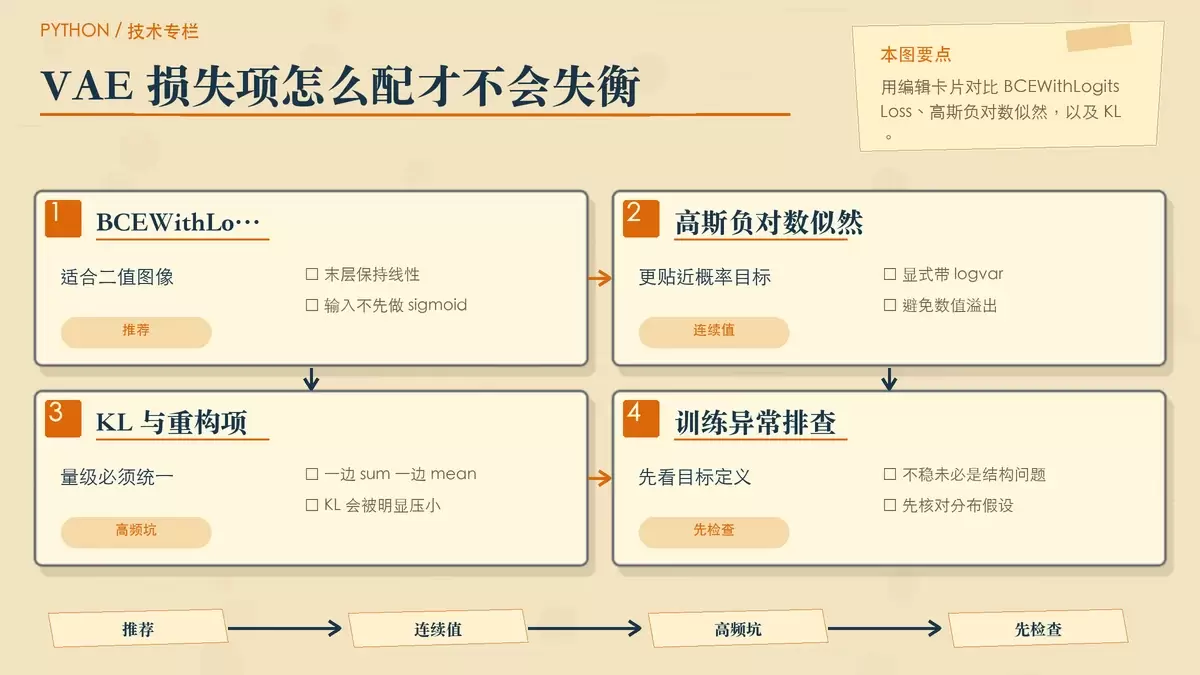
如果输出层接的是 sigmoid 或者整体目标更接近伯努利分布,那么更合适的是 nn.BCEWithLogitsLoss。如果处理的是连续图像,通常要写成带方差项的高斯负对数似然,而不是直接拿均方误差替代。原因在于,VAE 的训练目标同时包含重构项和 KL 散度项,重构损失如果定义得过于粗糙,KL 项的权重关系就容易失衡,训练会变得不稳定,严重时甚至出现坍缩。
二值图像的常见写法
以 MNIST 这类二值图像为例,常见做法是使用:
nn.BCEWithLogitsLoss(reduction='sum')这里有两个实现细节不能混淆:
- 输入不要先经过
sigmoid - 模型最后一层保持线性输出
这样做的原因是 BCEWithLogitsLoss 已经把数值更稳定的 logits 计算路径封装好了,手动先做 sigmoid 反而容易带来额外的数值问题。
连续图像更适合显式高斯似然
如果数据像 CelebA 这类连续像素图像,更稳妥的实现方式是直接写高斯负对数似然,例如:
-0.5 * ((x - x_recon) / torch.exp(logvar))**2 - logvar这种写法的价值在于把方差建模也纳入了重构目标,而不是只比较像素差。相比“看起来更简单”的 MSE,它更符合 VAE 的概率建模设定,也更利于后续调 KL 权重时保持目标一致性。
KL 项和重构项的量级必须统一
这也是训练里最容易被忽略的坑之一。很多实现会把重构项写成 sum(),再把 KL 项写成 mean(),结果两部分根本不在一个量级上,模型表现就会非常怪。
常见错误类似这样:
kl_loss.mean()但与此同时,重构损失却用了 sum()。这会让 KL 项被大幅压缩,训练目标失去平衡。正确做法是两者统一策略:要么都取 mean(),要么都按相同维度求和后再加权平衡。
换句话说,VAE 训练不稳定时,先别急着怀疑网络结构,先检查你的重构项分布假设和 KL 的缩放方式是不是一致。
torch.no_grad() 在 VAE 里该怎么用
VAE 的另一个高频误区,是把 torch.no_grad() 加进前向主干,试图“控制采样不参与梯度”。这通常会直接把该保留的梯度一并关掉。
需要明确的是,编码器输出的 mu 和 logvar 本来就必须参与反向传播,因为它们决定了潜变量分布参数。真正随机的是重参数化里的噪声项 eps,而这个张量默认就不在需要训练的计算图里,不需要额外用 no_grad 包起来。
重参数化的正确理解
典型形式是:
z = mu + eps * std这里的 eps 应该直接来自:
torch.randn_like(mu)这一写法已经足够,通常无需再人为加 torch.no_grad()。因为采样噪声本来就不是可学习参数,PyTorch 不会把它当成需要求导的叶子节点来处理。反过来说,如果你在更大范围内误用了 no_grad,反而会让 mu、logvar 或后续路径丢失梯度。
只有推理和生成阶段才需要禁用梯度
torch.no_grad() 更适合放在生成推理阶段,比如:
model.sample(n)这种场景下包裹整个过程,可以减少显存占用,也能避免不必要的计算图保留。对于验证流程,如果环境是 PyTorch ≥ 2.0,更推荐直接使用:
torch.inference_mode()它比 no_grad 更轻量,也更符合纯推理场景。
因此,判断标准可以很简单:训练前向别乱加 no_grad,采样生成和验证推理再用它。
部署时如何拆分 encode/decode 并兼容 ONNX
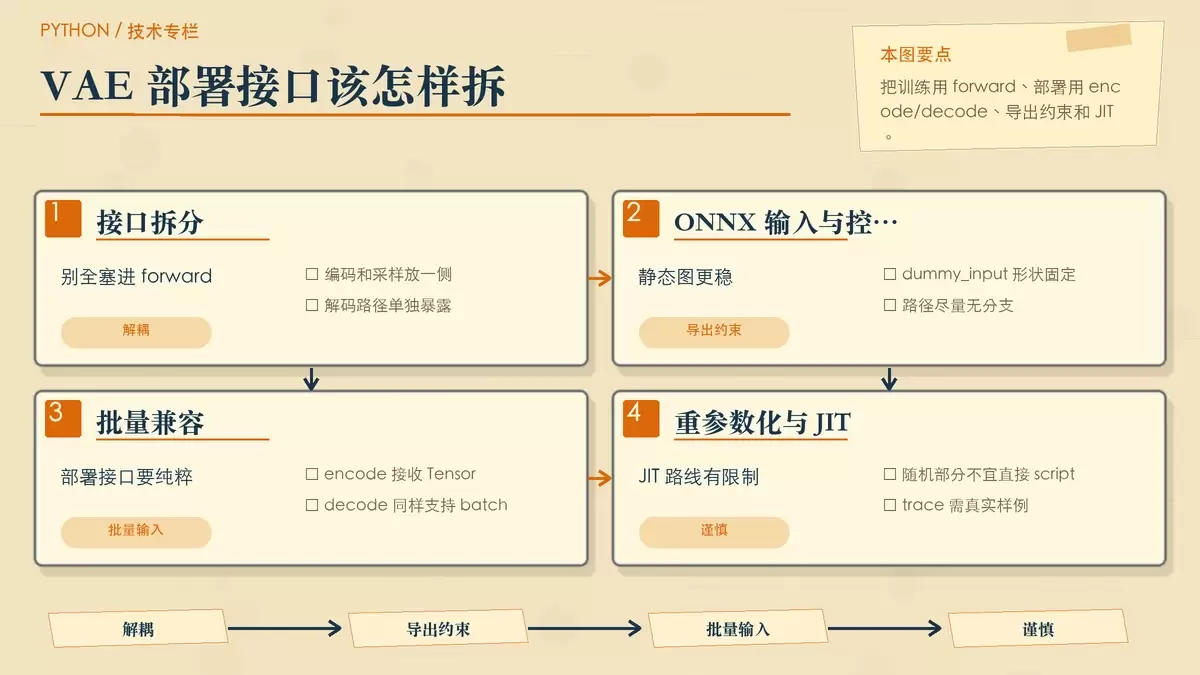
很多 PyTorch 版 VAE 的初始实现,会把编码、采样、解码全部塞进 forward()。训练时这么写问题不大,但到了部署和导出阶段,这种耦合就会变成障碍。
如果要支持 ONNX,接口必须尽量清晰、稳定,而且避免依赖复杂控制流。最直接的做法,是把编码和解码拆成独立方法,让它们接收批量 Tensor 输入,并且每个方法只做单一职责的工作。
推荐的接口拆分方式
可以显式定义两类方法:
def encode(self, x: Tensor) -> Tensor:返回 z,内部只处理编码器和重参数化。
def decode(self, z: Tensor) -> Tensor:只走解码器路径。
这样做的核心价值不是“代码更优雅”,而是让训练接口和部署接口分离。后续无论是单独导出编码器能力,还是在服务里把潜变量输入和图像生成分成两段处理,都会容易很多。
导出 ONNX 时要注意的约束
导出通常会用到:
torch.onnx.export(model, (dummy_input,), ...)这里至少有两点要提前满足:
dummy_input的形状要固定,例如(1, 3, 64, 64)- 模型内部不能依赖未执行到的控制分支,尤其像
if self.training:这种逻辑会破坏导出稳定性
ONNX 更喜欢“确定性的静态路径”,所以在设计 VAE 接口时,最好把训练态和推理态差异压缩到接口外层,而不是埋进核心图里。
随机采样部分不要随意套 torch.jit.script
另一个常见问题,是有人尝试用 torch.jit.script 处理带随机采样的重参数化部分。实际中这往往不合适,因为这类路径不容易按预期被脚本化。
更稳妥的建议是:
- 不要对含随机采样的部分强行做
torch.jit.script - 如果必须走 JIT 路线,优先考虑
torch.jit.trace并提供真实输入样例
本质上,VAE 里的随机性越靠近部署导出链路,就越要提前把接口边界划清。
生产环境加载 checkpoint 为什么会报 Missing key
相比训练阶段的问题,线上更常见的报错其实来自权重加载,尤其是:
Missing key(s) in state_dict这类错误多数不是权重文件坏了,而是保存和加载的上下文不一致。
先统一保存格式
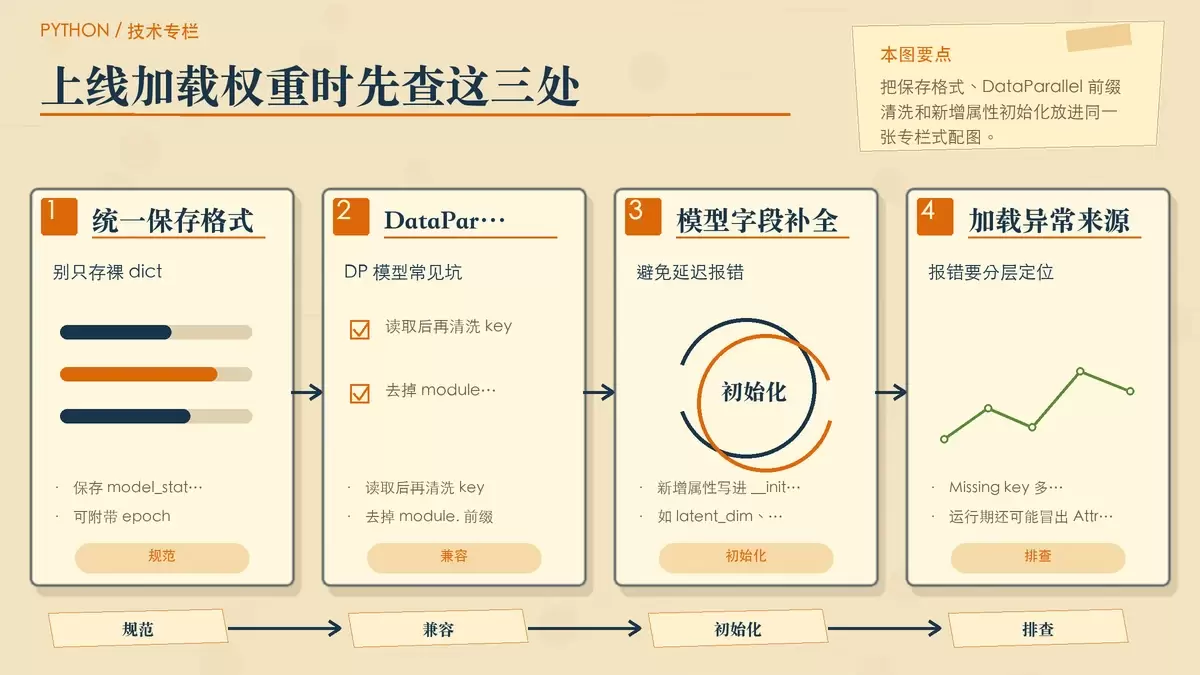
保存时建议始终带上明确字段,而不是只存一个裸的 state_dict:
torch.save({'model_state_dict': model.state_dict(), 'epoch': epoch}, path)这样加载端可以稳定读取结构化内容,也方便后续补充训练轮次、优化器状态或其他元数据。
DataParallel 前缀要在加载时清洗
如果训练时用了 DataParallel,保存出的 key 往往会带 module. 前缀。加载到非 DP 模型时,就会触发 key 对不上。
常见处理方式是:
state_dict = torch.load(path)['model_state_dict']state_dict = {k.replace('module.', ''): v for k, v in state_dict.items()}这一步属于典型的生产兼容层,最好固定写进加载工具函数,而不是每次手动处理。
新增字段要在 __init__ 中完成初始化
另一个容易漏掉的情况,是模型结构后来做了小改动,比如新加了:
self.beta或:
self.latent_dim = 64这类字段如果没有在 __init__ 中初始化,load_state_dict() 可能未必当场报错,但运行到相关逻辑时就可能抛出 AttributeError。这种问题比直接加载失败更麻烦,因为它会延迟到推理阶段才暴露。
因此,生产环境下的判断标准很明确:不仅要让 key 能对上,还要保证模型类自身已经具备完整、稳定的属性定义。
把 VAE 做成生产方案时,真正要盯住什么
实际落地里,最难的往往不是把训练曲线跑出来,而是让 encode/decode 在不同设备和不同执行环境中行为一致。尤其当你把模型放到 CPU、TPU,或者尝试不同精度路径时,重参数化带来的数值波动会比训练脚本里更明显。
原始经验也很直接:在低精度场景下,重参数化采样更容易退化,因此生产推理更建议优先使用 FP32。至于量化,至少在这类 VAE 方案里,不应当默认当成首选优化项;相比之下,把接口拆清楚、损失定义做对、checkpoint 兼容层补全,通常更值得优先投入。
如果你的目标是把 VAE 变成稳定的生成式生产能力,那么可以按下面顺序排查:先看重构项是否符合分布假设,再看 KL 和重构损失量级是否统一,然后确认训练路径没有误用 torch.no_grad(),最后再处理 ONNX 导出和权重加载兼容。这样比一开始就陷入模型结构微调,更容易定位真正的问题来源。















