


Python字符串切片详解:语法、索引与步长应用

本文详细解析Python字符串切片技术,涵盖基础语法s[start:stop]、负索引机制以及带步长的切片方式s[start:stop:stride]。通过具体代码示例,展示如何截取子串、反向提取字符串及间隔取值,帮助开发者掌握Python字符串处理的核心技巧。
Python字符串切片基础概述
在Python中,字符串是最常用的数据类型之一。首先,我们需要明确如何定义一个字符串变量。
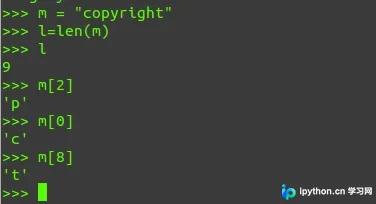
具体操作是将一串字符赋值给一个变量,例如将文本内容赋予变量名,以便后续进行各种处理。
与大多数编程语言一致,Python支持通过下标访问字符串中的单个字符。需要注意的是,字符串的下标索引从0开始计算。
除了单个字符访问,Python提供了强大的切片功能,允许我们截取字符串的任意连续部分。
字符串切片主要包含两种基本形式:不带步长的简单切片和带有步长的复杂切片。
简单切片语法与索引规则
第一种情况是不指定步长的简单切片操作。
其基本语法结构如下所示。
首先,我们需要定义一个字符串变量,例如命名为Hebe,并为其赋予具体的字符串值。
接着,使用切片语法Hebe[start:stop]来提取字符串的子序列。
需要特别注意切片参数的含义:start参数指定了截取范围的起始下标,而stop参数指定了结束位置。关键点在于,切片结果包含start下标对应的字符,但不包含stop下标对应的字符。换句话说,截取的范围是[start, stop),即显示到stop下标的前一个字符为止。
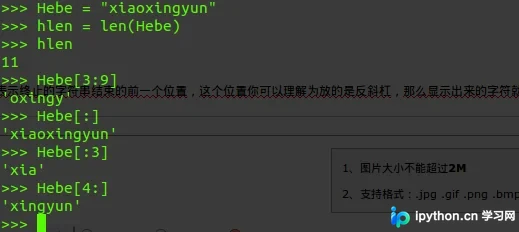
基于上述规则,如果希望从字符串开头截取到指定位置,可以使用省略start参数的写法[:a]。
>>> Hebe = "xiaoxingyun"
>>> Hebe[:3]
'xia'
反之,如果希望从指定位置截取到字符串末尾,可以使用省略stop参数的写法[a:]。
Hebe[4:]
'xingyun'
此外,Python字符串的索引支持负数。负数索引从字符串末尾开始计算,其中-1代表最后一个字符,-2代表倒数第二个字符,以此类推。
>>> Hebe = "xiaoxingyun"
>>> Hebe[-1]
'n'
>>> Hebe[-2]
'u'
>>> Hebe[-3]
'y'
>>> Hebe[-4]
'g'
利用负索引,我们可以更灵活地处理字符串截取,例如从末尾开始指定截取范围。
>>> Hebe[-3:]
'yun'
带步长的切片与反向提取
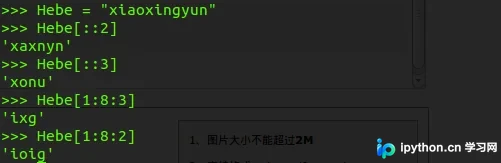
第二种情况是带有步长的切片方式,它允许我们按特定间隔提取字符。
这种切片方式依然基于字符串变量的定义,但通过引入步长参数,可以实现非连续字符的提取。
其标准语法格式为s[start:stop:stride]。
s [start: stop: stride]
与简单切片类似,结果字符串的最后一个字符仍然是stop下标的前一个字符。
其中,stride参数定义了提取字符的间隔步长。
下面通过几个具体示例来演示带步长切片的应用。
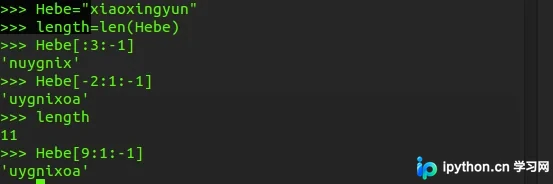
除了正向截取,我们还可以利用步长实现字符串的反向提取。
>>> Hebe="xiaoxingyun"
>>> length=len(Hebe)
>>> Hebe[::-1]
'nuygnixoaix'
>>>
当步长为负数时,表示从右向左进行截取。
>>> Hebe[::-2]
'nynxax'
这种反向截取功能在处理字符串反转或逆向索引时非常有用。
当stride设置为负数时,切片方向变为从右向左。此时,若步长的绝对值大于1,则表示每隔多个字符取一个值。
在使用反向切片时,start下标同样可以基于负数索引计算,或者必须满足start大于stop的条件,因为截取方向是从右向左进行的。
以上就是Python字符串切片的基本机制和常见用法。
本文介绍了Python字符串切片的详细语法与应用,希望能帮助读者更好地掌握这一技能。如有任何疑问,欢迎留言交流。感谢支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















