


Python搭建Spark分布式集群环境

本文详细讲解如何在Python环境下,利用三台物理机搭建Spark分布式集群。教程涵盖从Hadoop集群环境准备、Spark软件安装、环境变量配置,到slaves与spark-env.sh的关键参数设置。最后演示了Master与Slave节点的启动、进程验证及Web界面监控,提供完整的集群部署与关闭步骤。
Spark集群搭建概述
前言
Apache Spark是一款新兴的大数据处理通用引擎,其核心特性在于提供了分布式的内存抽象。Spark最大的优势在于处理速度极快,相比Hadoop MapReduce的处理效率可提升100倍。本文不采用在单台电脑上构建多个虚拟机来模拟集群的方式,而是直接使用三台物理电脑搭建一个小型的分布式集群环境进行安装配置。
本教程基于Spark 2.0以上版本(例如Spark 2.0.2、Spark 2.1.0等)进行集群搭建,该流程同样适用于搭建Spark 1.6.2版本的集群。
前置环境:Hadoop集群配置
安装Hadoop并搭建好Hadoop集群环境
Spark分布式集群的安装前提,是必须事先配置好Hadoop的分布式集群环境。
Spark软件安装与基础配置
安装Spark
本示例采用3台机器(节点)来演示Spark集群的搭建过程。其中1台机器作为Master节点,另外两台机器(节点)作为Slave节点(即Worker节点),这两台Slave节点的主机名分别为Slave01和Slave02。
在Master节点机器上,访问Spark官方下载地址,按照相关图示进行下载操作。
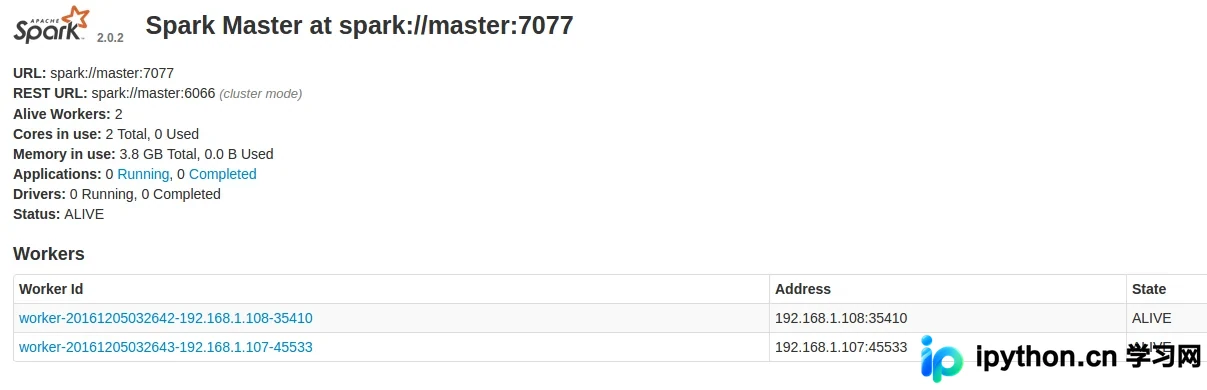
下载完成后,执行如下命令:
sudo tar -zxf ~/下载/spark-2.0.2-bin-without-hadoop.tgz -C /usr/local/
cd /usr/local
sudo mv ./spark-2.0.2-bin-without-hadoop/ ./spark
sudo chown -R hadoop ./spark
配置环境变量
在Master节点主机的终端中执行如下命令:
vim ~/.bashrc在.bashrc文件中添加如下配置:
export SPARK_HOME=/usr/local/spark
export PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin
执行如下命令使得配置立即生效:
source ~/.bashrcSpark核心配置文件设置
Spark配置
在Master节点主机上进行如下操作:
配置slaves文件
将 slaves.template 拷贝到 slaves
cd /usr/local/spark/
cp ./conf/slaves.template ./conf/slaves
slaves文件用于设置Worker节点。编辑slaves内容,把默认内容localhost替换成如下内容:
slave01
slave02
配置spark-env.sh文件
将 spark-env.sh.template 拷贝到 spark-env.sh
cp ./conf/spark-env.sh.template ./conf/spark-env.sh编辑spark-env.sh,添加如下内容:
export SPARK_DIST_CLASSPATH=$(/usr/local/hadoop/bin/hadoop classpath)
export HADOOP_CONF_DIR=/usr/local/hadoop/etc/hadoop
export SPARK_MASTER_IP=192.168.1.104
SPARK_MASTER_IP 用于指定 Spark 集群 Master 节点的 IP 地址;
配置完成后,将Master主机上的/usr/local/spark文件夹复制到各个节点上。在Master主机上执行如下命令:
cd /usr/local/
tar -zcf ~/spark.master.tar.gz ./spark
cd ~
scp ./spark.master.tar.gz slave01:/home/hadoop
scp ./spark.master.tar.gz slave02:/home/hadoop
在slave01和slave02节点上分别执行下面同样的操作:
sudo rm -rf /usr/local/spark/
sudo tar -zxf ~/spark.master.tar.gz -C /usr/local
sudo chown -R hadoop /usr/local/spark
集群启动、验证与管理
启动Spark集群
启动Hadoop集群
在启动Spark集群之前,必须先启动Hadoop集群。在Master节点主机上运行如下命令:
cd /usr/local/hadoop/
sbin/start-all.sh
启动Spark集群
1.启动Master节点
在Master节点主机上运行如下命令:
cd /usr/local/spark/
sbin/start-master.sh
在Master节点上运行jps命令,可以看到多了个Master进程:
15093 Jps
14343 SecondaryNameNode
14121 NameNode
14891 Master
14509 ResourceManager
2.启动所有Slave节点
在Master节点主机上运行如下命令:
sbin/start-slaves.sh分别在slave01、slave02节点上运行jps命令,可以看到多了个Worker进程
37553 DataNode
37684 NodeManager
37876 Worker
37924 Jps
3.在浏览器上查看Spark独立集群管理器的集群信息
在master主机上打开浏览器,访问http://master:8080,界面如下:
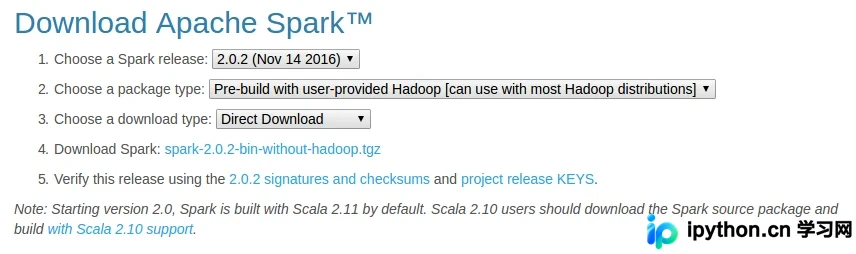
关闭Spark集群
1.关闭Master节点
sbin/stop-master.sh2.关闭Worker节点
sbin/stop-slaves.sh3.关闭Hadoop集群
cd /usr/local/hadoop/
sbin/stop-all.sh
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















