


Python基于Selenium实现博客园自动登录教程

本文详细介绍如何使用Python的Selenium库模拟浏览器行为,实现博客园的自动登录功能。文章从环境准备、ChromeDriver配置到具体代码实现,逐步解析打开浏览器、定位元素、输入账号密码及点击登录的全过程。同时针对可能遇到的滑动验证问题提供了应对建议,旨在为动态网页爬取和自动化测试提供实用参考。
Python Selenium自动登录博客园教程
本文主要讲解如何利用Python结合Selenium库实现博客园的自动登录功能,文中提供了详细的示例代码,对读者的学习或实际工作具有参考价值。
环境准备
在开始之前,需要做好以下准备工作:
由于本教程基于Chrome浏览器,因此必须下载并配置对应的ChromeDriver.exe文件,具体的下载方法可通过搜索引擎查询获取。
Selenium是一款自动化测试工具,能够模拟真实浏览器的操作行为。本文将演示如何使用该工具模拟浏览器登录博客园的过程。
登录流程分析
首先对登录流程进行分析,登录博客园主要包含以下步骤:
第一步,启动浏览器。
第二步,访问博客园主页网址。
第三步,点击登录按钮,并等待页面跳转完成。
第四步,输入用户名和密码,最后点击登录按钮提交。
代码实现与运行结果
明确上述步骤后,接下来通过代码进行实现:from selenium import webdriverimport time#创建登陆类
from selenium import webdriver

import time


class Loadup:
  def __init__(self,username,password):
    self.username = username
    self.password = password
    self.driver = webdriver.Chrome()

  def closeBrowser(self):
    self.driver.close()

  def login(self):
    driver = self.driver
    driver.get('https://www.cnblogs.com/')
    time.sleep(2)
    # 使用xpath的方法来定位元素
    login_button = driver.find_element_by_xpath("//a[@onclick='login();return false']")
    login_button.click()
    time.sleep(2)
    # 使用xpath的方法来定位元素
    username_elem = driver.find_element_by_xpath("//input[@name='LoginName']")
    # 使用xpath的方法来定位元素
    username_elem.clear()
    username_elem.send_keys(self.username)

    # 使用xpath的方法来定位元素
    password_elem = driver.find_element_by_xpath("//input[@name='Password']")
    password_elem.clear()
    password_elem.send_keys(self.password)

    #  定位登陆按钮
    loadup_button = driver.find_element_by_xpath("//span[@class='ladda-label']")
    loadup_button.click()
    time.sleep()

Leslie_ChanId = Loadup("176******","*******") #在此输入自己的帐号和密码
Leslie_ChanId.login()
运行上述程序:
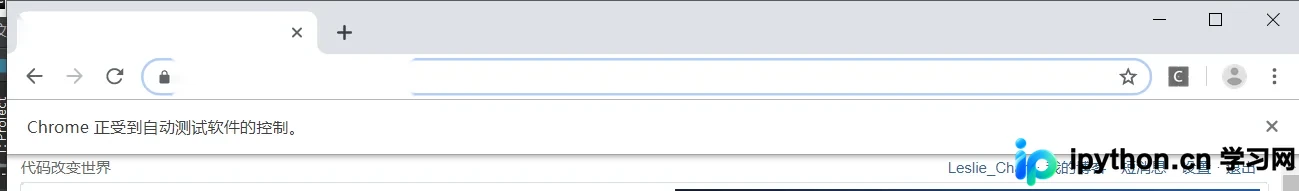
执行结果显示登录成功。仔细观察浏览器窗口,会发现顶部提示“Chrome正在受自动测试软件的控制”,这表明当前浏览器正由Selenium驱动操作,且在此期间人工仍可手动操作浏览器。
注意事项与扩展
补充说明:
在测试过程中,可能会触发博客园的滑动图片验证,这通常是由于频繁操作引起的。鉴于当前技术限制,自动完成正确的图片滑动较为困难,因此建议由人工手动完成滑动验证环节。
使用driver定位页面元素的方法不仅限于xpath,还可以利用id、name、link_text等多种方式。
通过Selenium进入网页后,可以执行多种操作,这是一种比传统方式更便捷的动态网页数据爬取手段。
以上就是本文的全部内容,希望能为读者带来帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















