


Python多线程:concurrent.futures线程池使用

理解 ThreadPoolExecutor 与线程池模型
线程池的核心价值在于解决频繁创建与销毁线程带来的系统开销。在Python中,concurrent.futures.ThreadPoolExecutor 通过预分配一组可复用的 worker 线程来执行任务。当调用 submit 方法时,任务并不会立即执行,而是被封装为一个 Future 对象并放入内部的任务队列中。空闲的 worker 线程会持续从队列中拉取任务并执行,执行完毕后返回线程池等待下一次调度。Future 对象充当了异步任务的占位符,用于后续查询状态或获取结果。需要明确的是,受限于 CPython 的全局解释器锁(GIL),线程池并不能提升纯 CPU 密集型计算的性能,它真正擅长的是处理网络请求、文件读写等 I/O 密集型任务。在 I/O 等待期间,GIL 会被释放,其他线程得以继续运行,从而实现真正的并发效果。
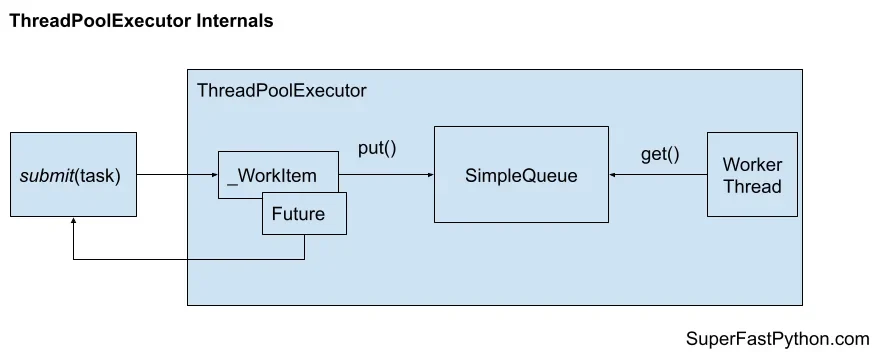
用 ThreadPoolExecutor 提交任务并获取结果
使用 ThreadPoolExecutor 最推荐的方式是结合 with 上下文管理器,例如 with ThreadPoolExecutor(max_workers=5) as executor:。max_workers 参数用于控制线程池中同时运行的最大线程数,若不指定,Python 3.8+ 默认取 min(32, os.cpu_count() + 4)。在上下文内部,通过 executor.submit(fn, *args) 可将函数异步提交至线程池,该方法立即返回一个 Future 实例。调用 future.result() 会阻塞当前主线程,直到对应任务完成并返回结果;若任务抛出异常,该异常会在调用 result() 时重新抛出。对于批量处理相同函数的场景,可直接使用 executor.map(fn, iterable),它会按输入顺序返回结果迭代器。当代码块执行完毕退出 with 作用域时,上下文管理器会自动调用 executor.shutdown(wait=True),确保所有已提交任务执行完毕后再安全关闭线程池,避免资源泄漏。
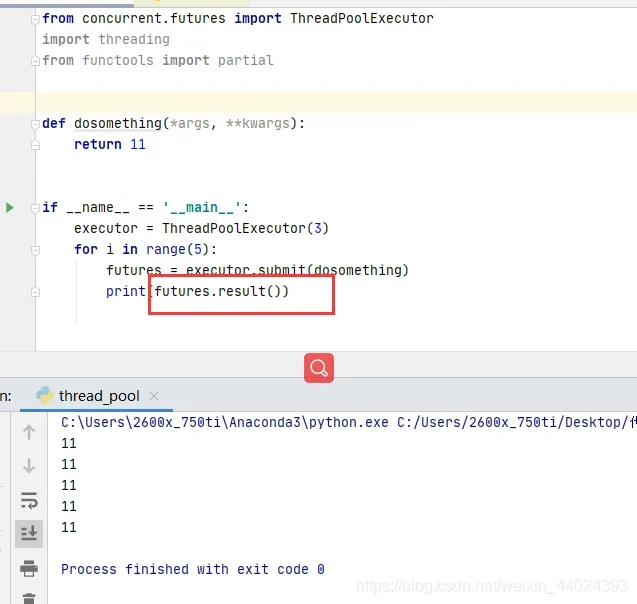
验证并发效果:任务完成、异常与执行时间
要验证线程池的并发效果,可设计包含 time.sleep() 或网络请求的耗时任务,并使用 time.perf_counter() 记录串行与并行执行的总耗时。通过对比可直观发现,并行总耗时远低于各任务耗时之和。在实际处理中,submit 的提交顺序并不等于任务完成顺序。若需按任务实际完成的先后顺序处理结果,应使用 concurrent.futures.as_completed(futures) 迭代器。该函数会动态监听传入的 Future 列表,一旦某个任务执行完毕,便立即将其对应的 Future 对象 yield 出来。此时调用该 Future 的 result() 方法即可安全获取返回值。值得注意的是,若任务内部发生未捕获异常,该异常不会静默丢失,而是会被 Future 捕获。当主线程调用 result() 时,原始异常会被重新抛出,开发者需配合 try...except 进行针对性处理,从而保证并发流程的健壮性与可观测性。
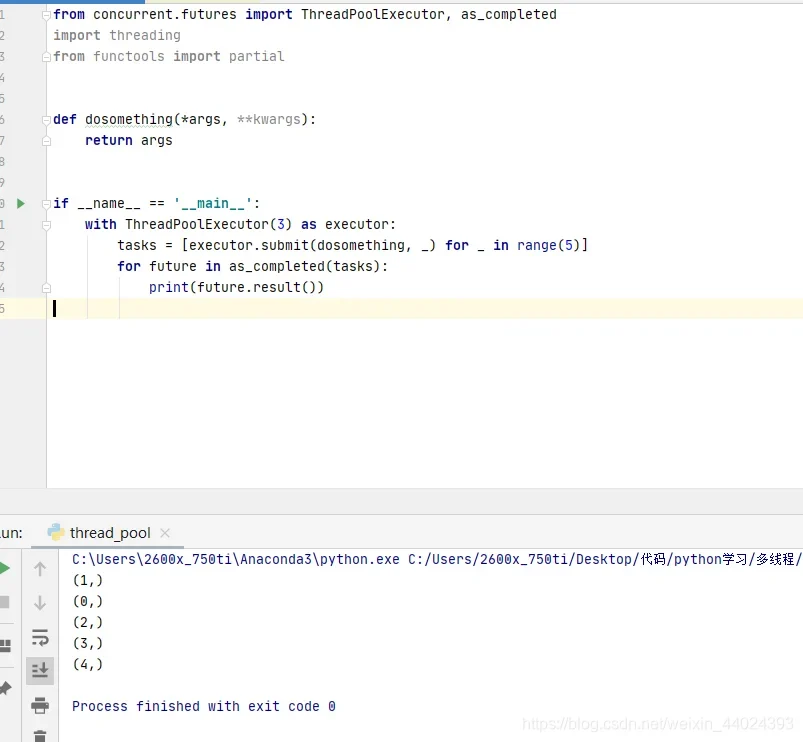
线程池常见坑与实践建议
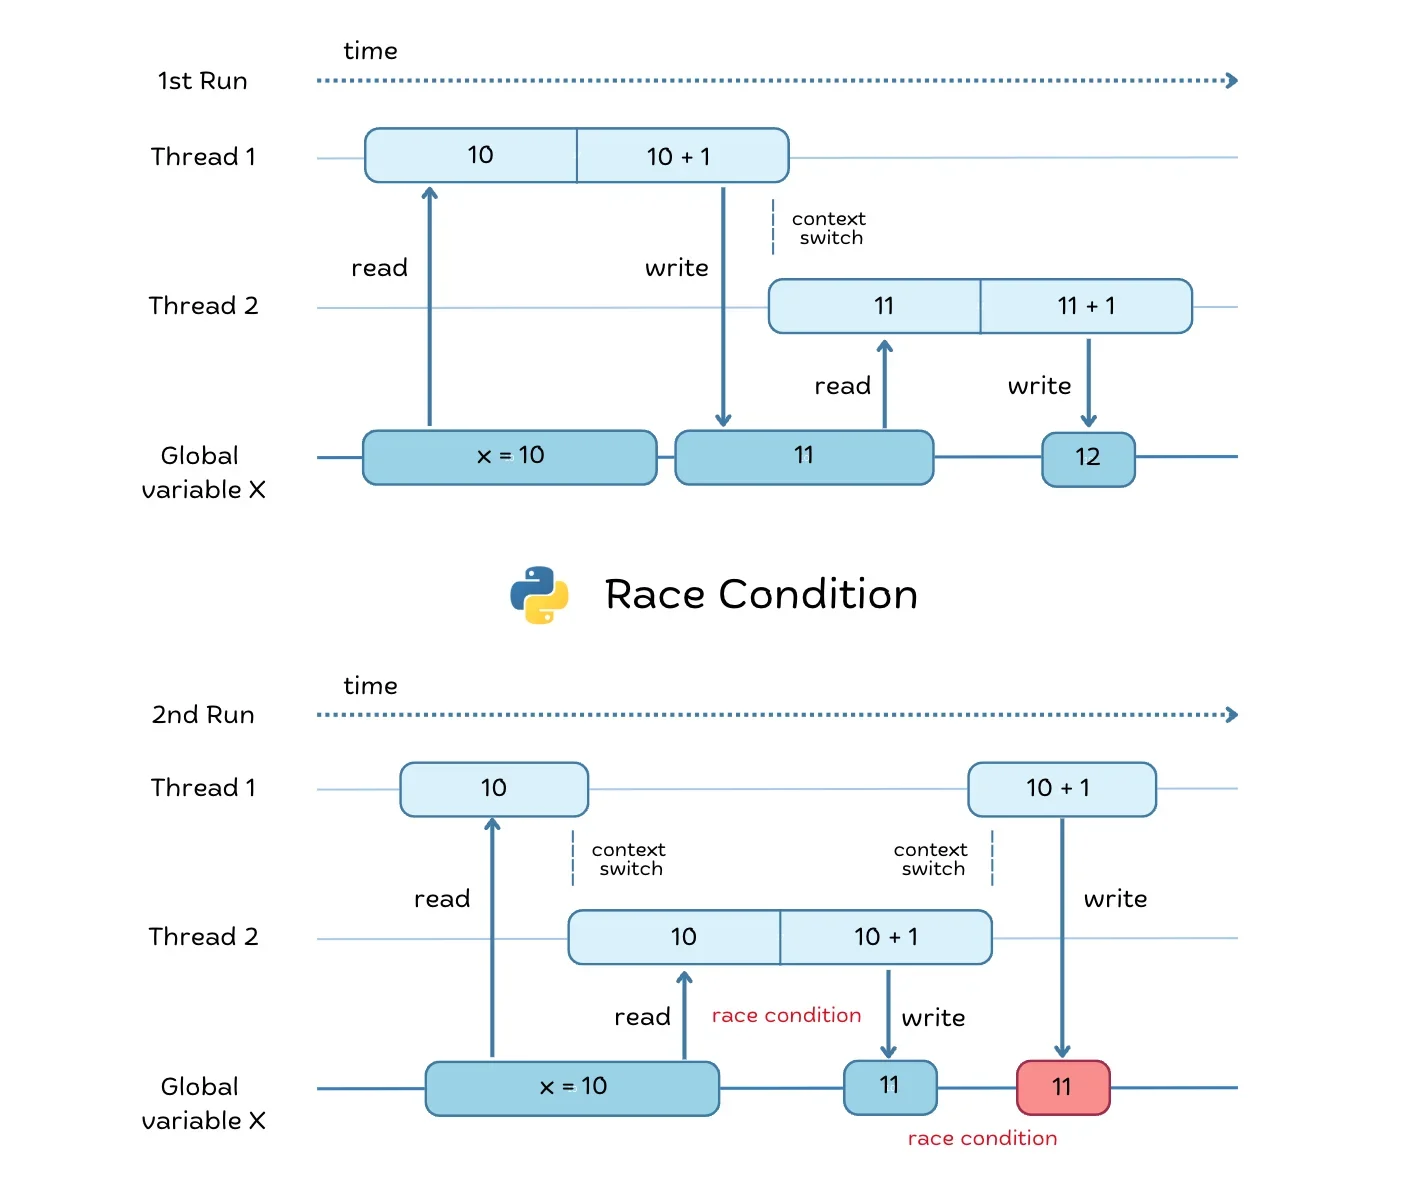
在实际工程中,滥用线程池极易引发隐蔽问题。首先,max_workers 并非越大越好,过高的线程数会导致上下文切换频繁,反而拖慢 I/O 密集型任务,通常建议根据网络延迟或并发连接数动态调整。其次,线程池内多个 worker 共享同一进程内存,若直接读写全局列表或字典等可变对象,会引发竞态条件与数据损坏,必须借助 threading.Lock 或 queue.Queue 保证线程安全。此外,切勿在循环中反复实例化线程池,应复用单一实例以降低初始化开销。任务异常绝不可被忽略,未处理的异常可能导致 Future.result() 永久阻塞或程序意外退出。最后,务必规范生命周期管理:在程序退出前显式调用 shutdown(wait=True),并合理设置 result(timeout) 防止个别慢任务拖垮整体流程。遵循池化复用、隔离共享、显式容错的原则,方能发挥并发编程的最大效能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















