


Python日志过滤:Filter与自定义日志等级

理解日志过滤与Filter工作机制
Python的logging模块采用管道式架构处理日志。当调用logger.info()时,日志首先经过Logger自身的等级阈值判断,随后生成LogRecord对象。该对象会依次流经挂载在Logger上的Filter,再分发给各个Handler。每个Handler同样拥有独立的Filter链,最后经Formatter格式化输出。Filter的核心机制在于其filter(record)方法:返回True或正整数表示放行,返回False、0或None则直接丢弃该条日志。与Logger负责日志生成、Handler负责输出目标、Level负责静态数值阈值不同,Filter提供的是动态、可编程的拦截能力,允许开发者在日志流转中途根据任意上下文条件进行筛选或修改LogRecord属性,从而实现更精细的控制。
实现Filter:按条件筛选与修改日志
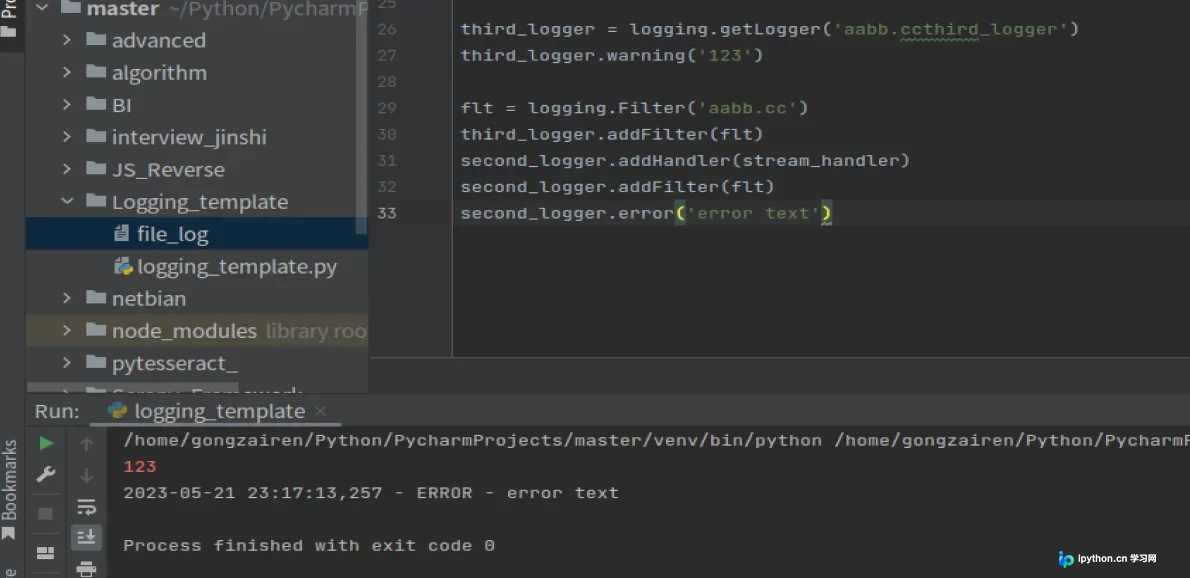
实现自定义Filter需继承logging.Filter并重写filter方法。例如,可创建一个按模块名和消息内容过滤的类:在filter(self, record)中,通过record.module判断来源模块,利用record.getMessage()检查敏感词,若命中则返回False拦截;同时可结合record.levelno进行等级拦截。绑定方式极为灵活,调用logger.addFilter(custom_filter)将使该Filter作用于该Logger产生的所有日志,而handler.addFilter(custom_filter)仅限制特定输出通道。验证时,建议编写包含不同模块、等级和关键词的测试用例,分别挂载至Logger与Handler,对比控制台与文件输出差异。通过打印record属性或开启logging.basicConfig(level=logging.DEBUG),可清晰观察被拦截与放行的日志轨迹,确保过滤逻辑符合预期。
自定义日志等级:定义、注册与实际使用
Python内置日志等级为10的倍数,自定义等级需避开冲突并合理插入数值区间,例如将审计日志设为25。首先调用logging.addLevelName(25, "AUDIT")完成名称注册,使格式化输出时能正确显示字符串。由于标准Logger未提供对应方法,需通过继承或动态绑定扩展:定义audit(self, msg, *args, **kwargs),内部调用self._log(25, msg, args, **kwargs)并配合self.isEnabledFor(25)进行前置检查。输出时直接调用logger.audit("用户登录")即可。过滤方面,可在自定义Filter中判断record.levelno == 25实现精准路由。验证环节需确保addLevelName在日志初始化前执行,并通过打印原始LogRecord的levelno与levelname字段,确认数值映射与文本渲染完全一致,避免等级显示为未知数字。
验证与避坑:Filter和自定义等级的常见问题
实际开发中常因机制理解偏差导致日志丢失或行为异常。首要误区是Filter返回False会静默丢弃日志,若未配置备用Handler或调试开关,排查极为困难。其次,挂载位置决定作用域:Logger级Filter拦截后,所有下游Handler均无法接收该日志;而Handler级Filter仅影响当前输出流,多Handler场景下需分别配置。自定义等级若数值与内置等级重叠(如设为20),将覆盖原有INFO行为,引发混乱。此外,仅注册名称未实现对应Logger方法会导致调用失败。验证时应采用隔离测试:先单独运行单Handler确认Filter逻辑,再叠加多Handler观察级联效应;通过打印record.__dict__核对等级数值与名称映射,并利用logger.propagate = False阻断父级传播干扰,确保过滤与等级配置精准生效。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















