


前端大文件上传:分片、断点续传与秒传实现

大文件上传的整体方案与分片设计
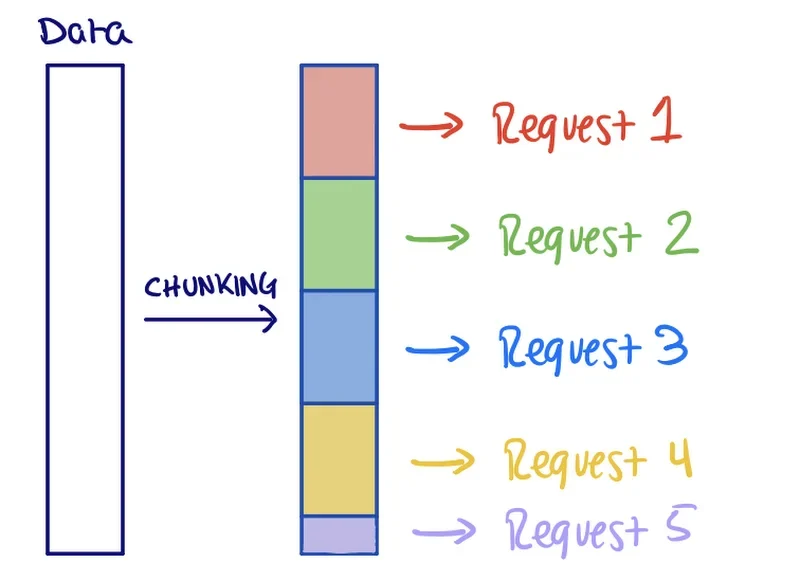
普通单文件上传依赖单次 HTTP 请求,当文件体积超过数百 MB 时,极易因网络波动、服务器超时限制或内存溢出导致上传失败。分片上传的核心思路是将大文件切割为固定大小的数据块(如 5MB/片),通过多次独立请求传输。前端首先使用 File.slice() 方法按偏移量切分文件,生成包含 chunkIndex(分片序号)、totalChunks(总分片数)、fileHash(文件唯一标识,通常由文件名+修改时间或后续计算的哈希值生成)的请求体。为提升效率,前端可采用并发控制策略(如限制同时发起 3-5 个请求),避免打满浏览器连接池。服务端接收分片后,按 fileHash 和 chunkIndex 将临时文件写入磁盘或对象存储,待所有分片到达后触发合并流程,将临时文件按序拼接为完整文件并清理碎片。该设计将大文件传输转化为可控的小批量任务,显著降低单次请求失败的风险,并为后续的断点续传与秒传奠定数据结构基础。
实现断点续传:记录进度与失败恢复
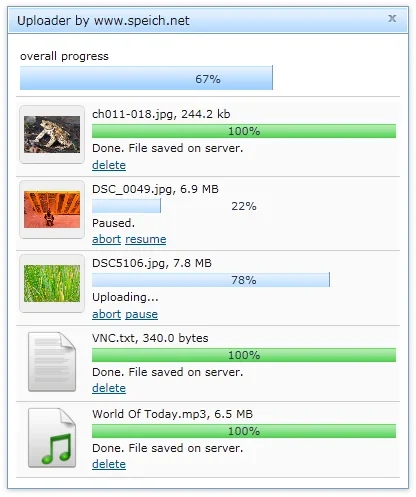
断点续传的本质是状态同步与增量补传。服务端需维护一个分片状态记录表(如 Redis Hash 或数据库记录),以 fileHash 为键,存储已接收的分片索引集合。前端在每次上传任务启动或页面刷新恢复时,必须先调用 /api/upload/status 接口查询当前文件的已传分片列表。获取到服务端返回的已上传索引数组后,前端通过 Array.filter() 过滤掉已完成分片,仅对缺失部分发起上传请求。针对网络中断或浏览器崩溃场景,前端可利用 localStorage 或 IndexedDB 缓存当前任务的 fileHash 与上传进度,页面重载后自动读取并恢复查询。若某分片上传失败(HTTP 状态码非 2xx 或超时),前端应实现指数退避重试机制(如延迟 1s、2s、4s 后重试,最多 3 次)。通过“查询状态-过滤分片-并发补传-失败重试”的闭环,即使经历多次网络抖动或页面刷新,也能精准跳过已传数据,仅补传缺失块,最终完成文件合并。
实现秒传:文件指纹与服务端去重
秒传并非真正的“瞬间传输”,而是基于文件唯一指纹的哈希比对去重机制。其核心流程是:前端在用户选择文件后,立即计算该文件的哈希值(如 MD5 或 SHA-256),并将该值作为 fileHash 上报至服务端。服务端收到请求后,在文件索引库中检索该哈希是否已存在完整记录。若存在,则直接返回“秒传成功”状态,跳过实际分片上传与合并步骤,仅建立用户与已有文件的关联关系;若不存在,则返回“需上传”状态,前端随即启动分片流程。由于大文件全量计算哈希会阻塞主线程并消耗大量内存,前端通常采用 Web Worker 异步计算,或使用 spark-md5 等库进行分片增量哈希累加(即每读取一个分片就更新一次哈希状态,避免一次性加载整个文件)。服务端则需建立高效的哈希索引(如布隆过滤器或 Redis 缓存),确保比对耗时在毫秒级。该方案在网盘、素材库等重复文件高频出现的场景中,可节省 90% 以上的带宽与存储成本。
前后端联调、完整性校验与常见坑
大文件上传的稳定性高度依赖严谨的校验与联调机制。前端在发起合并请求前,需校验本地分片数量是否等于 totalChunks,并核对总分片大小与原始文件 File.size 是否一致。服务端合并完成后,必须对最终文件进行二次校验(如重新计算完整文件的 SHA-256 并与前端上报的 fileHash 比对),确保分片未乱序、未损坏。测试清单应覆盖:正常分片上传、中途断网恢复、刷新页面续传、重复文件秒传、分片乱序到达、合并失败回滚等场景。常见陷阱包括:并发数过高导致服务端连接耗尽(建议前端限制并发 3-5,后端配置连接池);分片重复上传未做幂等处理(服务端需按 fileHash+chunkIndex 做唯一索引);合并时临时文件未清理导致磁盘打满(需设置定时任务清理超时未合并的碎片);跨域请求携带 Cookie 或自定义 Header 被拦截(需正确配置 CORS 及 Access-Control-Allow-Headers);以及未做文件大小与类型白名单校验引发的安全风险。通过全链路日志追踪与自动化测试,可确保方案在生产环境稳定落地。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















