


Python Selenium 批量抓取微信公众号历史文章详解

本文介绍使用 Python Selenium 批量抓取微信公众号历史文章的方法。通过注入 Cookie 保持登录状态,利用 JavaScript 控制滚动加载至底部以获取所有链接,并解析 HTML 提取标题、日期及原创标识,最终将结果保存为 Excel 文件。
参考资源:Selenium WebDriver 添加 Cookie 的方法见 https://www.jb51.net/article/193102.html
需求背景
需求背景:
希望阅读微信公众号的历史文章,但手动查找过往内容较为不便。
解决思路
解决思路:
1、使用 Selenium 打开微信公众号历史文章页面,通过滚动刷新至最底部,从而获取所有历史文章的 URL。
2、遍历这些 URL 进行访问,并将文章内容下载到本地。
具体实现步骤
具体实现步骤:
1、打开微信客户端,进入目标公众号,点击历史文章链接(在浏览器中打开),通过开发者工具获取 Cookies 并保存为 Excel 文件。
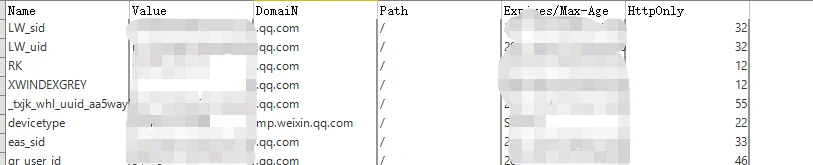
2、启动 WebDriver,并将获取到的相应 Cookies 添加至浏览器中。
browser = webdriver.Chrome()
wait = WebDriverWait(browser,10)
# 随便访问一个地址,然后才能设置cookies
browser.get('https://httpbin.org/get')
# 添加cookies,df为保存的excel cookies
for i in range(len(df)):
  cookie_dict = {
          "domain": df.loc[i,'DomaiN'],
          'name': df.loc[i,'Name'],
          'value': str(df.loc[i,'Value']),
          "expires": df.loc[i,"Expires/Max-Age"],
          'path': '/',}
  browser.add_cookie(cookie_dict)
browser.get(weixin_url)
3、控制浏览器进行滚动操作。
通过观察 page_source,可以判断文章是否已加载至最底部。
<div class="loadmore with_line" style="display: none;" id="js_nomore">
    <div class="tips_wrp">
      <span class="tips js_no_more_msg" style="display: none;">已无更多</span>
      <span class="tips js_need_add_contact" style="display: none;">关注公众帐号,接收更多消息</span>
    </div>
  </div>
使用 driver 执行 JavaScript 代码。
%%time
# 通过判断已无更多的style,来判断是否到最底部,最终执行到最底部
no_more_msg_style = 'display: none;'
while True:
  wait.until(EC.presence_of_element_located((By.XPATH,'//span[@class="tips js_no_more_msg" and text()="已无更多"]')))
  no_more= browser.find_element_by_xpath('//span[@class="tips js_no_more_msg" and text()="已无更多"]')
  now_style = no_more.get_attribute('style')
  if str(now_style).find(no_more_msg_style) == -1:
    # 说明已经加载完了
    break
  else:
    # 停顿一会,等待浏览器加载
    time.sleep(5)
    # 通过JS,执行到最底部
    browser.execute_script('window.scrollTo(0,document.body.scrollHeight)')
4、提取关键信息。
根据 HTML 结构分析,文章 URL 位于 <div msgid="1000000026"> 标签中。
<div class="weui_msg_card js_card" msgid="1000000026">
      <div class="weui_msg_card_hd">2017年1月13日</div>
      <div class="weui_msg_card_bd">
         <!-- 图文 -->
             <!-- 普通图文 -->
            <div id="WXAPPMSG1000000026" class="weui_media_box appmsg js_appmsg" hrefs="http://mp.weixin.qq.com/s?__biz=MzI5MDQ4NzU5MA==&mid=2247483748&idx=1&sn=e804e638484794181a27c094f81be8e1&chksm=ec1e6d2ddb69e43bd3e1f554c2d0cedb37f099252f122cee1ac5052b589b56f428b2c304de8e&scene=38#wechat_redirect" data-t="0">
              <span class="weui_media_hd js_media" style="background-image:url(http://mmbiz.qpic.cn/mmbiz_jpg/XibhQ5tjv6dG9B4GF1C9MGBJO5AR2wvjCL9LgdcFgAdEgyU8wZFuDXoH9O9dNvafwK3RibCjUyiarIlUDlkxbcyfQ/640?wx_fmt=jpeg)" data-s="640" hrefs="http://mp.weixin.qq.com/s?__biz=MzI5MDQ4NzU5MA==&mid=2247483748&idx=1&sn=e804e638484794181a27c094f81be8e1&chksm=ec1e6d2ddb69e43bd3e1f554c2d0cedb37f099252f122cee1ac5052b589b56f428b2c304de8e&scene=38#wechat_redirect" data-type="APPMSG">
              </span>
              <div class="weui_media_bd js_media" data-type="APPMSG">
                <h4 class="weui_media_title" hrefs="http://mp.weixin.qq.com/s?__biz=MzI5MDQ4NzU5MA==&mid=2247483748&idx=1&sn=e804e638484794181a27c094f81be8e1&chksm=ec1e6d2ddb69e43bd3e1f554c2d0cedb37f099252f122cee1ac5052b589b56f428b2c304de8e&scene=38#wechat_redirect">
                  承认自己是难民有什么错
                </h4>
                <p class="weui_media_desc">枷锁已经足够沉重,谢绝道德绑架</p>
                <p class="weui_media_extra_info">2017年1月13日</p>
              </div>
            </div>
      </div>
    </div>
文章类型主要分为:
<div class="weui_media_bd js_media" data-type="APPMSG"> <div class="weui_media_bd js_media" data-type="TEXT">
以及是否标注“原创”进行区分。
最终实现代码:
%%time
result = []
errlist = []
# 先得到其中一个
el_divs = browser.find_elements_by_xpath('//div[@class="weui_msg_card_list"]/div[@class="weui_msg_card js_card"]')
i = 0
for div in el_divs:
  date = title = url = yuanchuang = ''
  try:
    date = div.find_element_by_xpath('.//div[@class="weui_msg_card_hd"]').get_attribute('innerHTML')
    el_content = div.find_element_by_xpath('.//div[@class="weui_media_bd js_media"]')
    if el_content.get_attribute('data-type') == 'APPMSG':
      el = el_content.find_element_by_xpath('./h4[@class="weui_media_title"]')
      title = el.text
      url = el.get_attribute('hrefs')
      xb = el_content.find_element_by_xpath('./p[@class="weui_media_extra_info"]').text
      yuanchuang = '原创' if xb.find('原创') != -1 else ''
    elif el_content.get_attribute('data-type') == 'TEXT':
      title = '随文'
      url = el_content.find_element_by_xpath('./div').text
      yuanchuang = '原创'
    else:
      # 其他未能识别的类型
      errlist.append([i,div.get_attribute('innerHTML')])
  except NoSuchElementException:
    errlist.append([i,div.get_attribute('innerHTML')])
  print(str(i),':',date,title,url,yuanchuang)
  result.append([date,title,yuanchuang,url])
  i = i + 1
5、将获取到的 URL 及相关信息保存到 Excel 文件中。
dfout = pd.DataFrame(result, columns=['日期', '标题', '原创', '地址']) with pd.ExcelWriter(savename) as writer: dfout.to_excel(writer,index=False,sheet_name = 'Sheet1')
最终保存的数据格式示例。
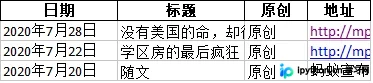
6、遍历最终的链接地址,逐个使用 requests 保存内容,即可得到完整文章。如需构建菜单形式的文章列表,可参考:
记一次 excel vba 参考手册爬虫实战,不必要的一次爬虫:htthttps://www.jb51.net/article/193107.htm
遇到的问题与解决方案
遇到的问题与解决方案:
1、find_element_by_xpath 需配合 NoSuchElementException 使用,否则遇到未找到的节点会报错。最初尝试使用 find_elements_by_xpath 来防止节点缺失,但发现执行速度异常缓慢,需进一步排查原因。
2、Cookies 需手动获取,若长时间未使用需重新获取。可考虑结合 pyautogui 控制微信客户端以自动获取。
3、构建过程中,若未对文章类型做好初步判断,会导致执行时间过长。建议做好异常捕获,再逐步分析错误节点问题。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















