


Python实现基于空间相似度的K-means轨迹聚类:从距离定义到模型优化

本文详细介绍如何利用Python实现基于空间相似度的K-means轨迹聚类。核心内容涵盖从Excel批量读取含经纬度、速度及方向的轨迹数据,定义并计算基于双向Hausdorff距离的多因素欧氏距离矩阵。通过融合空间、速度与方向权重生成综合距离,并采用非随机策略初始化聚类中心以优化结果。最后结合手肘法与SSE确定最佳聚类数,完成轨迹的高效分类与可视化分析。
本文分享轨迹聚类的基本实现方法,重点涉及轨迹距离的定义方式以及K-means聚类算法的具体应用。在开始编码前,需要引入以下Python库以支持数据处理与计算:
import pandas as pd
import numpy as np
import random
import os
import matplotlib.pyplot as plt
import seaborn as sns
from scipy.spatial.distance import cdist
from itertools import combinations
from joblib import Parallel, delayed
from tqdm import tqdm
数据读取
假设原始数据以Excel文件形式存储,每条轨迹对应一个文件,内容包含经纬度、速度及方向等航班信息。我们需要从这些文件中读取数据,并将其整理保存为字典格式以便后续处理。
def get_alldata_path(path):
  all_path = pd.DataFrame(columns=['path_root','path0','path1','path2','path','datalist'])
  path0 = os.listdir(path)
  for path_temp0 in path0:
    path1 = os.listdir(path+path_temp0)
    for path_temp1 in path1:
      path2 = os.listdir(path+path_temp0+'\\'+path_temp1)
      for path_temp2 in path2:
        path3 = os.listdir(path+path_temp0+'\\'+path_temp1+'\\'+path_temp2)
        all_path.loc[all_path.shape[0]] = [path,path_temp0,path_temp1,path_temp2,
                            path+path_temp0+'\\'+path_temp1+'\\'+path_temp2+'\\',
                            path3]
  return all_path
通过上述步骤,我们可以获取所有数据文件的路径列表,这为后续批量读取所需数据提供了便利。
#设置数据根目录
path = 'yourpath'
#获取所有数据地址
data_path = get_alldata_path(path)
接下来执行数据读取操作,将结果保存为字典格式。字典的键(key)为每条轨迹的唯一名称,而值(value)则是包含经纬度等信息的DataFrame对象。
def read_data(data_path,idxs):
   '''
   功能:读取数据
   '''
   data = {}
   for idx in idxs:
     path_idx = data_path['path'][idx]
     for dataname in data_path['datalist'][idx]:
       temp = pd.read_excel(path_idx+dataname,header=None)
       temp = temp.loc[:,[4,5,6,8]]
       temp.replace('none',np.nan,inplace=True)
       temp.replace('Trak',np.nan,inplace=True)
       temp = temp.dropna().astype(float)
       temp.columns = ['GPSLongitude','GPSLatitude','direction','speed']
       data[str(idx)+'_'+dataname] = temp
   return data
从之前获取的路径DataFrame中,筛选出需要进行聚类分析的具体数据文件并读取进来。
#读取你想要的数据
idxs = [0,1,2]
data = read_data(data_path,idxs)
定义不同轨迹之间的空间距离度量标准。
这里采用双向Hausdorff距离(Bidirectional Hausdorff Distance)来衡量轨迹间的空间相似度。给定两条轨迹A和B,其中轨迹A包含n个点,轨迹B包含m个点,它们之间的空间相似距离d定义如下:
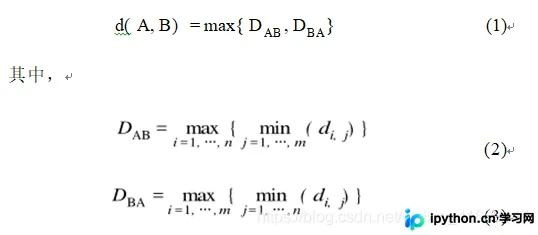
公式中,di,j表示轨迹A上的第i个点到轨迹B上第j个点之间的多因素欧氏距离。可以看出,轨迹A与B越相似,计算出的距离值越小;反之,距离值越大。
def OneWayHausdorffDistance(ptSetA, ptSetB):
  # 计算任意向量之间的距离,假设ptSetA有n个向量,ptSetB有m个向量
  # 得到矩阵C(n行m列)Cij代表A中都第i个向量到B中第j向量都距离
  dist = cdist(ptSetA, ptSetB, metric='euclidean')
  # np.min(dist,axis=1):计算每一行的的最小值
  # 即:固定点集A的值,求点集A中到集合B的最小值
  return np.max(np.min(dist, axis=1))
	# 计算双向的Hausdorff距离=====>H(ptSetA,ptSetB)=max(h(ptSetA,ptSetB),h(ptSetB,ptSetA))
	# ptSetA:输入的第一个点集
	# ptSetB:输入的第二个点集
	# Hausdorff距离度量了两个点集间的最大不匹配程度
def HausdorffDistance(ptSetA, ptSetB):
  # 计算双向的Hausdorff距离距离

  res = np.array([
    OneWayHausdorffDistance(ptSetA, ptSetB),
    OneWayHausdorffDistance(ptSetB, ptSetA)
  ])
  return np.max(res)
计算距离矩阵。
每条轨迹数据均包含经纬度、速度和方向三个维度的信息。我们需要分别计算各维度的距离,然后根据预设的比例系数进行加权求和,从而得到最终的轨迹间距离。
def DistanceMat(data,w=[0.7,0.2,0.1]):
   '''
   功能:计算轨迹段的距离矩阵
   输出:距离矩阵
   '''
   #要计算的组合
   ptCom = list(combinations(list(data.keys()),2))
   #基于轨迹的距离
   distance_tra = Parallel(n_jobs=8,verbose=False)(delayed(HausdorffDistance)(
          data[ptSet1][['GPSLongitude','GPSLatitude']],data[ptSet2][['GPSLongitude','GPSLatitude']]
          ) for ptSet1,ptSet2 in ptCom)
   distancemat_tra = pd.DataFrame(ptCom)
   distancemat_tra['distance'] = distance_tra
   distancemat_tra = distancemat_tra.pivot(index=0,columns=1,values='distance')
   for pt1 in data.keys():
     distancemat_tra.loc[str(pt1),str(pt1)] = 0
   distancemat_tra = distancemat_tra.fillna(0)
   distancemat_tra = distancemat_tra.loc[list(data.keys()),list(data.keys())]
   distancemat_tra = distancemat_tra+distancemat_tra.T

   #基于方向的距离
   distance_speed = Parallel(n_jobs=8,verbose=False)(delayed(HausdorffDistance)(
          data[ptSet1][['speed']],data[ptSet2][['speed']]
          ) for ptSet1,ptSet2 in ptCom)
   distancemat_speed = pd.DataFrame(ptCom)
   distancemat_speed['distance'] = distance_speed
   distancemat_speed = distancemat_speed.pivot(index=0,columns=1,values='distance')
   for pt1 in data.keys():
     distancemat_speed.loc[str(pt1),str(pt1)] = 0
   distancemat_speed = distancemat_speed.fillna(0)
   distancemat_speed = distancemat_speed.loc[list(data.keys()),list(data.keys())]
   distancemat_speed = distancemat_speed+distancemat_speed.T
   #基于方向的距离
   distance_direction = Parallel(n_jobs=8,verbose=False)(delayed(HausdorffDistance)(
          data[ptSet1][['direction']],data[ptSet2][['direction']]
          ) for ptSet1,ptSet2 in ptCom)
   distancemat_direction = pd.DataFrame(ptCom)
   distancemat_direction['distance'] = distance_direction
   distancemat_direction = distancemat_direction.pivot(index=0,columns=1,values='distance')
   for pt1 in data.keys():
     distancemat_direction.loc[str(pt1),str(pt1)] = 0
   distancemat_direction = distancemat_direction.fillna(0)
   distancemat_direction = distancemat_direction.loc[list(data.keys()),list(data.keys())]
   distancemat_direction = distancemat_direction+distancemat_direction.T
   distancemat_tra = (distancemat_tra-distancemat_tra.min().min())/(distancemat_tra.max().max()-distancemat_tra.min().min())
   distancemat_speed = (distancemat_speed-distancemat_speed.min().min())/(distancemat_speed.max().max()-distancemat_speed.min().min())
   distancemat_direction = (distancemat_direction-distancemat_direction.min().min())/(distancemat_direction.max().max()-distancemat_direction.min().min())
   distancemat = w[0]*distancemat_tra+w[1]*distancemat_speed+w[2]*distancemat_direction
   return distancemat
利用前一步读取的数据,计算不同轨迹间的距离矩阵。需要注意的是,该方法的主要缺点在于计算复杂度较高,随着轨迹数量的增加,计算时间会呈指数级增长。
distancemat = DistanceMat(data,w=[0.7,0.2,0.1])
执行K-means聚类。
在获得轨迹间的距离矩阵后,即可进行聚类操作。此处选用K-means算法,为了获得更优的聚类效果,我们对聚类中心的初始选取进行了特殊设计,摒弃了完全随机选择的方式,转而选取彼此距离尽可能远的轨迹点作为初始中心。具体初始化过程如下:首先随机选取一条轨迹作为第一类的中心C1;然后在剩余的L-1个序列中,选取一个序列X2作为第二类的中心C2,并设定一个阈值q,要求C2到C1的距离大于q。
class KMeans:
  def __init__(self,n_clusters=5,Q=74018,max_iter=150):
     self.n_clusters = n_clusters #聚类数
     self.Q = Q
     self.max_iter = max_iter  # 最大迭代数

  def fit(self,distancemat):
     #选择初始中心
     best_c = random.sample(distancemat.columns.tolist(),1)
     for i in range(self.n_clusters-1):
       best_c += random.sample(distancemat.loc[(distancemat[best_c[-1]]>self.Q)&(~distancemat.index.isin(best_c))].index.tolist(),1)
     center_init = distancemat[best_c] #选择最小的样本组合为初始质心
     self._init_center = center_init
     #迭代停止条件
     iter_ = 0
     run = True
     #开始迭代
     while (iter_<self.max_iter)&(run==True):
       #聚类聚类标签更新
       labels_ = np.argmin(center_init.values,axis=1)
       #聚类中心更新
       best_c_ = [distancemat.iloc[labels_== i,labels_==i].sum().idxmin() for i in range(self.n_clusters)]
       center_init_ = distancemat[best_c_]
       #停止条件
       iter_ += 1
       if best_c_ == best_c:
          run = False
       center_init = center_init_.copy()
       best_c = best_c_.copy()
     #记录数据
     self.labels_ = np.argmin(center_init.values,axis=1)
     self.center_tra = center_init.columns.values
     self.num_iter = iter_
     self.sse = sum([sum(center_init.iloc[self.labels_==i,i]) for i in range(self.n_clusters)])
应用聚类算法,通过计算平方误差和(SSE)并结合手肘法(Elbow Method)来确定最佳的聚类数量,最终使用确定的最佳聚类数构建聚类模型。
 #聚类,保存不同的sse
SSE = []
for i in range(2,30):
 kmeans = KMeans(n_clusters=i,Q=0.01,max_iter=150)
 kmeans.fit(distancemat)
 SSE.append(kmeans.sse)
#画图
plt.figure(0)
plt.plot(SSE)
plt.show()

#使用最好的结果进行聚类
n_clusters=12
kmeans = KMeans(n_clusters=n_clusters,Q=0.01,max_iter=150)
kmeans.fit(distancemat)
kmeans.sse #输出sse
kmeans.labels_ #输出标签
kmeans.center_tra #输出聚类中心

#画图,不同类的轨迹使用不同的颜色
plt.figure(1)
for i in range(n_clusters):
  for name in distancemat.columns[kmeans.labels_==i]:
    plt.plot(data[name].loc[:,'GPSLongitude'],data[name].loc[:,'GPSLatitude'],c=sns.xkcd_rgb[list(sns.xkcd_rgb.keys())[i]])
plt.show()

#保存每一个轨迹属于哪一类
kmeans_result = pd.DataFrame(columns=['label','id'])
for i in range(n_clusters):
  kmeans_result.loc[i] = [i,distancemat.columns[kmeans.labels_==i].tolist()]
至此,关于Python基于空间相似度的K-means轨迹聚类实现的介绍已完成。如需了解更多相关Python K-means轨迹聚类内容,建议搜索本站历史文章或继续浏览后续相关文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















