


Python实战:利用requests库登录豆瓣并爬取影评生成词云

本文详解如何使用Python的requests库实现豆瓣登录及会话状态保持,通过Session对象自动管理Cookie,进而批量抓取《荒野生存》影评数据。结合正则表达式提取内容,利用结巴分词与词云库进行数据分析,完整展示从登录接口分析到数据可视化的全流程。
Cookie技术源于交互式Web的需求,主要服务于三个核心场景:
- 会话状态管理,例如记录用户登录状态、购物车内容、游戏进度或其他需要持久化的信息。
- 个性化设置,包括用户自定义偏好、主题风格等配置。
- 浏览器行为跟踪,用于分析和追踪用户的行为路径。
本文将通过requests库登录豆瓣并抓取影评的实际案例,具体演示如何利用代码实现Cookie的会话状态管理(即登录保持)功能。
本教程仅供学习研究使用,严禁用于任何商业获利目的。若内容侵犯任何公司权益,请联系删除。
一、需求背景
此前曾介绍过爬取优酷弹幕并生成词云的方法,但发现优酷弹幕中充斥着大量介词及无效词汇(如“哈哈”、“啊啊”、“这些”、“那些”等),质量参差不齐。相比之下,豆瓣影评口碑较好,书籍与电影推荐具有较高的参考价值。因此,本次尝试爬取豆瓣影评并生成词云,以观察实际效果。
二、功能描述
整体流程包括:使用requests库登录豆瓣、抓取影评数据,最后生成词云进行展示。
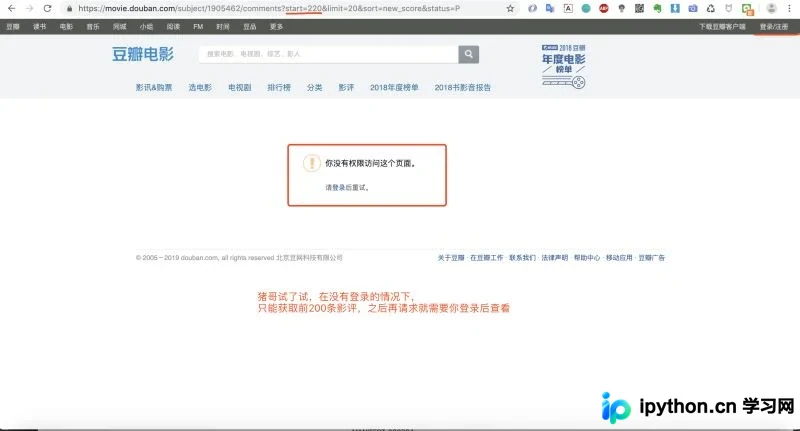
为何此前案例(如京东、优酷)无需登录,而豆瓣必须登录?原因在于豆瓣在未登录状态下仅允许查看前200条影评,后续内容需登录才能访问,这属于一种反爬策略。
三、技术方案
整体技术方案可划分为三个主要步骤:
- 分析豆瓣登录接口,利用requests库完成登录并保存Cookie。
- 分析豆瓣影评接口,实现数据的批量抓取。
- 使用词云工具对影评数据进行可视化分析。
方案确定后,接下来进行实际操作。
四、登录豆瓣
开发爬虫时,首先通过浏览器调试窗口分析URL。
1.分析豆瓣登录接口
打开登录页面,调出调试窗口,输入用户名和密码后点击登录。
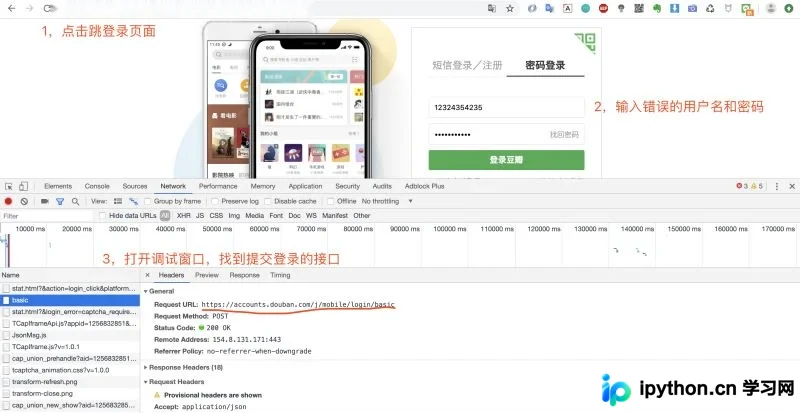
建议输入错误密码,以避免页面跳转导致无法捕获请求。通过上述操作,获取到登录请求的URL:https://accounts.douban.com/j/mobile/login/basic。
由于这是一个POST请求,还需查看请求携带的参数,向下滚动调试窗口查看Form Data部分。
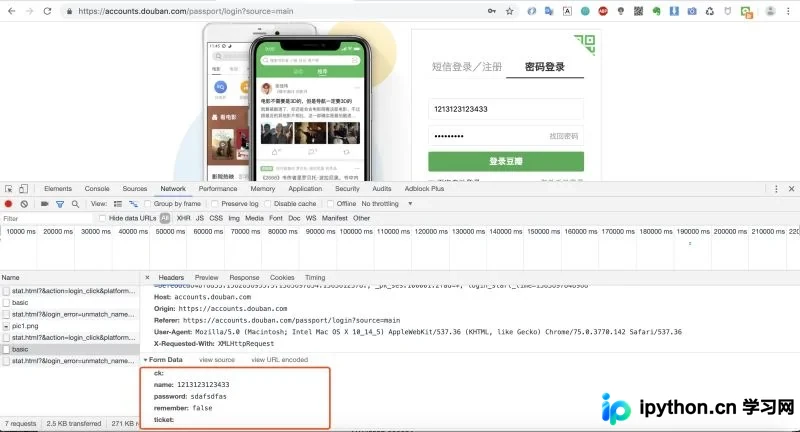
2.代码实现登录豆瓣
获取登录URL和参数后,即可使用requests库编写登录功能代码。
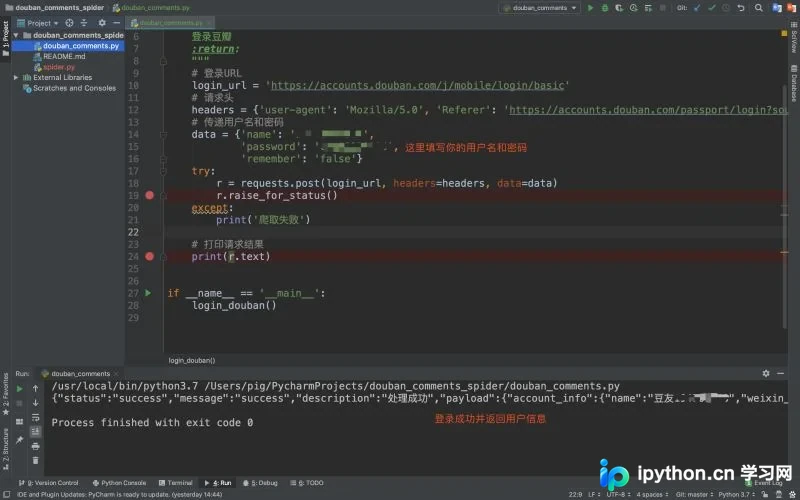
3.保存会话状态
在之前的优酷弹幕案例中,我们是手动复制浏览器中的Cookie到请求头中以保存会话状态。现在探讨如何让代码自动保存Cookie。
您可能见过或使用过urllib库,其保存Cookie的方式如下:
cookie = http.cookiejar.CookieJar()
handler = urllib.request.HttpCookieProcessor(cookie)
opener = urllib.request.build_opener(handler)
opener(url)
但在前文介绍requests库时已提及:
requests库是基于urllib/3构建的第三方网络库,具有功能强大、API优雅的特点。从上图可见,Python官方文档推荐在HTTP客户端开发中使用requests库,且在实际工作中该库使用频率极高。
因此,本文将展示requests库如何优雅地自动保存Cookie。我们对代码进行微调,使其能自动保存Cookie以维持会话状态。
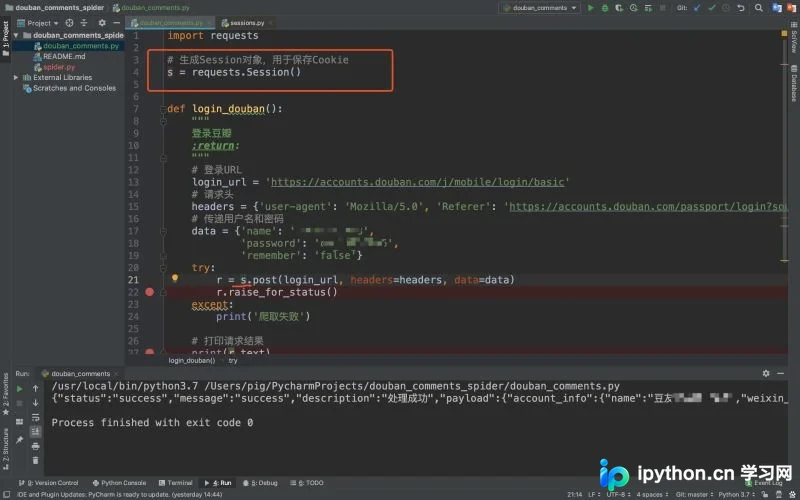
上述代码中,主要进行了两处修改:
- 在代码顶部增加一行
s = requests.Session(),用于生成Session对象以保存Cookie。 - 发起请求的对象由原来的requests改为Session对象。
可以看到,发起请求的对象变为了session对象。它与原requests对象发起请求的方式一致,但每次请求会自动携带Cookie,因此后续均使用Session对象发起请求。
4.这个Session对象是我们常说的session吗?
至此,可能有读者疑问:requests.Session对象是否等同于我们常说的session?
答案是否定的。我们常说的session保存在服务端,而requests.Session对象仅是一个用于保存Cookie的客户端对象。可查看其源码说明。
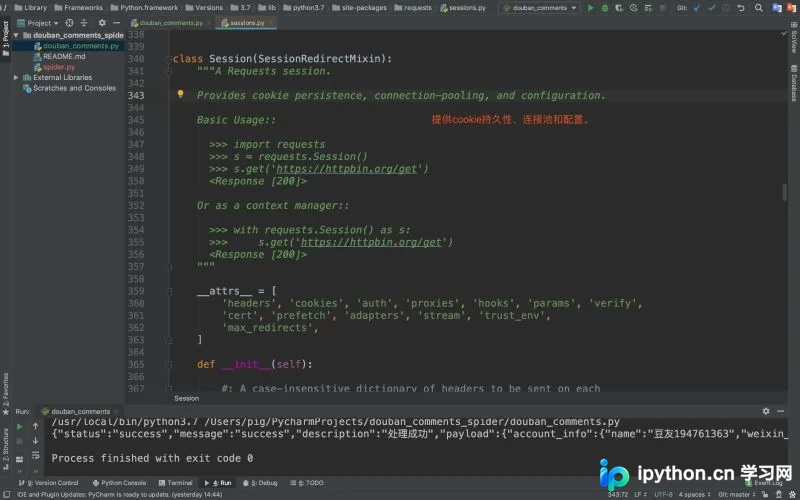
因此,请勿将requests.Session对象与session技术混淆。
五、爬取影评
实现登录和会话状态保持后,即可开始核心任务。
1.分析豆瓣影评接口
首先在豆瓣中找到目标电影,此处选择美国电影《荒野生存》,因为这是作者心中的最佳影片。
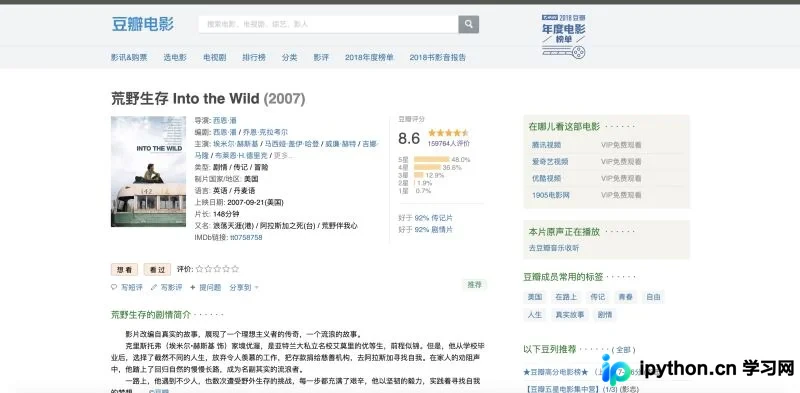
然后下拉找到影评区域,调出调试窗口,定位加载影评的URL。
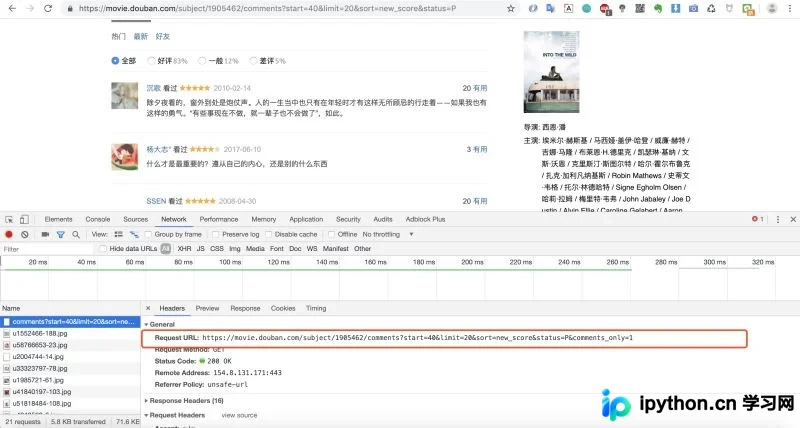
2.爬取一条影评数据
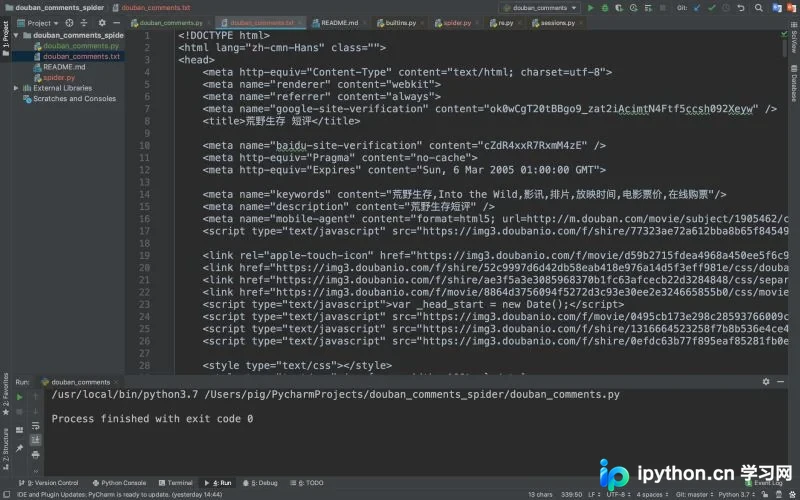
爬取返回的是HTML网页数据,需要从中提取影评内容。
3.影评内容提取
从上图可知,爬取返回的是HTML,影评数据嵌套在HTML标签中。如何提取影评内容?
此处使用正则表达式匹配目标标签内容。虽然有更高级的方法(如使用bs4、xpath等库解析HTML,且效率更高),但这属于后续内容,今天仅使用正则匹配。
首先分析返回HTML的网页结构。
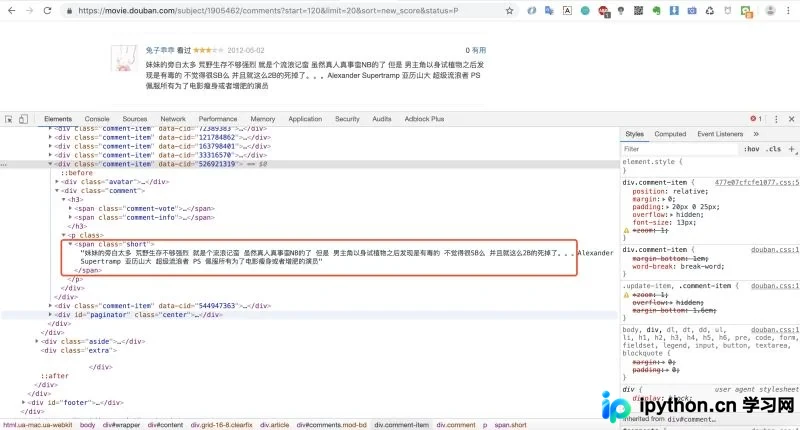
发现影评内容均位于<span class="short"></span>标签内,因此可编写正则表达式匹配该标签内的内容。
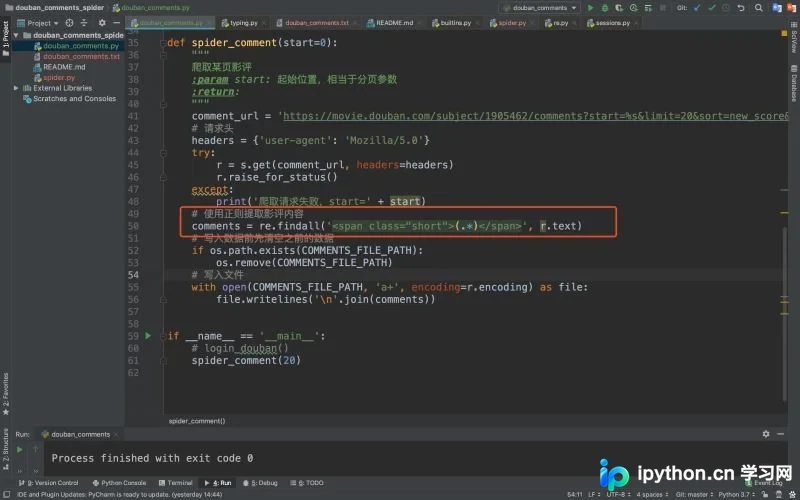
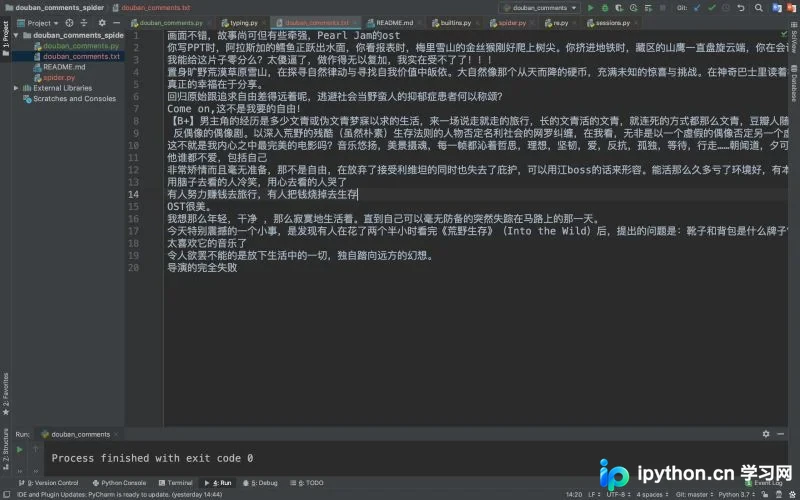
检查提取的内容是否正确。
4.批量爬取
完成单条数据的爬取、提取和保存后,进行批量爬取。根据以往经验,批量爬取的关键在于找到分页参数。很快可以发现URL中的start参数控制分页。
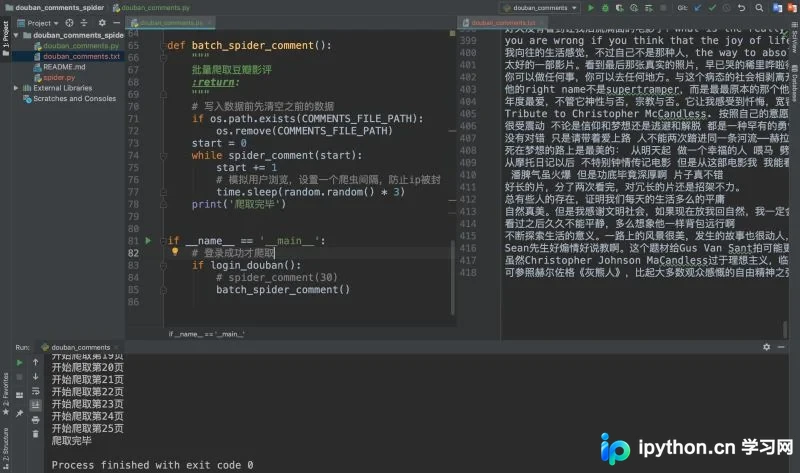
此处仅爬取了25页数据。可前往浏览器验证是否确实只有25页,经作者验证,确实如此。
六、分析影评
数据抓取完成后,使用词云分析该电影。
鉴于前文已介绍过两个词云分析案例,此处仅简要讲解。
1.使用结巴分词
由于下载的影评是分段文字,而词云需统计单词出现次数,因此需先进行分词处理。
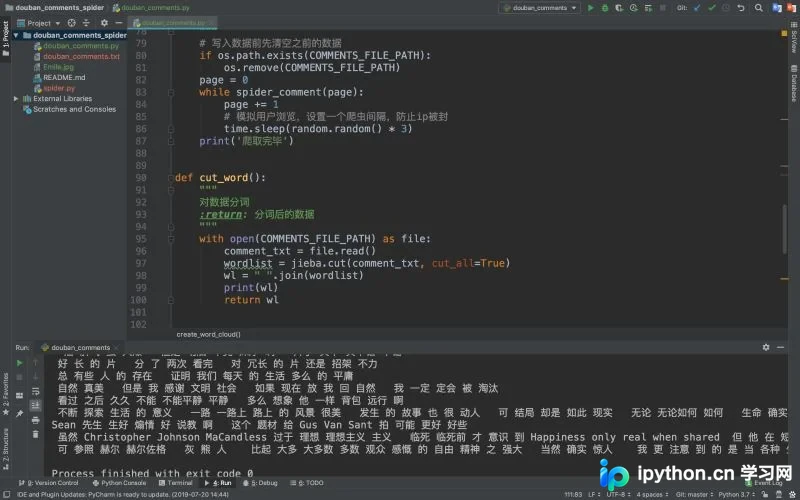
2.使用词云分析
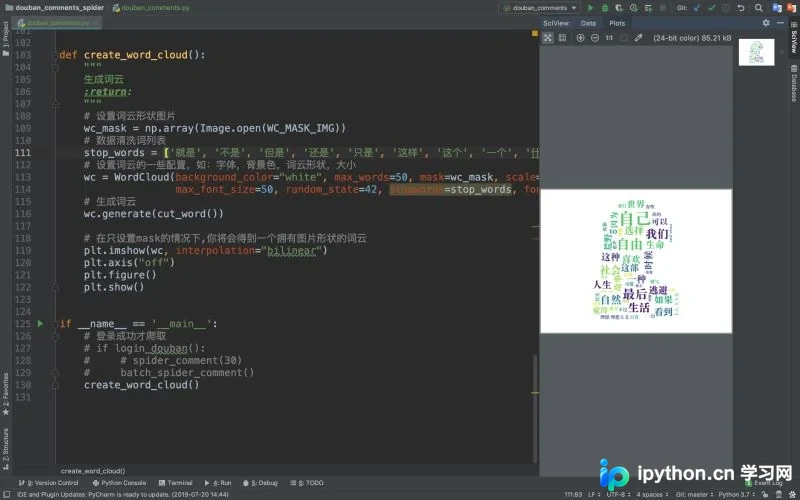
最终成果展示:
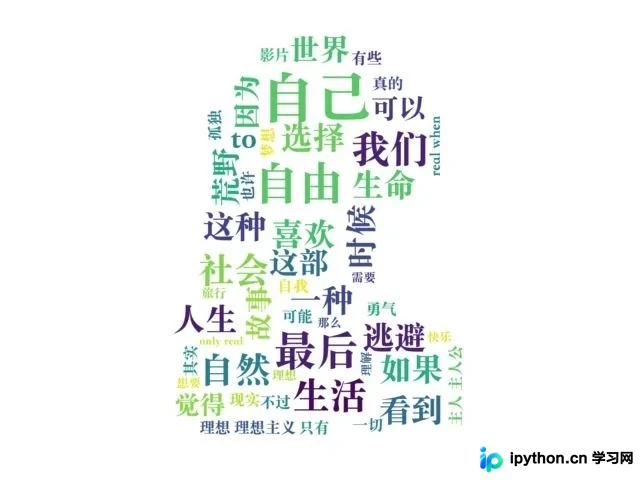
从词云可以看出,这是一部关于追寻自我与现实生活的电影,作者强烈推荐。
七、总结
本次以爬取豆瓣为例,学习了以下内容:
- 学习如何使用requests库发起POST请求。
- 学习如何使用requests库登录网站。
- 学习如何使用requests库的Session对象保持会话状态。
- 学习如何使用正则表达式提取网页标签中的内容。
受篇幅限制,爬虫过程中的许多细节和技巧未完全展开,希望大家能动手实践。
源码地址:https://github.com/pig6/douban_comments_spider
至此,关于详解如何用Python登录豆瓣并爬取影评的文章介绍完毕。更多Python爬取影评相关内容,请搜索本站往期文章或继续浏览相关文章。希望大家今后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















