


Apriori关联规则算法详解:从核心概念到Python实战应用

本文深入解析Apriori关联规则算法的核心概念,包括支持度、置信度和提升度的计算逻辑及其业务意义。通过啤酒与尿布、股票预测及风控策略等案例,展示算法在数据挖掘中的实际应用。最后提供基于Python efficient-apriori库的完整代码示例,演示如何挖掘频繁项集与关联规则,帮助读者掌握这一经典数据挖掘工具。
一、关联规则概述
1993年,Agrawal等人首次提出关联规则概念,至今已有近30年历史。在各类算法层出不穷的今天,这属于较为早期的经典理论,甚至比许多从业者的年龄还要大。作为数据挖掘的入门算法,其研究深度往往不足,尤其在风控领域,它拥有极高的应用潜力,却常被低估,公开深入探讨的文章较少。本文尝试逐一剖析,希望能带来启发。
笔者对此进行了较为深入且全面的思考,并开展了大量实验,该话题值得深入探讨。世事虽变,但事物间的关联本质未变,无论有意无意,关联始终存在。
例如,若观察到某人低头玩手指且保持沉默,大概率表明其生气,这便是总结出的规则。经典的“啤酒与尿布”案例广为人知:超市将这两种看似无关的商品摆放在一起,结果销量大幅上升。原因在于美国妇女在丈夫回家前购买尿布,丈夫顺手购买啤酒,从而促成了这一有趣现象。
许多人仅记住了啤酒与尿布的案例,却鲜少深入思考。实际上,日常生活中存在大量类似的关联规则。
二、应用场景举例
1、股票涨跌预测
若历史数据挖掘显示“放量+高换手率”的股票大概率上涨,则可挖掘当日满足该条件的个股,并于次日买入,从而获取收益。
2、视频、音乐、图书等推荐
若历史数据显示大量用户观看顺序为《小时代》后接《上海堡垒》,则对新观看《小时代》的用户推荐《上海堡垒》,其被观看的概率将显著增加。
3、打车路线预测(考虑时空)
通过大量数据挖掘得出以下规律:
早上时段:起点家 -> 目的地公司;
晚上时段:起点家 -> 目的地高铁站;
周末时段:起点家 -> 目的地购物中心。
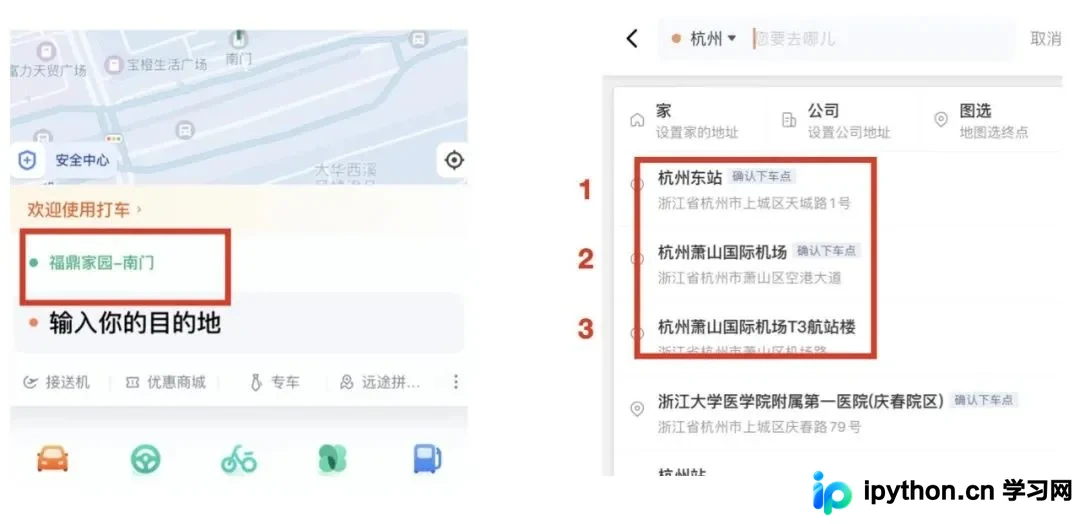
因此,当用户每天早晨打开软件时,打车软件会推荐公司地址作为目的地,从而大幅缩短用户打车时间。如输入小区名称,系统立即推荐三个地点,其中杭州东站排在首位,因为该组合的支持度最高。
4、风控策略自动化挖掘
根据历史标题总结规律,若商品标题包含“老司机+百度网盘”,则判定为色情风险高,后续遇到此类标题直接拒绝。
根据历史行为数据,若发现“沉默用户+异地登录+修改密码”的组合大概率导致盗号,则对新账户满足这三项条件时立即冻结账户或进行实人认证,以规避盗号风险。
根据历史数据,若发现用户A与用户B每天相隔10秒登录,则可认为两者存在关联,可能是机器控制的同一批薅羊毛账户。
风控策略的自动化挖掘是我们后续重点关注和讲解的内容。
三、3个最重要的概念
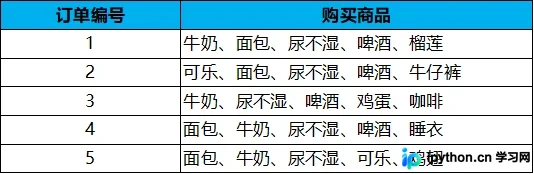
理解关联规则需掌握三个核心概念:支持度、置信度和提升度。以下通过经典的啤酒-尿布案例进行说明,假设以下是几名客户购买订单的商品列表:
1、支持度
支持度 (Support):指某个商品组合出现的次数与总订单数之间的比例。
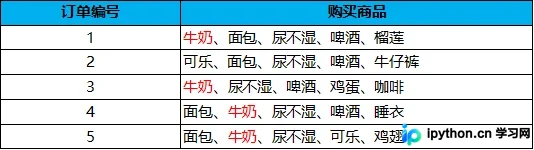
在此例中,“牛奶”出现了4次,因此这5笔订单中“牛奶”的支持度为4/5=0.8。
同样,“牛奶+面包”出现了3次,因此这5笔订单中“牛奶+面包”的支持度为3/5=0.6。
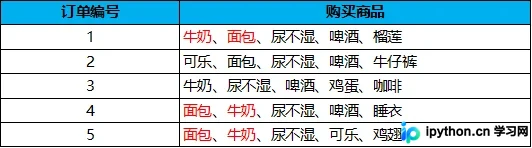
这样理解是否简单?大家可以动手计算一下“尿不湿+啤酒”的支持度是多少?
2、置信度
置信度 (Confidence):指购买了商品A时,购买商品B的概率,即在包含A的子集中,B的支持度,也就是包含B的订单比例。
置信度(牛奶→啤酒)= 3/4=0.75,代表购买了牛奶的订单中,还有多少订单购买了啤酒,如下表所示。
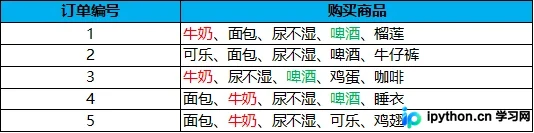
置信度(啤酒→牛奶)= 3/4=0.75,代表如果你购买了啤酒,有多大的概率会购买牛奶?
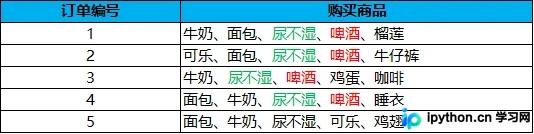
置信度(啤酒→尿不湿)= 4/4=1.0,代表如果你购买了啤酒,有多大的概率会买尿不湿,下表显示为100%。
由上述例子可知,置信度本质上是条件概念,即在A发生的情况下,B发生的概率。仅知这两个概念往往不够,还需引入提升度。例如A出现时B出现的概率为80%,但若B在大盘中的比例本就为95%,则A的出现反而降低了B出现的概率。
3、提升度
提升度 (Lift):在商品推荐或风控策略中,重点考虑提升度,因为它代表A的出现对B出现概率的提升程度。
提升度 (A→B) = 置信度 (A→B) / 支持度 (B)。
因此提升度有三种可能:
提升度 (A→B)>1:代表有提升;
提升度 (A→B)=1:代表无提升,也无下降;
提升度 (A→B)<1:代表有下降。
提升度 (啤酒→尿不湿) = 置信度 (啤酒→尿不湿) / 支持度 (尿不湿) = 1.0/0.8 = 1.25,可见啤酒对尿不湿有提升作用,提升度为1.25,大于1。
可简单理解为:在全集中,尿不湿的概率为80%,而在包含啤酒的子集中,尿不湿的概率为100%。因此,子集的限定提高了尿不湿的概率,即啤酒的出现提升了尿不湿的销售概率。
4、频繁项集
频繁项集(frequent itemset):即支持度大于等于最小支持度 (Min Support) 阈值的项集。小于最小支持度的为非频繁项集,大于等于的为频繁项集,项集可以是单个商品或组合。
频繁集挖掘的最大难题是项集的组合爆炸,如下图所示:
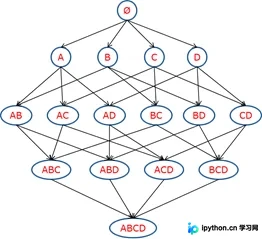
随着商品数量增多,网络规模将变得极其庞大,传统统计计算方法难以应对。为解决此问题,Apriori算法提出两个核心思想:
某个项集是频繁的,那么它的所有子集也是频繁的 {Milk, Bread, Coke} 是频繁的 → {Milk, Coke} 是频繁的。
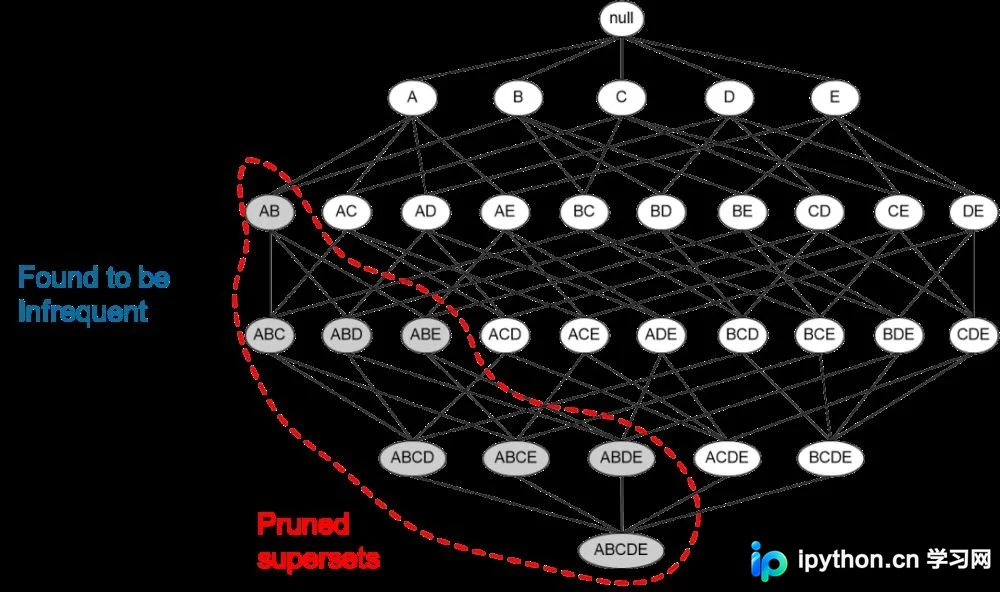
如果一个项集是非频繁项集,那么它的所有超集也是非频繁项集 {Battery} 是非频繁的 → {Milk, Battery} 也非频繁。
如下图中,若已知B不频繁,则所有绿色项集均不频繁,搜索时需避开这些项集,从而减少计算开销。
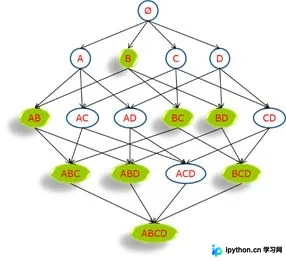
同理,若{A,B}项集是非频繁的,则虚线框后的部分无需计算。运用Apriori算法思想,可去除大量非频繁项集,大大简化计算量。当然,面对大规模数据时,此排除法仍可能不足,于是还有FP-Growth(频繁模式增长树)等更高效方法,后续有机会再讲。
需要注意的是:
1)如果支持度和置信度阈值过高,虽然能在一定程度上减少数据挖掘时间,但一些隐含在数据中的非频繁特征项容易被忽略,难以发现足够有用的规则;
2)如果支持度和置信度阈值过低,可能会导致大量冗余和无效规则产生,导致较大计算量负荷。
四、Python算法介绍
此处以Python为例,使用的包是apriori。当然,R语言等其他语言也有对应的算法包,原理相同,大家可自行试验。
#包安装 我们使用efficient-apriori,python中也可以利用apyori库和mlxtend库
pip install efficient-apriori

#加载包
from efficient_apriori import apriori
‘'‘
apriori(transactions: typing.Iterable[typing.Union[set, tuple, list]],
        min_support: float=0.5,
        min_confidence: float=0.5,
        max_length: int=8,
        verbosity: int=0,
        output_transaction_ids: bool=False)
上面就是这个函数的参数
min_support:最小支持度
min_confidence:最小置信度
max_length:项集长度
# 构造数据集
data = [('牛奶','面包','尿不湿','啤酒','榴莲'),
        ('可乐','面包','尿不湿','啤酒','牛仔裤'),
        ('牛奶','尿不湿','啤酒','鸡蛋','咖啡'),
        ('面包','牛奶','尿不湿','啤酒','睡衣'),
        ('面包','牛奶','尿不湿','可乐','鸡翅')]
#挖掘频繁项集和频繁规则
itemsets, rules = apriori(data, min_support=0.6,  min_confidence=1)
#频繁项集
print(itemsets)
{1: {('啤酒',): 4, ('尿不湿',): 5, ('牛奶',): 4, ('面包',): 4},
2: {('啤酒', '尿不湿'): 4, ('啤酒', '牛奶'): 3, ('啤酒', '面包'): 3, ('尿不湿', '牛奶'): 4, ('尿不湿', '面包'): 4, ('牛奶', '面包'): 3},
3: {('啤酒', '尿不湿', '牛奶'): 3, ('啤酒', '尿不湿', '面包'): 3, ('尿不湿', '牛奶', '面包'): 3}}
itemsets[1] #满足条件的一元组合
{('啤酒',): 4, ('尿不湿',): 5, ('牛奶',): 4, ('面包',): 4}
itemsets[2]#满足条件的二元组合
{('啤酒', '尿不湿'): 4,('啤酒', '牛奶'): 3,('啤酒', '面包'): 3,('尿不湿', '牛奶'): 4,('尿不湿', '面包'): 4,('牛奶', '面包'): 3}
itemsets[3]#满足条件的三元组合
{('啤酒', '尿不湿', '牛奶'): 3, ('啤酒', '尿不湿', '面包'): 3, ('尿不湿', '牛奶', '面包'): 3}
#频繁规则
print(rules)
[{啤酒} -> {尿不湿}, {牛奶} -> {尿不湿},
{面包} -> {尿不湿}, {啤酒, 牛奶} -> {尿不湿},
{啤酒, 面包} -> {尿不湿}, {牛奶, 面包} -> {尿不湿}]
#我们把max_length=2这个参数加进去看看
itemsets, rules = apriori(data, min_support=0.6,
min_confidence=0.5,
max_length=2)
{1: {('牛奶',): 4, ('面包',): 4, ('尿不湿',): 5, ('啤酒',): 4, ('R',): 4},
2: {('R', '啤酒'): 4, ('R', '尿不湿'): 4, ('R', '牛奶'): 3, ('R', '面包'): 3, ('啤酒', '尿不湿'): 4, ('啤酒', '牛奶'): 3, ('啤酒', '面包'): 3, ('尿不湿', '牛奶'): 4, ('尿不湿', '面包'): 4, ('牛奶', '面包'): 3}}
#通过这个数据我们可以看到,项集的长度只包含有两个项了
五、挖掘实例
每位导演都有偏好,如周星驰有星女郎,张艺谋有谋女郎,且巩俐常出现在张艺谋电影中,因此每位导演对演员选择均有偏爱。以宁浩导演为例,分析其选角偏好。因未找到公开数据集,手动整理部分数据,大致如下,因数据较多,故简化后进行分析。
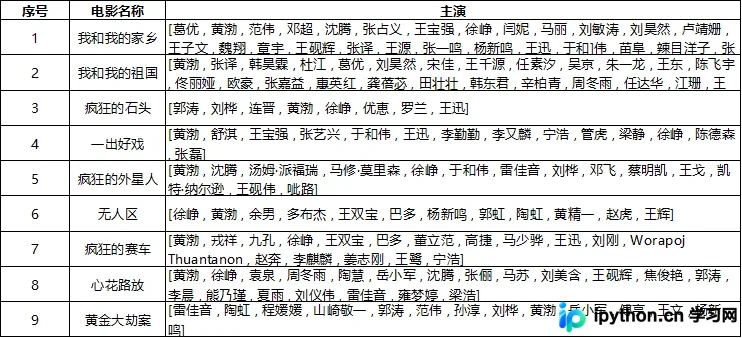
可见,我们共整理了9部电影,计算支持度时,总数即为9。
#把电影数据转换成列表 data = [['葛优','黄渤','范伟','邓超','沈腾','张占义','王宝强','徐峥','闫妮','马丽'], ['黄渤','张译','韩昊霖','杜江','葛优','刘昊然','宋佳','王千源','任素汐','吴京'], ['郭涛','刘桦','连晋','黄渤','徐峥','优恵','罗兰','王迅'], ['黄渤','舒淇','王宝强','张艺兴','于和伟','王迅','李勤勤','李又麟','宁浩','管虎','梁静','徐峥','陈德森','张磊'], ['黄渤','沈腾','汤姆·派福瑞','马修·莫里森','徐峥','于和伟','雷佳音','刘桦','邓飞','蔡明凯','王戈','凯特·纳尔逊','王砚伟','呲路'], ['徐峥','黄渤','余男','多布杰','王双宝','巴多','杨新鸣','郭虹','陶虹','黄精一','赵虎','王辉'], ['黄渤','戎祥','九孔','徐峥','王双宝','巴多','董立范','高捷','马少骅','王迅','刘刚','WorapojThuantanon','赵奔','李麒麟','姜志刚','王鹭','宁浩'], ['黄渤','徐峥','袁泉','周冬雨','陶慧','岳小军','沈腾','张俪','马苏','刘美含','王砚辉','焦俊艳','郭涛'], ['雷佳音','陶虹','程媛媛','山崎敬一','郭涛','范伟','孙淳','刘桦','黄渤','岳小军','傅亨','王文','杨新鸣']] #算法应用 itemsets, rules = apriori(data, min_support=0.5, min_confidence=1) print(itemsets) {1: {('徐峥',): 7, ('黄渤',): 9}, 2: {('徐峥', '黄渤'): 7}} print(rules) [{徐峥} -> {黄渤}]
通过上述分析可以看出:
在宁浩的电影中,使用最多的是黄渤和徐峥。黄渤出现9次,支持度100%;徐峥出现7次,支持度78%。('徐峥', '黄渤')同时出现7次,置信度为100%。看来有徐峥必有黄渤,这真是宁浩必请的黄金搭档,且是一对好基友。
当然,该数据量较小,肉眼即可看出结果。此处仅提供一个分析案例和基础方法,以巩固基础知识,算是开胃菜。对于大规模数据,人眼无法直接感知时,算法的挖掘与发现显得尤为重要,后续将陆续推出相关文章。
到此这篇关于基于Python代码实现Apriori 关联规则算法的文章就介绍到这了,更多相关python关联规则算法内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















