


Python实现共现矩阵可视化与代码详解

本文详细解析Python中如何构建共现矩阵并进行可视化。通过jieba分词提取关键词,利用二维数组统计词对共同出现次数,生成对称矩阵。文章提供了完整的Python代码实现,包括矩阵构建、清洗及占比计算,帮助开发者理解词组亲密度分析原理。
Python共现矩阵实现
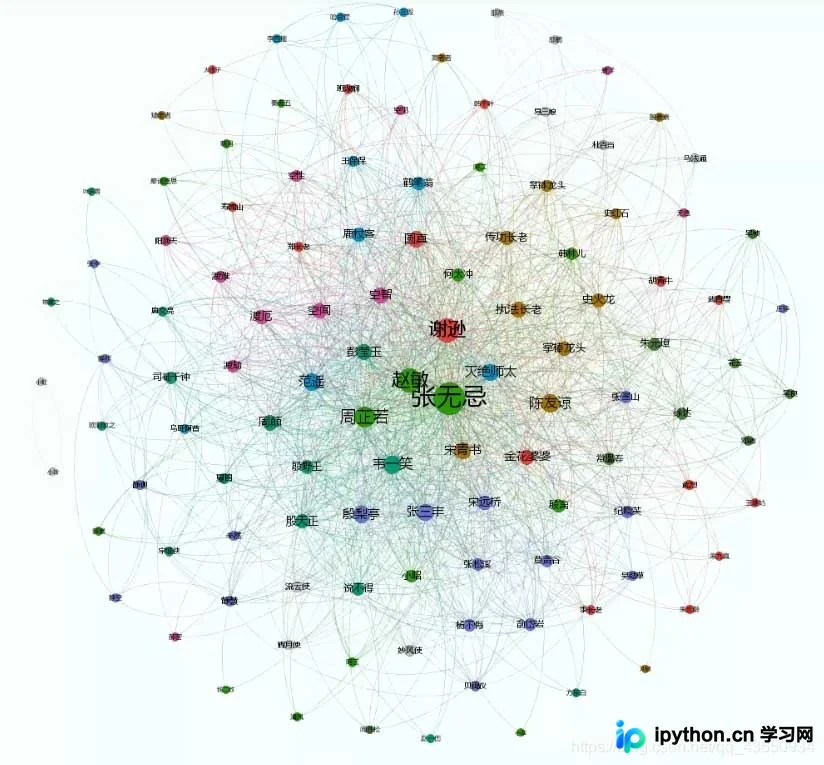
近期在探索Python词库可视化技术时,发现基于共现矩阵生成的图表效果显著,因此决定进行复现与学习。
项目背景
本实践通过爬虫程序采集各大博客网站的文章内容,使用jieba库进行分词处理以提取每篇文章的关键词,随后对这些关键词进行共现矩阵的可视化展示。
什么是共现矩阵
假设存在以下两个句子:
ls = ['我永远喜欢三上悠亚', '三上悠亚又出新作了']在jieba分词处理后,结果如下:
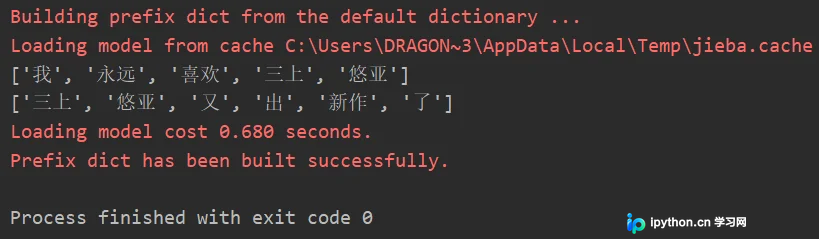
基于上述分词结果,可以构建关键词共现矩阵:
['',    '我', '永远', '喜欢', '三上', '悠亚', '又', '出', '新作', '了']
['我',    0,      1,     1,     1,    1,    0,    0,      0,     0]
['永远',  1,      0,     1,      1,    1,    0,    0,     0,     0]
['喜欢'   1,      1,     0,      1,    1,    0,    0,     0,     0]
['三上',  1,      1,     1,      0,    1,    1,    1,     1,     1]
['悠亚',  1,      1,     1,      1,    0,    1,    1,     1,     1]
['又',    0,      0,     0,      1,    1,    0,    1,     1,     1]
['出',    0,      0,     0,      1,    1,    1,    0,     1,     1]
['新作',  0,      0,     0,      1,    1,    1,    1,     0,     1]
['了',    0,      0,     0,      1,    1,    1,    1,     1,     0]]
具体解释为:在句子“我永远喜欢三上悠亚”中,“我”与“永远”共同出现了一次,因此在共现矩阵对应的[i][j]和[j][i]位置数值加1,其他词对依此类推。
基于上述逻辑,共现矩阵具有以下特征:
- 共现矩阵的[0][0]位置为空。
- 共现矩阵的第一行和第一列用于存放关键词。
- 矩阵对角线上的元素全为0。
- 共现矩阵本质上是一个对称矩阵。
在实际操作中,需对关键词进行清洗处理,以确保可视化结果的清晰与准确。
共现矩阵的构建思路
- 获取每篇文章关键词组成的二维数组data_array。
- 收集所有出现的关键词集合set_word。
- 建立长度为关键词数量加1的矩阵matrix。
- 将矩阵的第一行与第一列赋值为关键词。
- 设置矩阵对角线元素为0。
- 遍历formated_data,将取出的行关键词与列关键词进行组合,若共现则对应位置数值加1。
共现矩阵的代码实现
# coding:utf-8
import numpy as np
import pandas as pd
import jieba.analyse
import os
# 获取关键词
def Get_file_keywords(dir):
    data_array = []  # 每篇文章关键词的二维数组
    set_word = []  # 所有关键词的集合
    try:
        fo = open('dic_test.txt', 'w+', encoding='UTF-8')
        # keywords = fo.read()
        for home, dirs, files in os.walk(dir):  # 遍历文件夹下的每篇文章
            for filename in files:
                fullname = os.path.join(home, filename)
                f = open(fullname, 'r', encoding='UTF-8')
                sentence = f.read()
                words = " ".join(jieba.analyse.extract_tags(sentence=sentence, topK=30, withWeight=False,
                                                            allowPOS=('n')))  # TF-IDF分词
                words = words.split(' ')
                data_array.append(words)
                for word in words:
                    if word not in set_word:
                        set_word.append(word)
        set_word = list(set(set_word))  # 所有关键词的集合
        return data_array, set_word
    except Exception as reason:
        print('出现错误:', reason)
        return data_array, set_word
# 初始化矩阵
def build_matirx(set_word):
    edge = len(set_word) + 1  # 建立矩阵,矩阵的高度和宽度为关键词集合的长度+1
    '''matrix = np.zeros((edge, edge), dtype=str)'''  # 另一种初始化方法
    matrix = [['' for j in range(edge)] for i in range(edge)]  # 初始化矩阵
    matrix[0][1:] = np.array(set_word)
    matrix = list(map(list, zip(*matrix)))
    matrix[0][1:] = np.array(set_word)  # 赋值矩阵的第一行与第一列
    return matrix
# 计算各个关键词的共现次数
def count_matrix(matrix, formated_data):
    for row in range(1, len(matrix)):
        # 遍历矩阵第一行,跳过下标为0的元素
        for col in range(1, len(matrix)):
            # 遍历矩阵第一列,跳过下标为0的元素
            # 实际上就是为了跳过matrix中下标为[0][0]的元素,因为[0][0]为空,不为关键词
            if matrix[0][row] == matrix[col][0]:
                # 如果取出的行关键词和取出的列关键词相同,则其对应的共现次数为0,即矩阵对角线为0
                matrix[col][row] = str(0)
            else:
                counter = 0  # 初始化计数器
                for ech in formated_data:
                    # 遍历格式化后的原始数据,让取出的行关键词和取出的列关键词进行组合,
                    # 再放到每条原始数据中查询
                    if matrix[0][row] in ech and matrix[col][0] in ech:
                        counter += 1
                    else:
                        continue
                matrix[col][row] = str(counter)
    return matrix
def main():
    formated_data, set_word = Get_file_keywords(r'D:\untitled\test')
    print(set_word)
    print(formated_data)
    matrix = build_matirx(set_word)
    matrix = count_matrix(matrix, formated_data)
    data1 = pd.DataFrame(matrix)
    data1.to_csv('data.csv', index=0, columns=None, encoding='utf_8_sig')
main()
共现矩阵(共词矩阵)计算
共现矩阵(共词矩阵)
该过程统计文本中两两词组共同出现的次数,以此描述词组间的亲密度。
代码实现(此处对角线元素表示该字段在文本中出现的总次数):
import pandas as pd
def gx_matrix(vol_li):
    # 整合一下,输入是df列,输出直接是矩阵
    names = locals()
    all_col0 = []   # 用来后续求所有字段的集合
    for row in vol_li:
        all_col0 += row
	    for each in row:  # 对每行的元素进行处理,存在该字段字典的话,再进行后续判断,否则创造该字段字典
	        try:
	            for each1 in row:  # 对已存在字典,循环该行每个元素,存在则在已有次数上加一,第一次出现创建键值对“字段:1”
	                try:
	                    names['dic_' + each][each1] = names['dic_' + each][each1] + 1  # 尝试,一起出现过的话,直接加1
	                except:
	                    names['dic_' + each][each1] = 1  # 没有的话,第一次加1
	        except:
	            names['dic_' + each] = dict.fromkeys(row, 1)  # 字段首次出现,创造字典
    # 根据生成的计数字典生成矩阵
    all_col = list(set(all_col0))   # 所有的字段(所有动物的集合)
    all_col.sort(reverse=False)  # 给定词汇列表排序排序,为了和生成空矩阵的横向列名一致
    df_final0 = pd.DataFrame(columns=all_col)  # 生成空矩阵
    for each in all_col:  # 空矩阵中每列,存在给字段字典,转为一列存入矩阵,否则先创造全为零的字典,再填充进矩阵
        try:
            temp = pd.DataFrame(names['dic_' + each], index=[each])
        except:
            names['dic_' + each] = dict.fromkeys(all_col, 0)
            temp = pd.DataFrame(names['dic_' + each], index=[each])
        df_final0 = pd.concat([df_final0, temp])  # 拼接
    df_final = df_final0.fillna(0)
    return df_final
if __name__ == '__main__':
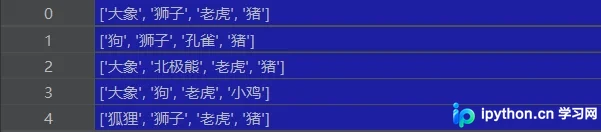
    temp1 = ['狗', '狮子', '孔雀', '猪']
    temp2 = ['大象', '狮子', '老虎', '猪']
    temp3 = ['大象', '北极熊', '老虎', '猪']
    temp4 = ['大象', '狗', '老虎', '小鸡']
    temp5 = ['狐狸', '狮子', '老虎', '猪']
    temp_all = [temp2, temp1, temp3, temp4, temp5]
    vol_li = pd.Series(temp_all)
    df_matrix = gx_matrix(vol_li)
    print(df_matrix)
输入数据格式为Series类型。
计算每个字段与其他字段共同出现的次数字典。

最终将结果转换为DataFrame格式。
补充说明
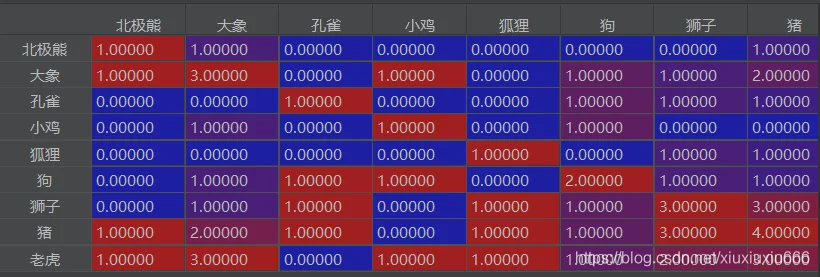
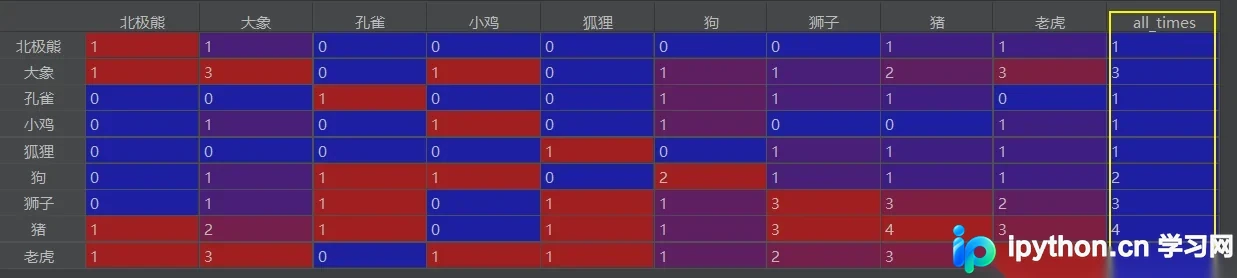
若以“大象”所在列的数值除以“大象”出现的总次数,比值较高的项表明两者共同出现频率高。若某列中两个元素a和b的比值均大于0.8(阈值可调整),说明a、b与“大象”三者共同出现的概率较高。
由此可推导出文本中频繁共现的词组搭配。例如第二列显示“大象”共出现3次,与“老虎”共同出现3次,与“猪”共同出现2次,从而推断“大象、老虎、猪”三者共现的概率较高。
若需将总出现次数单独列出并置于最后一列,代码调整如下:
# 计算每个字段的出现次数,并列为最后一行
    df_final['all_times'] = ''
    for each in df_final0.columns:
        df_final['all_times'].loc[each] = df_final0.loc[each, each]
将上述代码添加至df_final = df_final0.fillna(0)之后即可。
运行结果如下:
此前发布的代码中存在一处缩进错误,感谢指出问题的同学提醒,现已修正并提供正确代码。
以上为个人经验分享,旨在提供参考,欢迎大家支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















