


Python使用python-docx读取Word文档内容详解

本文详解如何利用Python的python-docx模块读取Word文档中的文本内容。文章介绍了模块的安装方法、核心概念(Document与Paragraph对象),并提供了完整的代码示例,展示如何获取段落数量及遍历输出每段文字,帮助开发者快速掌握Word文档处理技巧。
本文主要探讨在Python中读取Word文档文本的具体操作方法,分享了相关的基础概念及实现代码,具体内容如下。
一、docx模块概述
Python可以通过python-docx模块来处理Word文档,该模块采用面向对象的设计思路。具体而言,python-docx模块将Word文档及其内部元素(如段落、文本、字体等)视为对象,通过对这些对象进行操作,即可实现对Word文档内容的处理。
二、核心概念解析
若需读取Word文档中的文字信息(通常程序主要关注文档中的文本内容),首先需要理解python-docx模块的几个关键概念。
1. Document对象:代表整个Word文档。 2. Paragraph对象:代表Word文档中的单个段落。 3. Paragraph对象的text属性:用于获取段落中的文本内容。
三、模块安装与导入
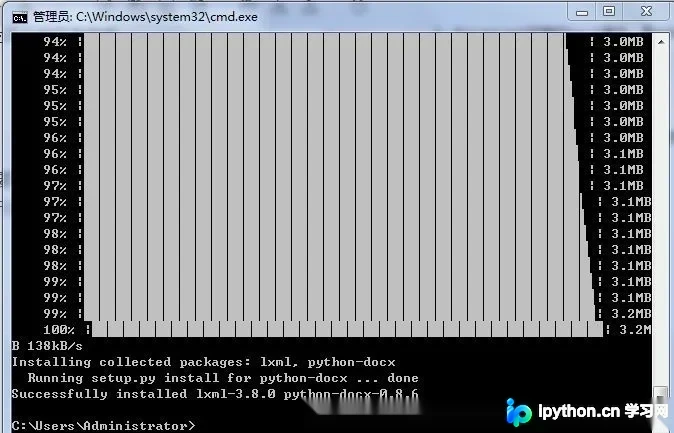
需要注意的是,python-docx模块的安装需在cmd命令行中执行pip install python-docx命令。如下图所示,安装成功时会出现“Successfully installed”的英文提示(这句英文的成功提示,对读者的英语水平有一定考验)。
在导入模块时,应使用import docx语句。
有趣的是,模块的安装名称与导入名称往往不一致,这确实有些令人困惑。看来很有必要开发一个Python版本的模块管理工具(如python-maven),当然,本段内容纯属玩笑。
四、读取Word文本实战
在了解上述基础知识后,操作变得简单。首先创建一个位于D:\temp\word.docx的文件,并在其中输入以下内容。
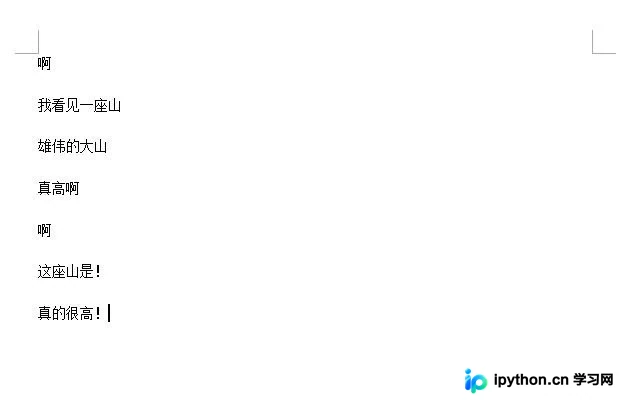
随后编写一段程序,代码及其输出结果如下所示:
#读取docx中的文本代码示例
import docx
#获取文档对象
file=docx.Document("D:\\temp\\word.docx")
print("段落数:"+str(len(file.paragraphs)))#段落数为13,每个回车隔离一段

#输出每一段的内容
for para in file.paragraphs:
 print(para.text)

#输出段落编号及段落内容
for i in range(len(file.paragraphs)):
 print("第"+str(i)+"段的内容是:"+file.paragraphs[i].text)
运行结果如下:
================ RESTART: F:/360data/重要数据/桌面/学习笔记/readWord.py ================
段落数:13
啊

我看见一座山

雄伟的大山

真高啊

啊

这座山是!

真的很高!
第0段的内容是:啊
第1段的内容是:
第2段的内容是:我看见一座山
第3段的内容是:
第4段的内容是:雄伟的大山
第5段的内容是:
第6段的内容是:真高啊
第7段的内容是:
第8段的内容是:啊
第9段的内容是:
第10段的内容是:这座山是!
第11段的内容是:
第12段的内容是:真的很高!
>>>
总结
以上就是本文关于Python读取Word文本操作的完整详解,希望能为读者提供帮助。感兴趣的朋友可继续参阅本站其他相关专题,如有不足之处,欢迎留言指正。感谢各位朋友的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















