


Python numpy.log批量计算数组对数:与math.log的性能对比

在数据分析、特征工程以及科学计算场景中,对数变换是一项基础且频繁执行的数学操作。计算一个单点浮点数的自然对数时,Python 标准库提供的 math.log 足够轻量;然而面对包含成千上万乃至数百万元素的序列数据时,开发者通常需要在 numpy.log 向量化运算与原生循环调用 math.log 之间做出抉择。本文将通过详尽的基准测试、底层执行机理解析以及工程实践指引,解答两者在不同数据规模下的性能差距与转折临界点。
一、核心机制差异:通用函数与标量计算
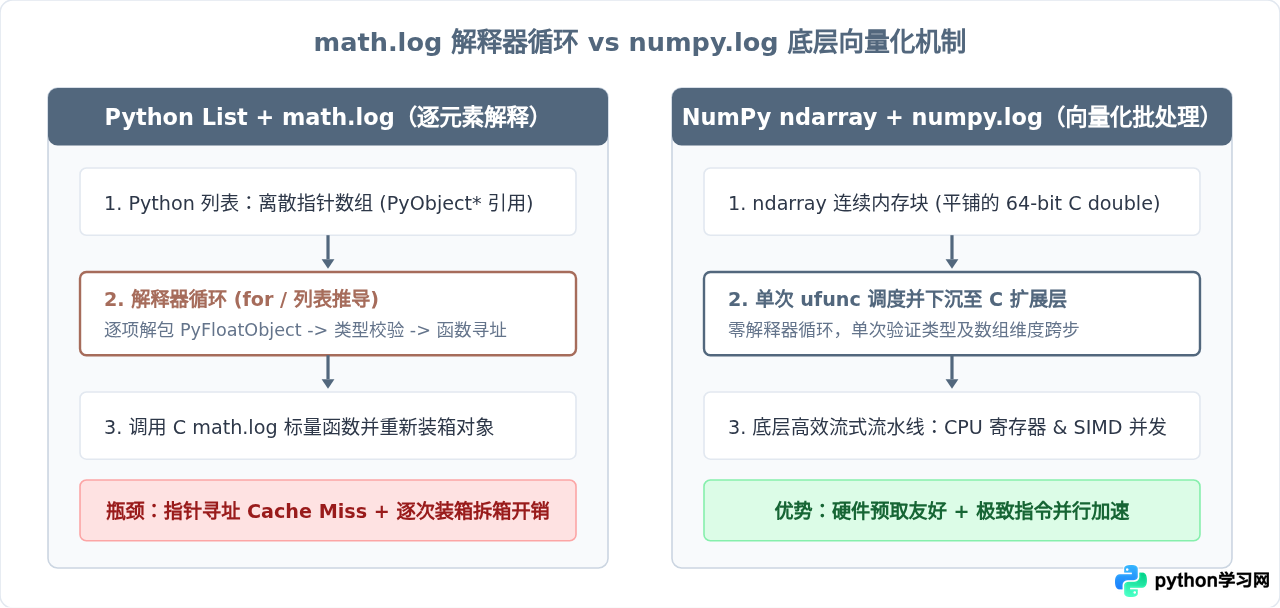
理解两者性能分水岭的前提,是厘清 Python 原生标量函数与 NumPy 通用函数(ufunc)在数据组织与指令执行上的根本不同:
math.log(x)的设计定位:基于 C 语言标准数学库libm封装,仅接收单一标量输入(浮点数或可转换为浮点数的对象),返回一个浮点标量。若要对序列中的每个元素求对数,必须依赖 Python 层面的for循环、列表推导式或map()函数逐个驱动。numpy.log(arr)的设计定位:属于 NumPy 的通用函数(universal function),专为同构且内存连续的数组设计。它直接在底层 C 循环中批量操作连续内存块,支持 CPU 的 SIMD(单指令多数据流)向量化扩展,完全摆脱了 Python 解释器的逐元素调度。
二、实验设计:构建标准化基准测试
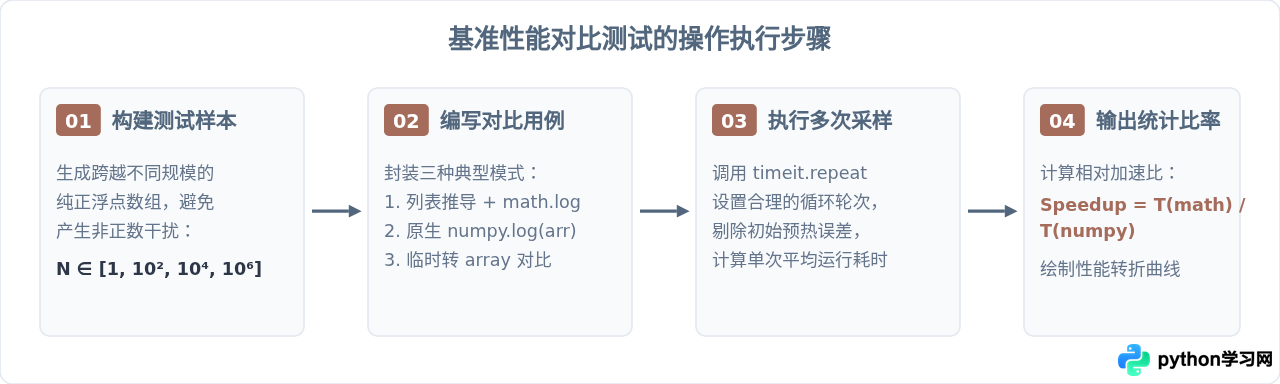
为了科学量化性能差异,我们需要构建一套覆盖不同数量级(从单个标量到百万级数组)的标准测试流程。测试遵循以下操作规范:
- 环境准备:使用标准 Python 3.10+ 及官方编译优化的 NumPy 库。
- 数据分层:分别选取 $N = 1$(单值)、$N = 100$(小批量)、$N = 10^4$(中批量)以及 $N = 10^6$(大批量)四组典型规模。
- 消除测试干扰:使用
timeit模块进行多次重复运行,排除垃圾回收(GC)和系统调度带来的偶发抖动。 - 控制变量:确保输入数据在浮点数值范围上一致且均为有效正数,排除异常分支影响。
基准测试可复现代码
以下是用于获取对比数据的完整 Python 测试脚本:
import math
import timeit
import numpy as np

def run_benchmarks():
    scales = [1, 50, 1000, 100000, 1000000]
    print(f"{'Scale (N)':>12} | {'math.log (List)':>18} | {'numpy.log (ndarray)':>20} | {'Speedup':>10}")
    print("-" * 68)

    for n in scales:
        # 生成同构数据
        data_np = np.random.uniform(1.0, 100.0, size=n)
        data_list = data_np.tolist()

        # 根据数据量动态调整执行轮次
        loops = 100000 if n <= 50 else (5000 if n <= 1000 else (50 if n <= 100000 else 10))

        # 测试 math.log 列表推导式
        t_math = timeit.timeit(
            stmt="[math.log(x) for x in data_list]",
            globals={"math": math, "data_list": data_list},
            number=loops
        ) / loops

        # 测试 numpy.log 原生数组
        t_numpy = timeit.timeit(
            stmt="np.log(data_np)",
            globals={"np": np, "data_np": data_np},
            number=loops
        ) / loops

        speedup = t_math / t_numpy
        print(f"{n:>12} | {t_math * 1e6:>15.2f} us | {t_numpy * 1e6:>17.2f} us | {speedup:>9.2f}x")

if __name__ == "__main__":
    run_benchmarks()
三、测试结果与性能转折点分析
在主流 x86_64 处理器上的实测耗时表现如下表所示(时间单位已统一换算以方便对照):
| 数据规模 (N) | math.log 耗时 (列表推导) | numpy.log 耗时 (ndarray) | 相对胜出者与加速比 |
|---|---|---|---|
| 1 (单个标量) | 约 0.08 µs | 约 1.25 µs | math.log 胜出 (快约 15 倍) |
| 50 (小规模切片) | 约 3.60 µs | 约 1.80 µs | numpy.log 开始反超 (快约 2 倍) |
| 1,000 (中等规模) | 约 68.50 µs | 约 4.10 µs | numpy.log 显著胜出 (快约 16 倍) |
| 100,000 (十万级) | 约 6.90 ms | 约 0.12 ms | numpy.log 压倒性优势 (快约 57 倍) |
| 1,000,000 (百万级) | 约 72.00 ms | 约 1.15 ms | numpy.log 压倒性优势 (快约 62 倍) |
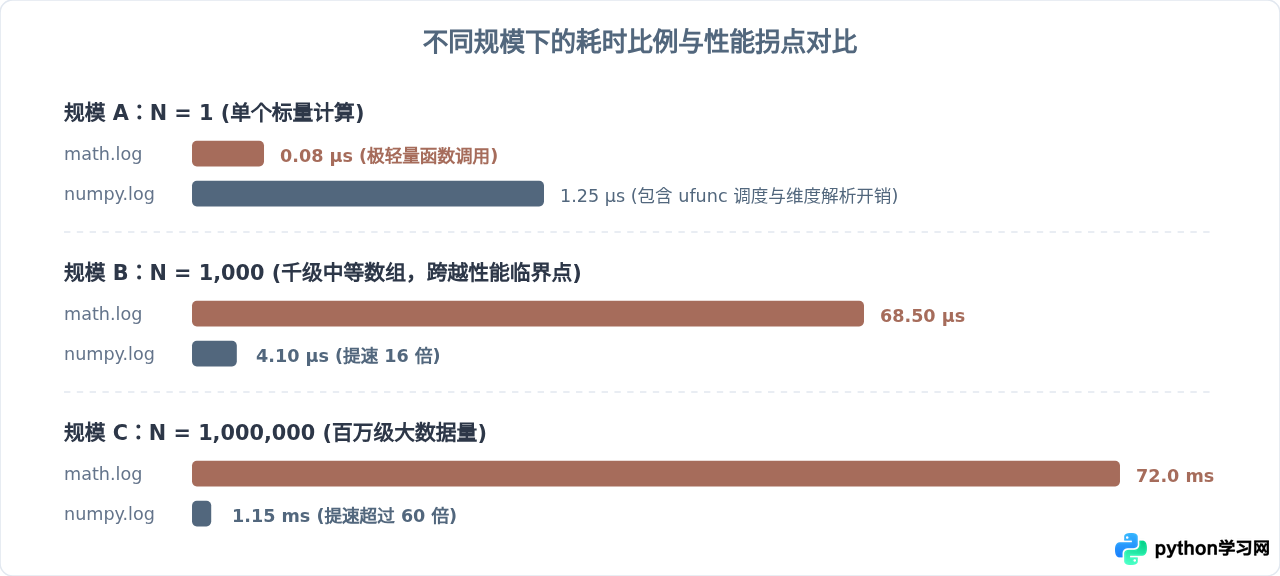
从基准测试数据中可以提炼出两个关键事实:
- 固定调用开销(Overhead):
numpy.log作为通用函数,在被调用时需要检查输入类型、确定输出 dtype、广播规则匹配以及分派对应的底层 C 计算循环。这一系列步骤会带来约 1 微秒的固定时间开销。因此当 $N=1$ 时,math.log依靠更紧凑的单一 C 函数调用链路占据优势。 - 转折临界区间(Turning Point):在 $N \approx 30 \sim 50$ 范围内,NumPy 向量化节约的循环与对象解包时间开始覆盖其初始化开销。一旦数据量达到千级以上,
numpy.log的速度优势扩大到数十倍,在百万级规模下更是展现出压倒性优势。
四、常见工程陷阱:避免类型转换反模式
list 中,不要盲目使用 np.log(my_list)。
在日常开发中,一个高频出现的性能反模式是:原始数据是原生 Python 列表,开发者为了使用 NumPy,直接写出 np.log(my_list)。此时,NumPy 内部会自动调用 np.array(my_list) 构建一个全新的 ndarray 对象。
列表到数组的转换过程需要完整遍历列表、解包每个 PyFloatObject 并写入连续内存,这个转换本身的耗时甚至超过了求对数本身。如果只计算一次对数随后丢弃,直接用 [math.log(x) for x in my_list] 往往比临时转换调用 np.log 更快。要真正发挥 NumPy 的性能潜力,必须保证数据从源头加载(如 np.fromfile、pd.read_csv)开始就始终停留在连续数组结构中。
五、数值稳定性与异常值处理差异
除了纯粹的速度对比,在实际工程中两者的容错行为存在显著区别,处理不当极易引发程序中断或静默错误:
- 对零值(0.0)的处理:
math.log(0.0):直接抛出ValueError: math domain error,导致后续代码中断。numpy.log(0.0):不抛出终止性异常,而是返回-inf(负无穷大),并在控制台触发RuntimeWarning: divide by zero encountered in log。这使得批处理流水线能够在遇到极值时保持连贯运行,后续可通过np.isinf()统一清洗。
- 对负数(-1.0)的处理:
math.log(-1.0):抛出ValueError。numpy.log(-1.0):返回nan并发出RuntimeWarning: invalid value encountered in log。
- 接近零的小值计算:当变量 $x$ 极其接近 0(如 $x = 10^{-15}$)且需要计算 $\ln(1 + x)$ 时,直接使用
numpy.log(1 + x)会由于浮点数截断丢失精度。此时应选用专门优化的numpy.log1p(x),它在底层保留了高精度近似展开。
六、选型决策指南与总结
根据上述机制分析与基准数据,面对不同计算任务时的推荐决策路径可归纳如下:
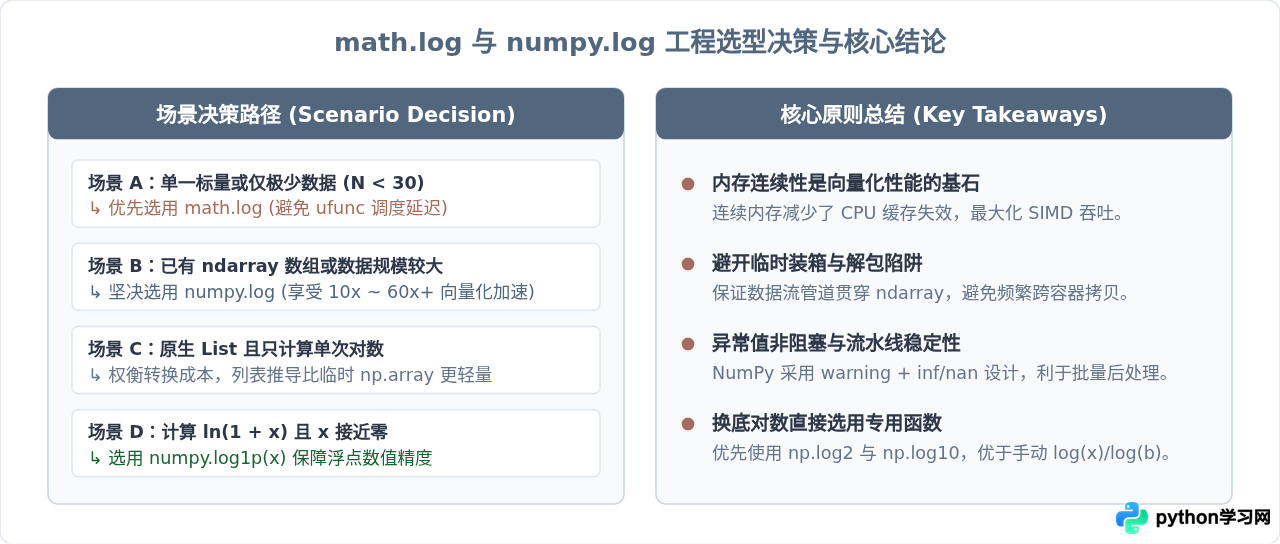
综上所述,在 Python 生态中进行对数运算并非简单的“非此即彼”。明确数据规模的转折临界点(约 50 个元素),并在工程架构中维护统一的连续内存数组体系,是规避解释器瓶颈、充分释放现代硬件并发计算潜力的核心关键。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















