


Python爬虫100例中的数据持久化:存入MySQL与MongoDB最佳实践

在Python爬虫工程中,网络抓取与页面解析只是第一步,如何将瞬时涌入的海量异构数据高效、安全地保存至数据库,直接决定了整个采集系统的吞吐能力与数据质量。数据持久化不是简单地调用单条 INSERT 语句,而是需要在数据模型设计、批量写入策略、主键冲突去重、连接复用以及异常回滚等环节做出严谨的工程权衡。本文针对关系型数据库 MySQL 与文档型数据库 MongoDB,系统阐述爬虫数据持久化的核心原理、关键代码实现与调优准则,帮助读者构建健壮、高效的高并发爬虫落盘架构。
一、爬虫持久化架构与存储引擎选型
面对抓取回来的网页数据,开发者最先面临的决策是选择关系型数据库还是文档型数据库。爬虫数据的结构形态往往决定了存储选型:
- MySQL 适用场景: 具有严格定义、强结构化、关联关系清晰的核心数据,例如电商标准SKU、标准化金融指标、具有外键关联的用户主数据。MySQL 依靠 InnoDB 引擎提供完善的 ACID 事务支持与严格的字段约束,能够防止脏数据写入,保证数据一致性。
- MongoDB 适用场景: 属性高度动态、层级嵌套深、半结构化甚至非结构化的数据,例如不同品类具有完全不同规格参数的商品详情页、论坛非嵌套回帖、原始抓取快照。MongoDB 采用 BSON 格式,具备天然的“无模式(Schemaless)”特性,新增字段无需执行成本高昂的
ALTER TABLE,且支持高并发写入。
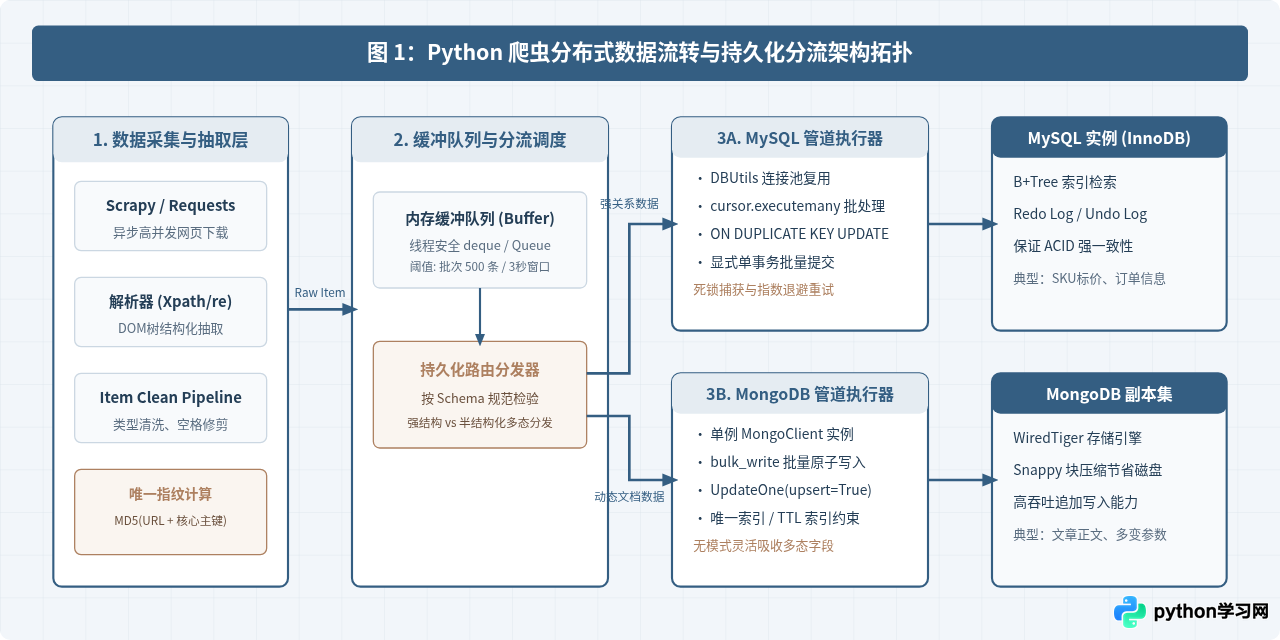
在成熟的爬虫架构中,通常采用管道(Item Pipeline)模式解耦数据抓取与入库。爬虫多线程或协程只负责向内存队列派发清洗后的 Item,后端的持久化调度器根据 Item 的类型与业务标签,路由至对应的 MySQL 或 MongoDB 写入池,如下图所示:
二、关系型存储:MySQL 最佳实践
将爬虫数据存入 MySQL 时,初学者最容易犯的三个错误是:单条数据频繁连接关闭、逐条 INSERT 导致网络与磁盘 I/O 成为瓶颈、主键冲突时暴力忽略导致数据无法更新。以下是针对这三个关键问题的工程解决方案。
1. 批量插入与事务聚合
在网络爬虫中,每次解析出一条 Item 就执行一次 INSERT 并单独 commit(),会导致频繁的 TCP 交互和 MySQL 强制落盘(fsync),数据库吞吐量往往被压制在每秒数十至数百条。利用内存缓冲区聚集一批记录(例如 500~2000 条),通过 cursor.executemany() 在单次事务中批量写入,能使落盘吞吐量飙升数倍乃至数十倍。
2. 主键去重与数据更新 (UPSERT)
爬虫不可避免会重复抓取或重试请求。如果在遇到主键或唯一索引冲突时仅简单使用 INSERT IGNORE,历史记录中已发生变更的字段(例如商品最新价格、文章阅读量、点赞数)将永远无法更新。而在 Python 爬虫中,最佳方案是使用 MySQL 原生的 ON DUPLICATE KEY UPDATE 语法,即“存在则更新,不存在则插入”。
假设我们抓取图书信息,表结构如下:
CREATE TABLE `crawler_books` (
  `id` BIGINT UNSIGNED NOT NULL AUTO_INCREMENT,
  `book_id` VARCHAR(64) NOT NULL COMMENT '抓取站点的业务主键',
  `title` VARCHAR(255) NOT NULL COMMENT '书名',
  `price` DECIMAL(10, 2) NOT NULL DEFAULT '0.00' COMMENT '价格',
  `rating` DECIMAL(3, 1) DEFAULT NULL COMMENT '评分',
  `updated_at` TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_book_id` (`book_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci;
对应的批量写入与更新 Python 代码实现如下:
import pymysql
from pymysql.cursors import DictCursor

def batch_upsert_books(connection, book_items):
    """
    批量将图书数据存入 MySQL。
    若 book_id 存在则更新 price, rating 和 updated_at;若不存在则插入新行。
    """
    if not book_items:
        return 0

    sql = """
    INSERT INTO crawler_books (book_id, title, price, rating)
    VALUES (%s, %s, %s, %s)
    ON DUPLICATE KEY UPDATE
        title = VALUES(title),
        price = VALUES(price),
        rating = VALUES(rating),
        updated_at = CURRENT_TIMESTAMP;
    """

    params = [
        (item['book_id'], item['title'], item['price'], item.get('rating'))
        for item in book_items
    ]

    with connection.cursor(DictCursor) as cursor:
        affected_rows = cursor.executemany(sql, params)
    connection.commit()
return affected_rows注意:affected_rows 在执行 ON DUPLICATE KEY UPDATE 时,如果插入新行返回 1;若更新了已有行且值发生变化返回 2;若已有行数据完全一致无改动返回 0。评估爬虫新增与更新计数时需留意该机制。
3. 基于 DBUtils 的数据库连接池管理
高并发多线程爬虫如果为每个线程频繁创建和销毁连接,会迅速耗尽 MySQL 的 max_connections,甚至引发连接重置错误。使用 dbutils.pooled_db 构建连接池,可以确保线程安全且连接常驻:
from dbutils.pooled_db import PooledDB
import pymysql

class MySQLPoolManager:
    _instance = None

    @classmethod
    def get_pool(cls, host='127.0.0.1', port=3306, user='root', password='', db='spider_data'):
        if cls._instance is None:
            cls._instance = PooledDB(
                creator=pymysql,
                maxconnections=20,     # 连接池允许的最大连接数
                mincached=5,           # 初始化时,连接池至少创建的空闲连接
                maxcached=10,          # 连接池中最多闲置的连接
                maxshared=0,           # 线程间不共享连接
                blocking=True,         # 连接池耗尽时是否阻塞等待
                maxusage=None,         # 单个连接的最大复用次数
                setsession=[],         # 可选的会话配置命令
                host=host,
                port=port,
                user=user,
                password=password,
                database=db,
                charset='utf8mb4',
                autocommit=False
            )
        return cls._instance
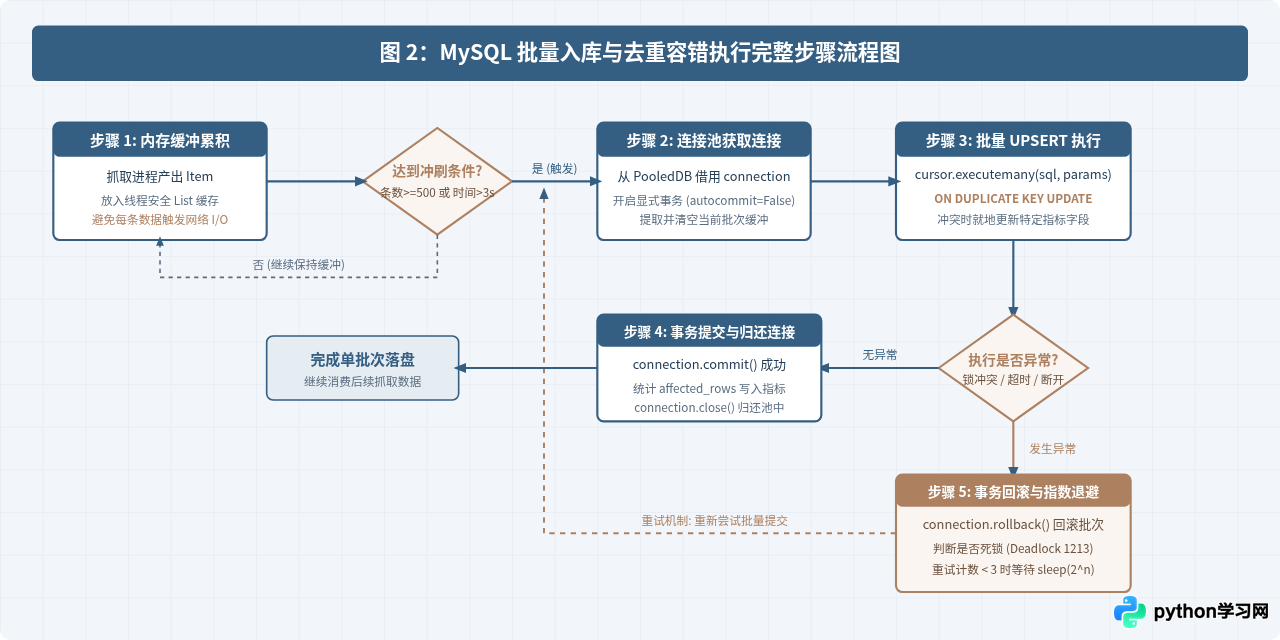
下面的流程图详细拆解了 MySQL 批量入库的严谨控制流程,包括缓冲判断、语句构建、事务提交以及针对锁超时和死锁的指数退避重试机制:
三、文档型存储:MongoDB 最佳实践
MongoDB 是现代 Python 爬虫项目中使用最广泛的存储组件之一。其原生的 BSON 格式与 Python 的 dict 结构天然映射,特别适合抓取结构多变(例如各品类手机、家电的多态规格参数)的数据。然而,如果不规范使用索引或滥用单条写,性能同样会迅速退化。
1. 批量更新核心:bulk_write 与 UpdateOne(upsert=True)
在 PyMongo 中,最强大的去重持久化工具是 bulk_write。通过将一组 UpdateOne 操作打包并设置 upsert=True,MongoDB 能在单次网络往返中处理数千条文档,兼备高吞吐与精准去重:
from pymongo import MongoClient, UpdateOne
from pymongo.errors import BulkWriteError
import datetime

class MongoPersistencePipeline:
    def __init__(self, uri="mongodb://127.0.0.1:27017", db_name="crawler_db"):
        # MongoClient 自带内部连接池,应保持为全局单例
        self.client = MongoClient(uri, maxPoolSize=50, waitQueueTimeoutMS=2500)
        self.db = self.client[db_name]
        self.collection = self.db["articles"]
        self._ensure_indexes()

    def _ensure_indexes(self):
        """确保唯一业务索引与时间索引存在"""
        self.collection.create_index([("url_hash", 1)], unique=True, background=True)
        self.collection.create_index([("crawled_at", -1)], background=True)

    def batch_save(self, items):
        if not items:
            return None

        operations = []
        now = datetime.datetime.utcnow()

        for item in items:
            # 过滤或计算主键指纹
            url_hash = item.get("url_hash")
            if not url_hash:
                continue

            # 使用 $set 更新变动字段,使用 $setOnInsert 保护初次写入的创建时间
            update_payload = {
                "$set": {
                    "title": item.get("title"),
                    "content": item.get("content"),
                    "view_count": item.get("view_count", 0),
                    "tags": item.get("tags", []),
                    "updated_at": now
                },
                "$setOnInsert": {
                    "url": item.get("url"),
                    "url_hash": url_hash,
                    "created_at": now
                }
            }

            operations.append(
                UpdateOne({"url_hash": url_hash}, update_payload, upsert=True)
            )

        if not operations:
            return None

        try:
            # ordered=False 表示并行无序执行,某一条失败不阻塞后续写入
            result = self.collection.bulk_write(operations, ordered=False)
            return {
                "matched": result.matched_count,
                "modified": result.modified_count,
                "upserted": len(result.upserted_ids)
            }
        except BulkWriteError as bwe:
            # 记录批量写入失败详情
            print(f"MongoDB bulk write error details: {bwe.details}")
            raise
2. $set 与 $setOnInsert 的精细搭配
在爬虫持续运行的增量采集场景中,我们希望新抓取到的页面记录“初次抓取时间(created_at)”,而在后续重复轮询时只刷新“最新抓取时间(updated_at)”与“阅读量/点赞数”。使用上述代码中的 $setOnInsert,可以确保只有在触发插入新文档时才设置某些字段,更新已有文档时完全不会覆盖原始时间戳,这是爬虫增量治理的经典技巧。
3. 利用 TTL 索引自动清理临时抓取快照
许多爬虫任务需要保留页面源码 HTML 以备后续规则变更时二次解析,但如果长期全量保存,磁盘很快会被撑满。MongoDB 提供了独特的 TTL(Time-To-Live)索引,允许指定文档在抓取一定时间后被后台线程自动删除:
# 设置 snapshot_at 字段在 30 天(2592000秒)后自动过期删除
self.db["raw_html_snapshots"].create_index(
    "snapshot_at",
    expireAfterSeconds=2592000,
    background=True
)
下表系统对比了 MySQL 与 MongoDB 在爬虫持久化设计中的核心机制映射:
| 对比维度 | MySQL (InnoDB) | MongoDB (WiredTiger) |
|---|---|---|
| 数据模型 | 二维表格,预先定义 Schema,强约束 | BSON 文档,动态模式,天然支持复杂嵌套与数组 |
| 去重更新机制 | ON DUPLICATE KEY UPDATE |
UpdateOne(filter, update, upsert=True) |
| 批量操作 API | cursor.executemany(sql, params) |
collection.bulk_write(ops, ordered=False) |
| 连接管理方式 | 单连接非线程安全,必须使用 DBUtils 连接池 |
MongoClient 自身已集成高性能线程安全连接池 |
| 存储扩容难易度 | 单机垂直扩容为主,分布式分库分表较重 | 天然原生支持分片集群(Sharding)横向平滑扩展 |
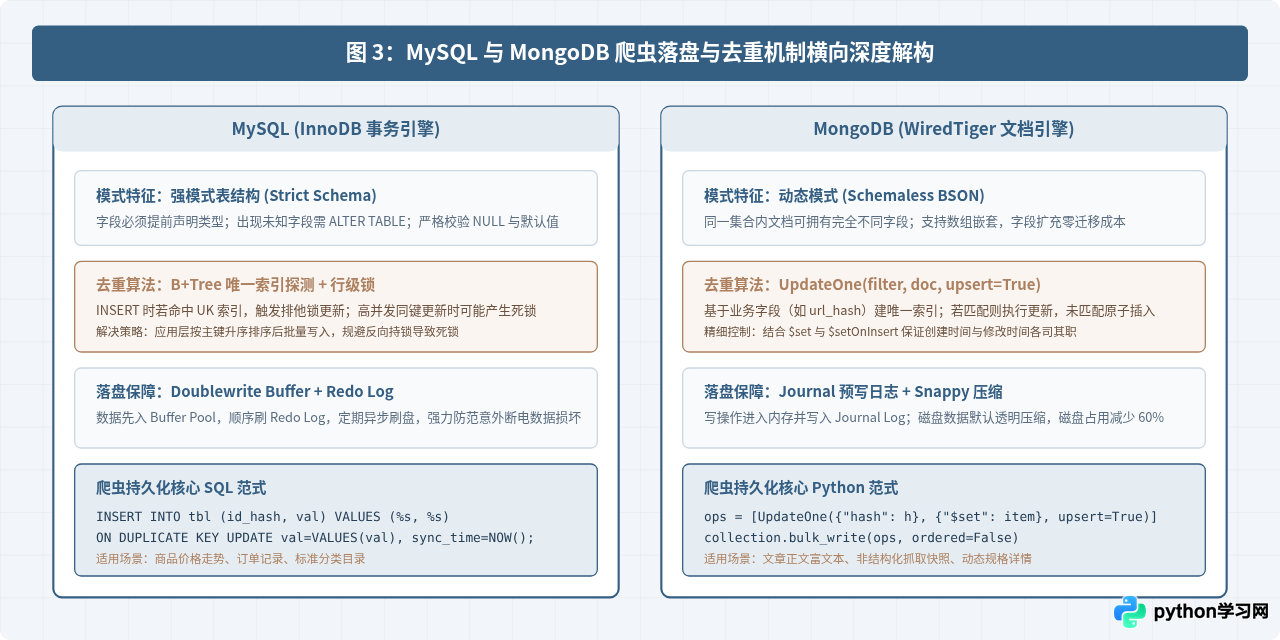
为了直观展现两者在底层更新机制、存储引擎缓存以及索引处理上的本质差异,图 3 提供了横向深度解构:
四、生产级持久化管道实战架构
在编写实际爬虫时(例如 Scrapy Pipeline 或基于 Celery / asyncio 的分布式爬虫),持久化模块必须具备解耦缓冲、双阈值触发、自动重试和故障落盘降级四个核心能力。以下是一个可直接投入生产的通用批量缓冲持久化管道设计:
import time
import threading

class RobustPersistenceBuffer:
    def __init__(self, flush_handler, batch_size=1000, flush_interval=3.0):
        """
        :param flush_handler: 具体的落盘回调函数(如写入 MySQL 或 MongoDB)
        :param batch_size: 触发落盘的条数阈值
        :param flush_interval: 触发落盘的时间窗口阈值(秒)
        """
        self.flush_handler = flush_handler
        self.batch_size = batch_size
        self.flush_interval = flush_interval

        self.buffer = []
        self.lock = threading.Lock()
        self.last_flush_time = time.time()
        self.is_running = True

        # 后台定时冲刷守护线程,防止低频抓取时数据长时间滞留内存
        self.flusher_thread = threading.Thread(target=self._interval_flusher, daemon=True)
        self.flusher_thread.start()

    def add(self, item):
        with self.lock:
            self.buffer.append(item)
            if len(self.buffer) >= self.batch_size:
                self._flush_locked()

    def _interval_flusher(self):
        while self.is_running:
            time.sleep(1.0)
            with self.lock:
                if self.buffer and (time.time() - self.last_flush_time >= self.flush_interval):
                    self._flush_locked()

    def _flush_locked(self):
        """必须在持有 self.lock 的情况下调用"""
        if not self.buffer:
            return
        items_to_save = self.buffer
        self.buffer = []
        self.last_flush_time = time.time()

        # 异步或当前线程调用落盘(根据业务吞吐量决定)
        try:
            self.flush_handler(items_to_save)
        except Exception as e:
            # 严重故障降级:若数据库短暂宕机,将数据写入本地持久化补救文件(如 JSON Lines)
            self._fallback_dump(items_to_save, e)

    def _fallback_dump(self, items, err):
        filename = f"fallback_dump_{int(time.time())}.jsonl"
        print(f"[严重错误] 数据库持久化失败: {err},启动本地应急降级: {filename}")
        import json
        with open(filename, "a", encoding="utf-8") as f:
            for item in items:
                f.write(json.dumps(item, ensure_ascii=False) + "\n")

    def close(self):
        self.is_running = False
        with self.lock:
            self._flush_locked()
五、高频踩坑点与排查调优指南
- MySQL 死锁 (Deadlock found when trying to get lock; try restarting transaction)
当多个并发爬虫 Worker 都在使用ON DUPLICATE KEY UPDATE时,由于记录插入顺序不一致,两个事务可能分别锁定了 UK 索引的不同间隙,形成相互等待。排查与优化对策: 在执行cursor.executemany()之前,在 Python 内存中将该批次的items按照主键/唯一索引字段升序排序,强制所有 Worker 按照相同的物理顺序申请行锁,能消除 95% 以上的并发死锁。 - MongoDB 内存持续虚高
WiredTiger 引擎默认会占用系统 50% 甚至更多的物理内存作为缓存(WiredTiger Cache)。初学者常误以为发生内存泄露。实际上这是正常的文件系统缓存加速机制。但若数据量极大导致频繁缺页置换,需排查是否缺少索引导致每次UpdateOne触发全表扫描(COLLSCAN)。通过db.articles.explain().find({"url_hash": ...})验证是否命中IXSCAN。 - 连接池耗尽与僵尸连接
长时间运行的爬虫如果遇到反爬阻断进入长休眠,可能导致 MySQL 连接超过wait_timeout被服务端主动切断,再次写入时抛出MySQL server has gone away (Error 2006)。解决方案: 在连接池初始化时开启自动重连或配置会话健康探测(Ping机制)。
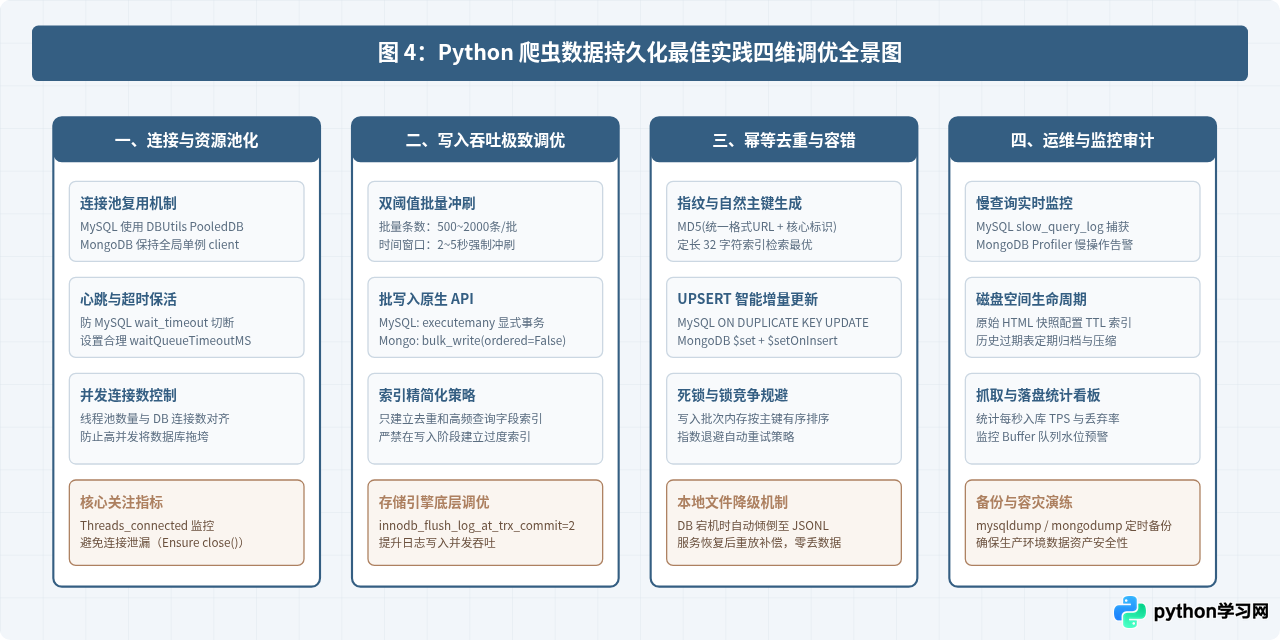
图 4 为爬虫数据持久化工程的全生命周期调优与排查全景图,涵盖从接入层到监控维护的四维防护体系:
六、总结
在 Python 爬虫 100 例实战体系中,数据持久化不仅是技术实现,更是一门平衡并发效率与数据安全性的工程艺术:
- 针对结构严格、依赖关联分析、要求事务一致性的数据实体,采用 MySQL + DBUtils 连接池 + executemany 批量 UPSERT 是标准选择;务必在并发批次前进行排序以预防死锁。
- 针对字段多态多变、树状嵌套深、网页快照原型的数据,采用 MongoDB + bulk_write(UpdateOne(..., upsert=True)) 能发挥最高吞吐能力;灵活结合
$setOnInsert与 TTL 索引可极大降低运维复杂度。 - 在工程实现上,始终坚持“内存缓冲双阈值触发 + 故障本地降级”原则,将持久化与抓取业务完全解耦,才能打造出经得起海量数据考验的高可用爬虫系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















