


Python中使用run_in_executor将同步函数转为异步执行
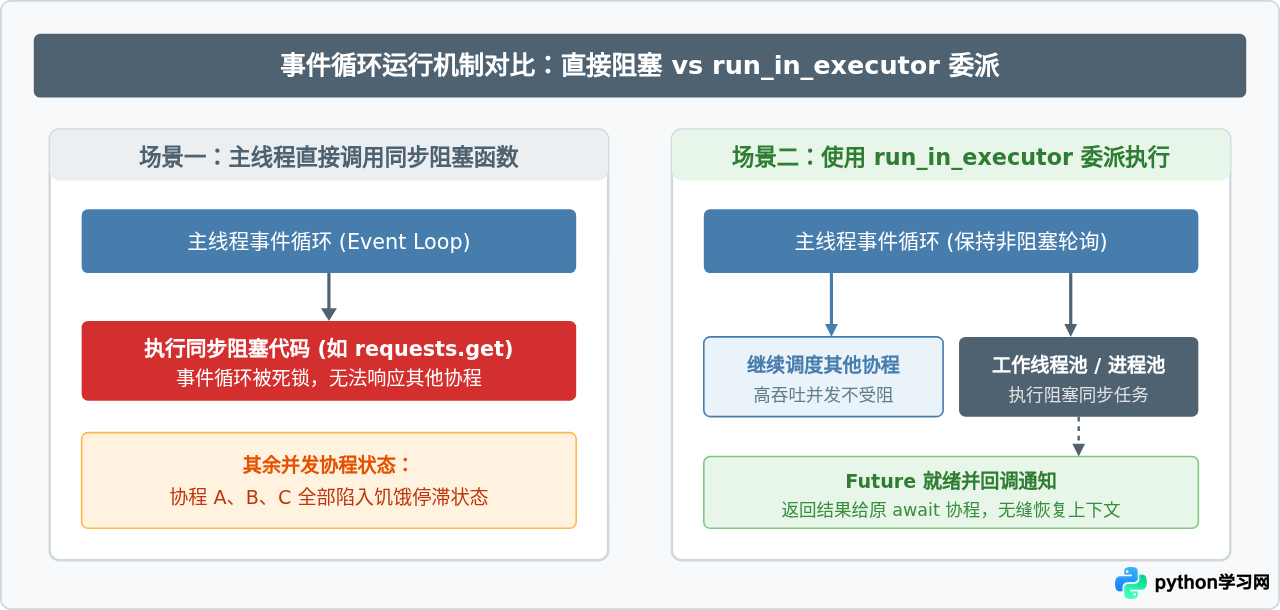
在基于 asyncio 构建的 Python 异步应用程序中,事件循环依赖单线程协同调度运行。当代码中调用了传统同步阻塞库(如 requests、本地文件阻塞读写)或执行密集的数学运算时,单线程事件循环会被直接挂起,导致所有并发协程全部停滞。解决这一问题的标准方案是使用事件循环提供的 loop.run_in_executor() 方法,将同步函数委派给后台线程池或进程池执行,并返回一个可等待的 asyncio.Future 对象,从而确保事件循环继续高效运转。
为什么需要 run_in_executor
Python 的 asyncio 遵循“协作式多任务”模式。事件循环就像一个不知疲倦的调度员,在各个 await 挂起点之间来回切换。只要某个任务没有主动交出执行权(例如直接调用了 time.sleep(5) 或阻塞网络请求),调度员就会被彻底困在当前任务中,其它等待网络 I/O 回调的协程全都被迫排队等待。
在实际工程开发中,往往很难做到所有依赖库都是纯异步原生的。很多成熟的第三方 SDK、数据库驱动或科学计算函数仅提供同步版本。run_in_executor 扮演了“同步代码与异步事件循环之间的桥梁”,它不改变同步函数内部的执行机制,而是通过底层工作线程或多进程接管阻塞调用,计算完毕后再通过事件循环通知结果。
run_in_executor 核心语法与参数规则
方法定义签名如下:
awaitable loop.run_in_executor(executor, func, *args)各参数的具体含义与规则:
- executor:执行器实例。如果传入
None,将默认使用当前事件循环自带的ThreadPoolExecutor(Python 3.8+ 默认最大工作线程数为min(32, os.cpu_count() + 4));如果传入自定义的concurrent.futures.Executor实例(如专门配置容量的ThreadPoolExecutor或ProcessPoolExecutor),则使用指定的执行器。 - func:需要转为后台运行的同步可调用对象(函数名或类方法)。注意只需传入函数引用,不要加括号调用。
- *args:传递给
func的位置参数。
run_in_executor() 仅接收位置参数 *args,签名中并没有提供 **kwargs。如果目标同步函数依赖关键字参数,直接传递会引发 TypeError。必须借助标准库中的 functools.partial 提前包装参数,或者使用匿名函数 lambda 进行包围。
四步实现同步转异步的完整流程
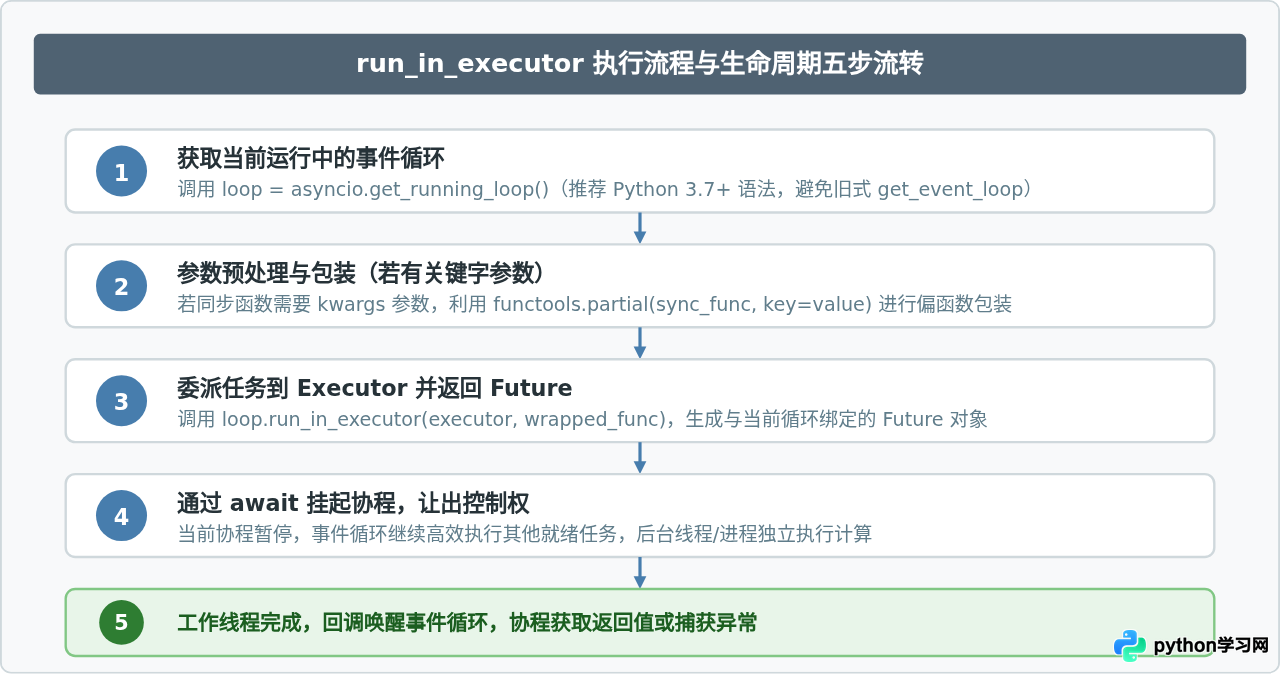
将同步函数桥接到异步循环中,通常按照以下标准步骤开展:
场景演示:使用 requests 抓取多个网页
以下示例展示了如何在异步应用中使用 requests 库,同时发起多个并发 HTTP 请求而不阻断主事件循环:
import asyncio
import time
from functools import partial
import requests

# 传统的同步阻塞函数
def fetch_url(url, timeout=5):
    print(f"[{time.strftime('%X')}] 开始同步请求: {url}")
    response = requests.get(url, timeout=timeout)
    print(f"[{time.strftime('%X')}] 请求完成: {url},状态码: {response.status_code}")
    return url, response.status_code

async def main():
    loop = asyncio.get_running_loop()
    urls = [
        "https://httpbin.org/delay/2",
        "https://httpbin.org/delay/2",
        "https://httpbin.org/delay/2",
    ]

    start_time = time.time()

    # 创建异步任务列表
    tasks = []
    for url in urls:
        # 使用 partial 绑定关键字参数 timeout
        task_func = partial(fetch_url, url, timeout=10)

        # 将任务委派到默认线程池
        fut = loop.run_in_executor(None, task_func)
        tasks.append(fut)

    # 并发等待全部任务完成
    results = await asyncio.gather(*tasks)

    elapsed = time.time() - start_time
    print(f"\n全部请求完成!返回结果: {results}")
    print(f"总耗时: {elapsed:.2f} 秒(若同步串行执行需约 6 秒,异步并发仅需约 2 秒多)")

if __name__ == "__main__":
    asyncio.run(main())
线程池与进程池的选择依据
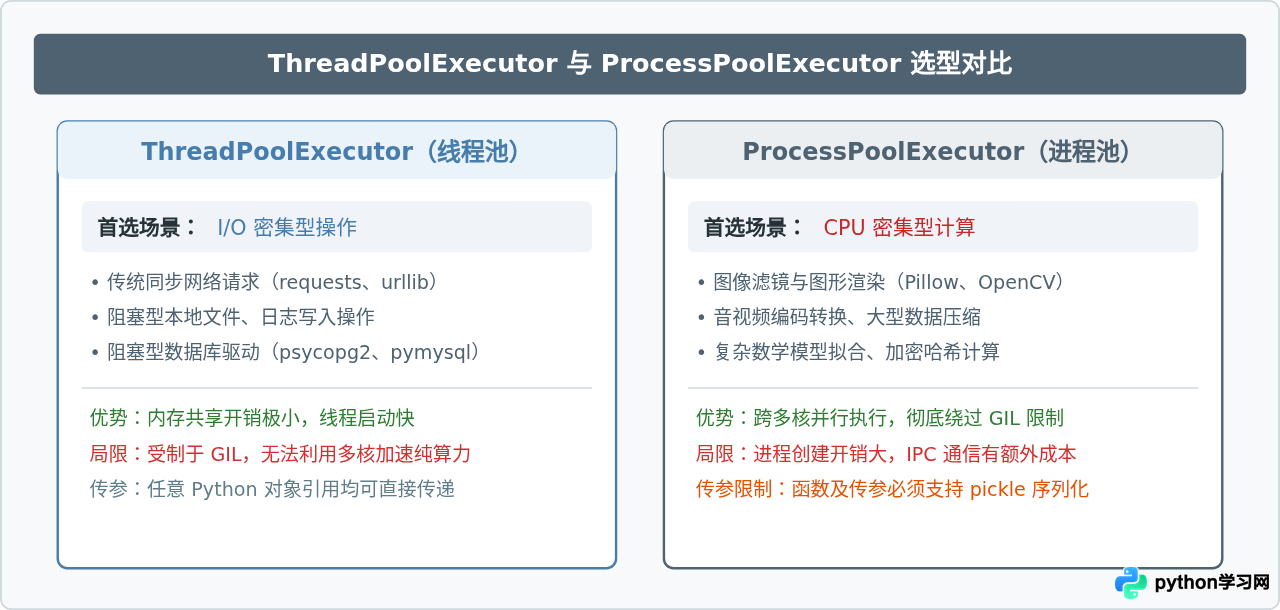
run_in_executor 的首个参数 executor 允许开发者指定具体的执行器。在标准库 concurrent.futures 中,最常用的两种执行器是 ThreadPoolExecutor 和 ProcessPoolExecutor。正确选型的关键在于明确任务是 I/O 密集型 还是 CPU 密集型。
CPU密集型场景示例:利用多进程执行哈希计算
对于纯算力消耗的任务,如果继续使用线程池,由于全局解释器锁(GIL)的存在,多线程无法在多核 CPU 上实现真并行。必须显式传入 ProcessPoolExecutor:
import asyncio
import hashlib
from concurrent.futures import ProcessPoolExecutor

# 纯 CPU 密集型函数:执行大量哈希计算
def compute_heavy_hash(data_block: bytes, iterations: int = 2000000) -> str:
    result = data_block
    for _ in range(iterations):
        result = hashlib.sha256(result).digest()
    return result.hex()

async def main():
    loop = asyncio.get_running_loop()

    # 创建拥有 4 个工作进程的独立进程池
    with ProcessPoolExecutor(max_workers=4) as executor:
        payloads = [b"task_alpha", b"task_beta", b"task_gamma", b"task_delta"]

        # 将每个 CPU 密集任务分别委派给进程池
        tasks = [
            loop.run_in_executor(executor, compute_heavy_hash, item, 1500000)
            for item in payloads
        ]

        print("任务已分发至进程池,事件循环正在等待计算结果...")
        results = await asyncio.gather(*tasks)

        for idx, res in enumerate(results):
            print(f"任务 {idx} 计算完成: {res[:16]}...")

if __name__ == "__main__":
    # Windows/macOS 平台下,多进程调用必须置于主入口保护块内
    asyncio.run(main())
常见陷阱与注意事项
| 易错场景 | 错误表现 / 危害 | 正确规范与排查方法 |
|---|---|---|
| 关键字参数直接传参 | 报错 TypeError: run_in_executor() got an unexpected keyword argument |
使用 functools.partial(func, kw=val) 封装成无关键字单函数,或通过位置参数传参。 |
| 进程池参数不可序列化 | 报错 PicklingError: Can't pickle ... |
传递给 ProcessPoolExecutor 的函数必须在模块顶层定义(不能是闭包或局部 lambda),参数必须支持 pickle。 |
| 默认线程池被打满 | 高并发场景下新任务在队列中积压,延迟急剧上升 | 通过 ThreadPoolExecutor(max_workers=N) 自定义线程池上限,或使用信号量 asyncio.Semaphore 限流。 |
| 执行器未安全释放 | 程序退出时悬挂僵尸进程或无法顺利回收文件句柄 | 使用 with Executor() as executor 上下文管理器,或在程序优雅停机钩子中调用 executor.shutdown(wait=True)。 |
Python 3.9+ 的简化替代:asyncio.to_thread
如果当前开发环境处于 Python 3.9 或更高版本,且仅需要将 I/O 阻塞函数委派给默认线程池,可以直接使用标准库新增的高层封装 asyncio.to_thread():
# Python 3.9+ 原生支持关键字参数直接传递
result = await asyncio.to_thread(fetch_url, "https://example.com", timeout=10)
asyncio.to_thread() 底层依然是在调用当前事件循环的 run_in_executor(None, func, *args),并自动处理了 kwargs。但当需要精细控制线程池大小、复用特定资源池、或者使用 ProcessPoolExecutor 绕过 GIL 时,loop.run_in_executor 依然是不可替代的底层核心机制。
总结与选型指南
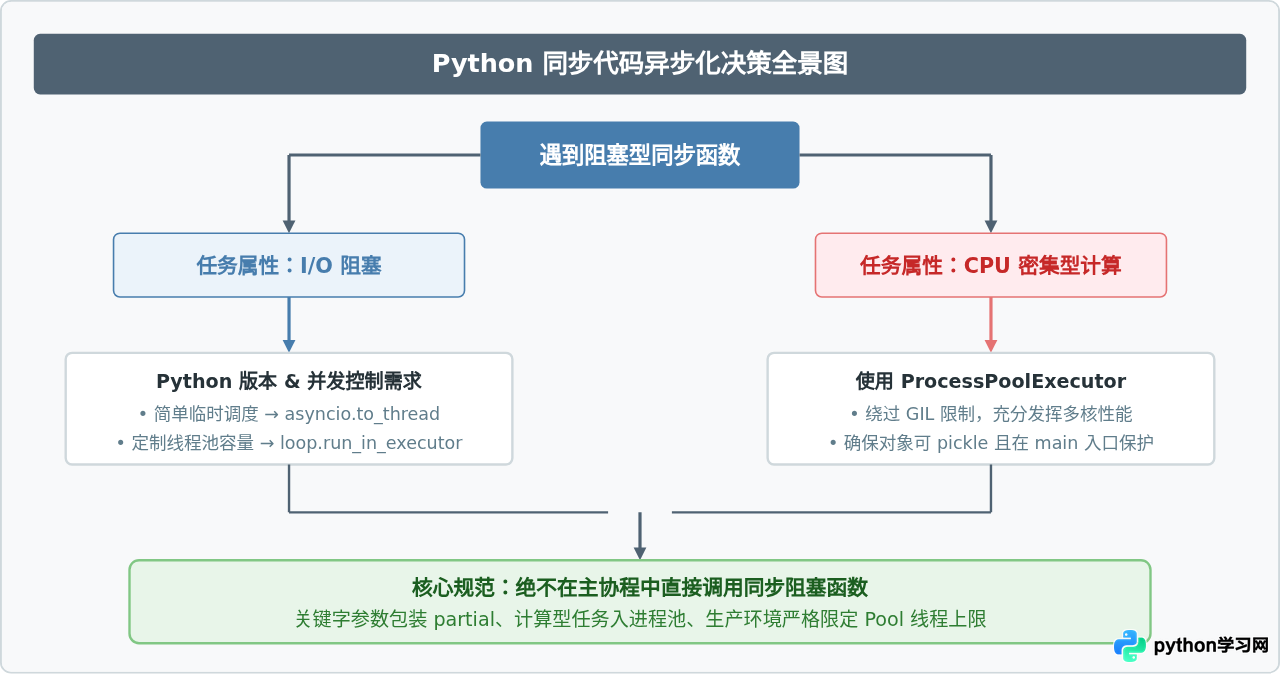
掌握 run_in_executor 的用法,是编写健壮高效 Python 异步程序的基础能力。在面对海量存量同步库时,无需推倒重写,只需合理规划工作线程或独立进程,即可让单线程事件循环始终处于敏捷响应状态,兼顾开发效率与系统的高吞吐性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















