


Python文本模式与二进制模式读写文件的换行符处理差异
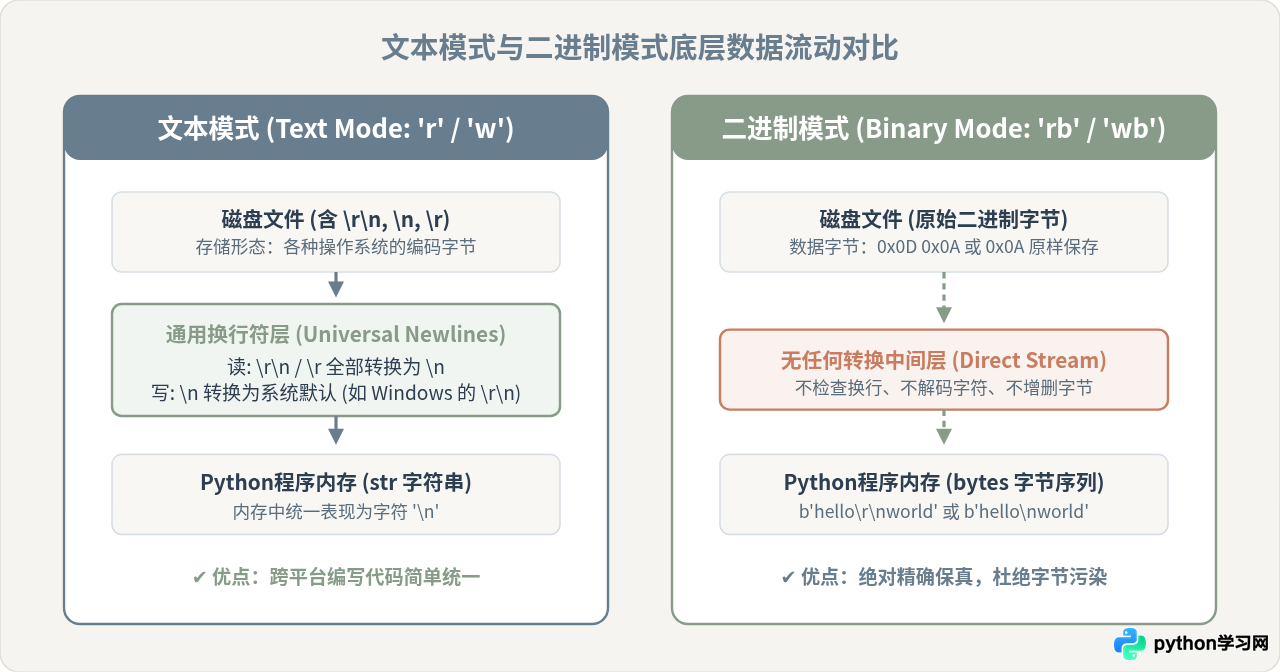
在Python中读写文件时,文本模式(默认模式)会自动启用“通用换行符”机制,在读取时将不同操作系统的换行符(如Windows的\r\n、旧Mac的\r)统一转换为\n,在写入时把\n自动翻译为当前操作系统的默认换行符;而二进制模式则直通底层原始字节流,不对数据做任何改动或替换。理解这一差异不仅能解决日常跨平台文本文件处理中的格式变形问题,更是杜绝图片、压缩包等非文本数据在读写时意外损毁的核心前提。
一、底层逻辑:通用换行符翻译与原始字节直通
不同操作系统在历史上对“行结束标志”有不同的规定。Unix/Linux以及现代macOS统一采用 \n(LF,十六进制 0x0A);Windows采用 \r\n(CRLF,十六进制 0x0D 0x0A);而旧版Classic Mac OS则采用 \r(CR,十六进制 0x0D)。如果程序直接暴露给不同格式的原始换行符,代码在进行行解析或正则匹配时就需要编写大量兼容逻辑。
Python在设计文件I/O接口时,通过两种截然不同的模式来划分职责:
- 文本模式('t',默认打开方式):面向字符文本。Python引入了通用换行符层(Universal Newlines Layer)。在读取时,它充当翻译中介,把外来各种形式的换行符规整为内部统一的
\n;在写入时,再将\n转换回目标系统的默认换行标记(在Windows下即为\r\n)。 - 二进制模式('b'):面向原始二进制序列。该模式彻底旁路了换行符翻译与字符编解码层。磁盘中存储的是什么字节,读取到内存中就是什么字节;内存向磁盘写入什么字节,磁盘就如实写入什么字节。
二、文本模式的处理全流程:读入标准化与写出本地化
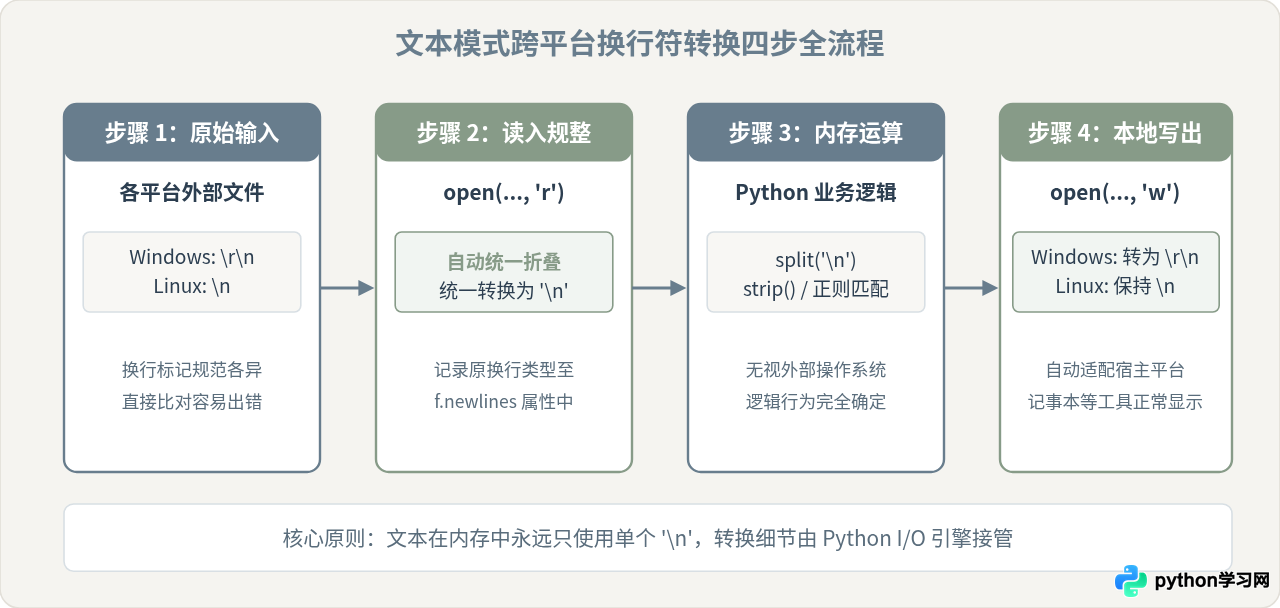
在没有显式传递 newline 参数的情况下,文本模式的工作机制分为两个明确步骤:读操作的统一化与写操作的本地化。
1. 读操作的换行符识别与转换
当通过 open(filename, 'r') 打开文件时,通用换行符支持被激活。无论文件是由Windows生成的(以 \r\n 结尾)、Linux生成的(以 \n 结尾),还是旧Mac生成的(以 \r 结尾),在通过 read() 或 readline() 读取进Python内存后,统一变成标准的 \n 字符。
# 场景:读取一个在 Windows 系统下生成的文本文件
with open("windows_notes.txt", "r", encoding="utf-8") as f:
    content = f.read()
    # 尽管磁盘中存储的是 CRLF (0x0D 0x0A)
    # Python 读出后的字符串中只有 '\n'
    print(repr(content))  # 输出示例:'第一行\n第二行\n'
    print(f.newlines)     # 属性记录了实际探测到的换行符:'\r\n'
值得注意的是,文件对象提供了 f.newlines 属性。在读取过程中,Python会自动记录文件中实际遭遇到的原始换行符类型。如果文件中混杂了多种换行符,它甚至会以元组形式呈现(如 ('\r', '\n', '\r\n'))。
2. 写操作的系统换行符适配
当在文本模式下使用 open(filename, 'w') 写入字符串时,Python规定开发者在代码中统一使用 \n 表示换行。在真正落盘之前,I/O库会将每个 \n 自动转换为目标平台的 os.linesep:
- 在 Windows 系统上执行写入,内存中的
'A\nB\n'在写入磁盘时会被替换为b'A\r\nB\r\n'。 - 在 Linux / macOS 系统上执行写入,
'A\nB\n'保持为b'A\nB\n'写入。
三、二进制模式与踩坑分析:为什么绝不能用文本模式读写二进制数据
在二进制模式(带 'b' 标志)下,Python会建立一个 BufferedReader 或 BufferedWriter 原始缓冲区对象。所有I/O操作操作的都是 bytes 对象,而不再是 str 字符串。它完全放弃了任何字符编码判定与换行符嗅探。
许多初学者容易犯一个隐蔽的错误:在读写非纯文本文件(例如PNG图片、音频、Zip包、Pickle序列化对象或可执行文件)时,漏写了 'b' 标志,直接使用了默认的文本模式。这在类Unix系统(Linux/macOS)上可能偶然不报错,但在Windows系统上会导致灾难性的数据损坏。
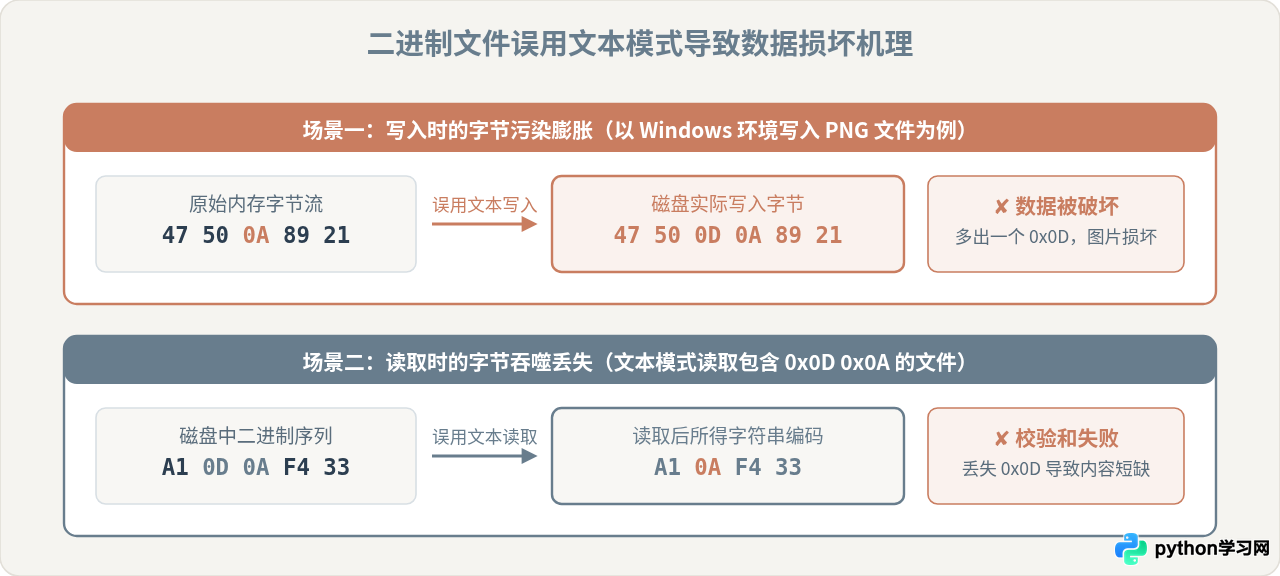
在二进制文件中,字节值 0x0A 只是普通的二进制数值(可能代表像素颜色索引、压缩字典偏移或哈希值的一部分),并不是用来分行的。如果在Windows环境下用文本模式 'w' 写出或者用 'r' 读入:
- 写入时插入 0x0D:文本模式一旦检测到字节
0x0A(字符\n),就会自作主张地在前面插入一个0x0D,将其扩充为0x0D 0x0A。原本长度为 1000 字节的图像数据可能变成了 1018 字节,所有后续偏移全部错位。 - 读取时吞噬 0x0D:如果原始二进制数据中恰好包含相邻的
0x0D 0x0A,文本模式在读取时会自动把0x0D吞噬掉,只返回一个0x0A,造成字节丢失和哈希校验失败。
下面这段对比代码直观地展示了这种差异:
# 正确的做法:处理非文本、网络原报文或固定格式二进制数据
raw_data = b"\x89PNG\r\n\x1a\n\x00\x00\x00\rIHDR"

# 1. 使用二进制模式保存与读取:绝对安全保真
with open("sample.bin", "wb") as f:
    f.write(raw_data)

with open("sample.bin", "rb") as f:
    read_bytes = f.read()
    assert read_bytes == raw_data  # 字节完全一致,毫厘不差
    print("二进制模式安全校验通过,长度:", len(read_bytes))
四、精细控制:open 函数的 newline 参数完全解析
在实际开发中,开发者有时既想享受文本模式自动编解码字符串的便利,又需要精确控制换行符,不允许Python自作主张地修改文件原有的换行风格。例如:
- 规范的 CSV 文件(根据 RFC 4180 标准)要求每行记录以
\r\n结束。 - 编写跨平台工具时,希望在 Windows 机器上生成纯正的 Linux 风格(
\n)配置文件。
Python 3 的 open() 函数通过 newline 参数提供了极具弹性的控制手段。该参数仅在文本模式下有效;在二进制模式下传入会直接抛出 ValueError。
| 参数设置 | 读取时的行为 (read) | 写入时的行为 (write) | 典型使用场景 |
|---|---|---|---|
newline=None(默认值) |
通用换行符开启:将 \r\n、\r、\n 全部折叠为 \n |
将所有 \n 翻译为宿主操作系统的默认换行符(如 Windows 替换为 \r\n) |
常规普通文本读取、无需关心底层行尾的通用脚本 |
newline=''(空字符串) |
通用换行符保留原样:正确按行切割,但字符串尾部保留原生的 \r\n 或 \n |
直写不转换:写入的 \n 原样写出,绝不额外添加 \r |
标准库 csv 模块强制要求、跨平台文本复制保留原始格式 |
newline='\n' |
仅将 \n 视作换行符,遇到 \r 或 \r\n 中的 \r 当普通字符 |
只原样写出 \n,不做操作系统翻译 |
在任何系统(包含 Windows)上强制输出纯 Unix/Linux 格式文件 |
newline='\r\n' |
仅将 \r\n 视作换行符 |
将所有 \n 强制转换为 \r\n 写出 |
在 Linux/Mac 上强制生成规范的 Windows 文本或网络协议报文 |
以下代码演示了如何利用 newline='' 精确保持文件的原始换行符,以及为什么 Python 官方文档要求在使用 csv 模块时必须加入该参数:
import csv

# 演示:生成符合 RFC 4180 规范的 CSV 文件
# 必须指定 newline='',否则在 Windows 上 csv 模块自身写入的 \r\n 会被文本模式二次转换为 \r\r\n
with open("data.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["ID", "Name", "Role"])
    writer.writerow([1, "Alice", "Developer"])
    writer.writerow([2, "Bob", "Architect"])

# 演示:跨平台原样读取,保留真实行结束符
with open("data.csv", "r", newline="", encoding="utf-8") as f:
    for line in f:
        # line 末尾完整保留原始的 '\r\n',不被自动剔除或变异
        print("原生行数据:", repr(line))
五、选型与决策:何时用文本、何时用二进制
在面对不同的文件处理需求时,遵循一套清晰的决策链路可以彻底规避文件损坏与格式错乱:
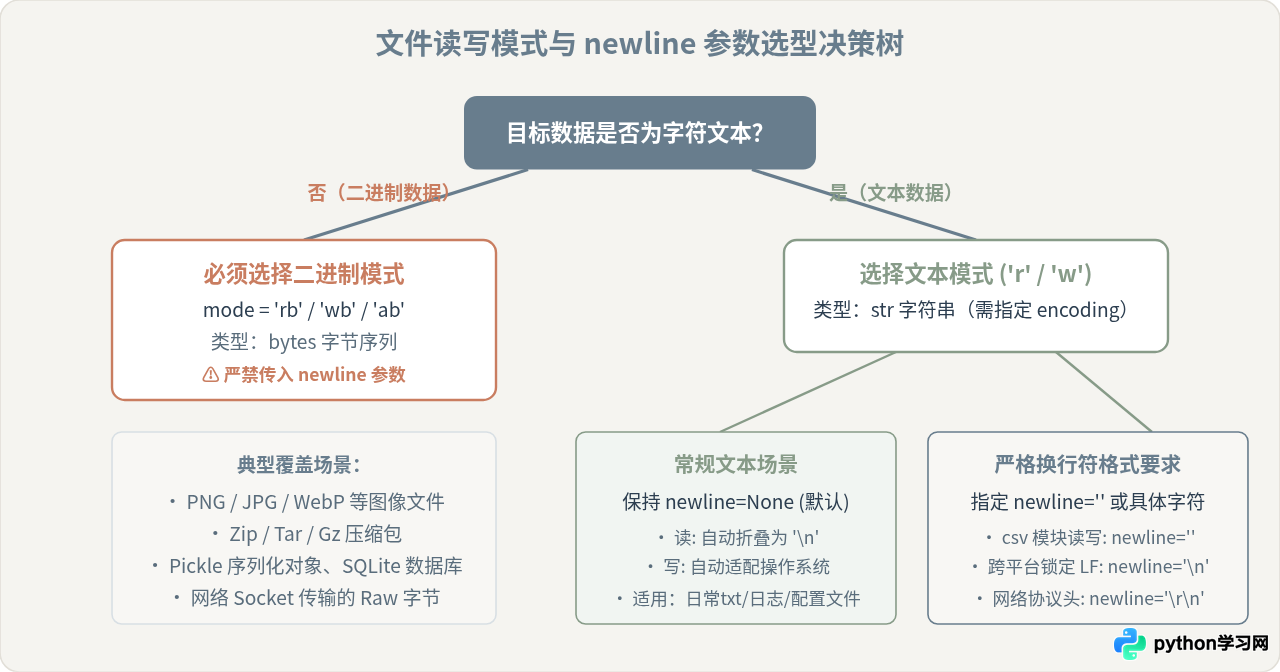
- 操作非纯文本永远加
'b':无论是直接操作图片,还是调用shutil.copyfileobj,都必须使用'rb'/'wb'。 - 写 CSV 务必加
newline='':无论是 Python 官方标准库csv还是处理表格数据流,养成显式指定newline=''的习惯,彻底避免 Windows 平台下的隔行空行 Bug。 - 文本模式明确指定
encoding='utf-8':在文本模式下,除了换行符,系统的默认字符编码也是常见的跨平台陷阱,显式声明编码能确保读写逻辑绝对确定。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















