


Python调用Kimi API实现长文档总结:代码示例与最佳实践
本文详细讲解如何使用 Python 调用 Kimi (Moonshot AI) API 实现长文档高效总结。涵盖开发环境配置、直接总结与分块合并方案对比、完整可执行代码以及生产环境下的提示词调优与错误重试最佳实践。
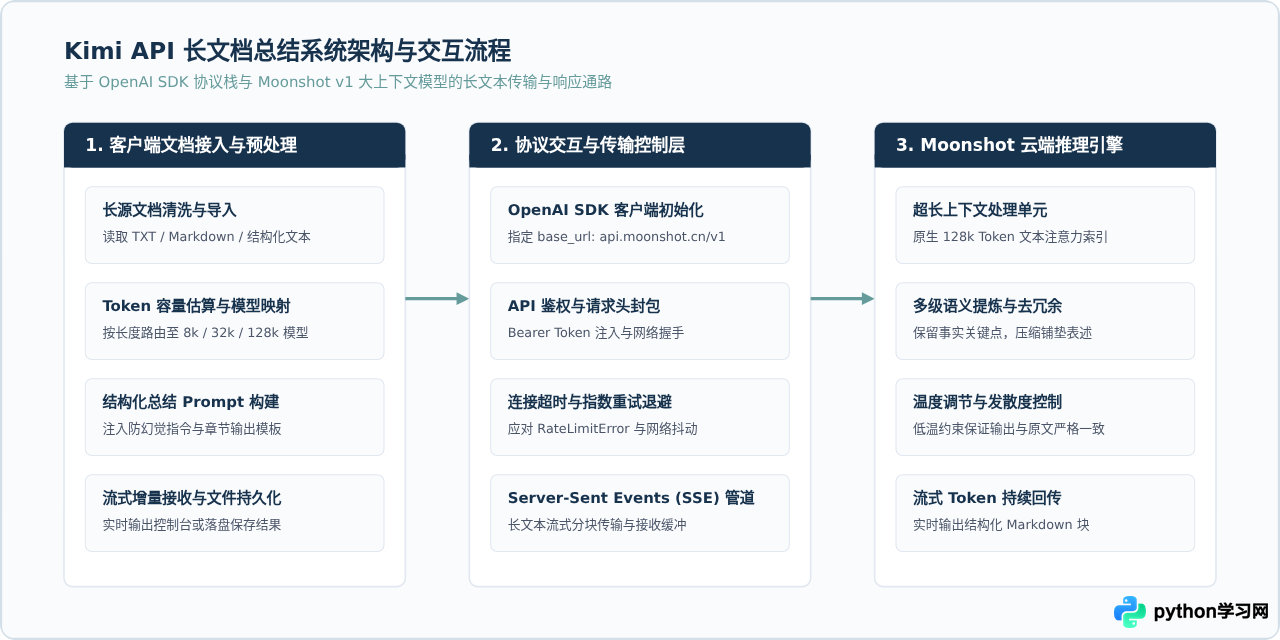
在企业知识库构建、学术文献研读和商业财报分析等场景中,快速提炼长篇文档的核心观点是一项典型需求。月之暗面(Moonshot AI)提供的 Kimi API 原生兼容 OpenAI 接口协议,且具备高达 128k token(约 20 万字)的超长上下文窗口,使得长文档摘要无需复杂的向量切分即可完成高保真提炼。本文通过具体的 Python 示例,介绍如何调用 Kimi API 进行长文档摘要、如何在大文档场景下选择适宜的总结架构,并分享在生产环境中保证输出稳定性的核心最佳实践。
一、接入准备与模型上下文选型
Kimi API 的接入基于 OpenAI 开放协议标准开发。在使用 Python 进行调用前,只需通过官方开放平台(platform.moonshot.cn)申请一个 API Key,并在本地安装官方标准的 openai SDK 即可无缝接入。
在终端中执行以下命令安装依赖:
pip install openaiKimi API 针对不同篇幅的文本提供了三种不同上下文容量的阶梯模型。在执行总结任务前,需要根据输入文本的字符规模明确选型策略:
| 模型名称 | 上下文容量 (Token) | 等效中文字数预估 | 适用文档类型 |
|---|---|---|---|
moonshot-v1-8k |
8,192 | 约 1.2 万字以内 | 单篇新闻通稿、常规博客、会议速记简报 |
moonshot-v1-32k |
32,768 | 约 5 万字以内 | 中长篇技术文档、项目周报合辑、单一业务需求说明书 |
moonshot-v1-128k |
131,072 | 约 20 万字以内 | 百页以上企业年报、完整法律合同、长篇学术论文或整本手册 |
对于长文档总结任务,推荐首选 moonshot-v1-32k 或 moonshot-v1-128k。需要注意,上下文窗口包含“输入 Prompt”与“输出 Completion”的总和。长文档的总结结果虽然通常只有数百到数千字,但原文会占据绝大多数输入额度,因此选型时应给输出预留至少 2,000 到 4,000 token 的缓冲空间。
二、单次直接总结代码实现
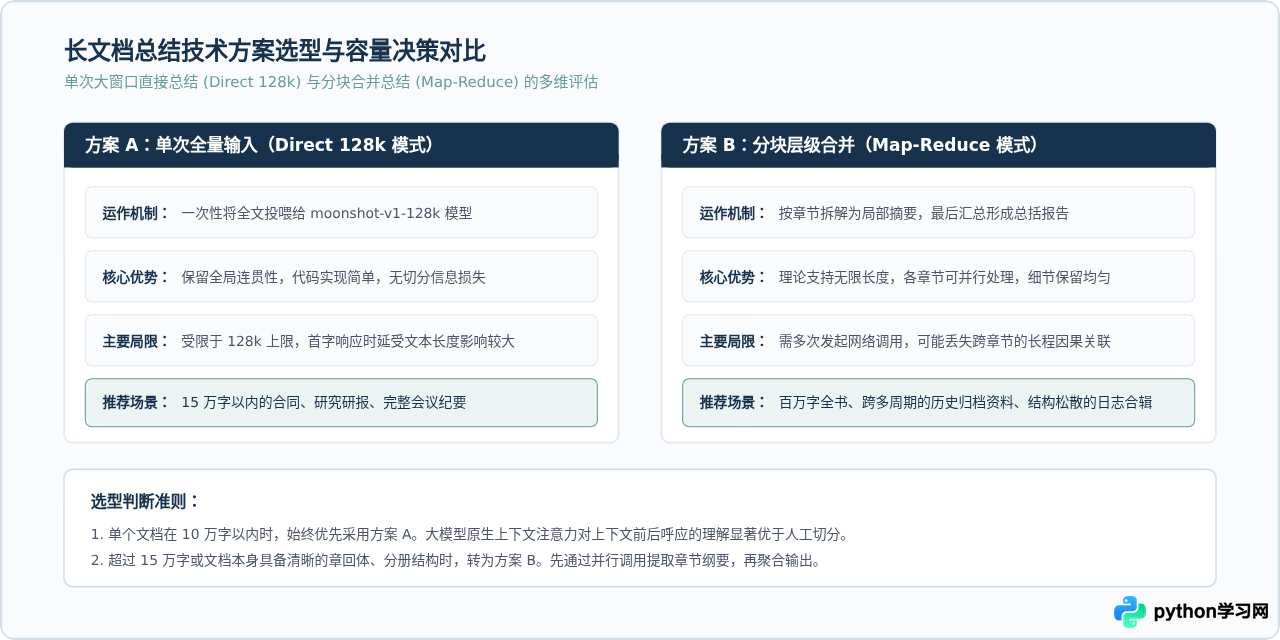
当文档整体长度未超出 moonshot-v1-128k 的容量上限时,最简明高效的策略是“单次全量输入”。这种方式将长文档一次性提交给模型,模型能够站在全篇视角建立论点之间的关联,输出的总结连贯性最高。
在编写代码时,我们需要使用结构化的 System 提示词明确约束输出框架,并启用流式输出(stream=True)。长文本生成可能需要数十秒,流式输出能避免 HTTP 客户端连接超时,并为使用者提供实时反馈。
import os
import sys
from openai import OpenAI

# 1. 初始化客户端
# 建议将 MOONSHOT_API_KEY 配置在环境变量中,避免硬编码
api_key = os.environ.get("MOONSHOT_API_KEY")
if not api_key:
    raise ValueError("未检测到 MOONSHOT_API_KEY 环境变量,请先配置再运行。")

client = OpenAI(
    api_key=api_key,
    base_url="https://api.moonshot.cn/v1",
)

def summarize_long_document(file_path: str, model_name: str = "moonshot-v1-32k") -> str:
    """
    读取本地文本文件并调用 Kimi API 进行结构化总结
    """
    if not os.path.exists(file_path):
        raise FileNotFoundError(f"未找到目标文件: {file_path}")

    with open(file_path, "r", encoding="utf-8") as f:
        document_content = f.read().strip()

    if not document_content:
        return "输入文件为空,无法生成总结。"

    print(f"正在读取文档: {file_path} (文本长度: {len(document_content)} 字符)")
    print(f"选用模型: {model_name},正在向 Kimi API 发起请求...\n")

    # 2. 构造严谨的系统指令与用户提示词
    system_prompt = (
        "你是一名专业的数据分析与文档研读专家。请严格基于用户提供的文档正文完成总结,"
        "不得引入正文未提及的事实或主观推断。输出内容要求语言精炼、逻辑分明。\n"
        "请按照以下结构进行输出:\n"
        "1. 【全篇概括】:用 200 字以内的短段落交代文档的核心主旨与结论。\n"
        "2. 【核心要点】:分条列出 3-6 个关键事实或核心论据,突出具体方案与结果。\n"
        "3. 【关键细节与数据】:列出正文中提及的关键指标、时间节点或硬性约束。\n"
        "4. 【潜在风险或行动项】:若文档包含待办、风险或争议点,请明确指出;若无则注明无。"
    )

    user_prompt = f"以下是需要总结的完整文档内容:\n\n{document_content}"

    # 3. 发起流式调用
    try:
        response = client.chat.completions.create(
            model=model_name,
            messages=[
                {"role": "system", "content": system_prompt},
                {"role": "user", "content": user_prompt},
            ],
            temperature=0.3,  # 低温度确保严格忠于原文
            stream=True,
        )

        collected_chunks = []
        print("====== 总结结果开始 ======\n")
        for chunk in response:
            content = chunk.choices[0].delta.content
            if content:
                sys.stdout.write(content)
                sys.stdout.flush()
                collected_chunks.append(content)
        print("\n\n====== 总结结果结束 ======")

        return "".join(collected_chunks)

    except Exception as e:
        print(f"\nAPI 调用异常: {e}", file=sys.stderr)
        raise

if __name__ == "__main__":
    # 示例执行入口
    sample_file = "sample_report.txt"
    if os.path.exists(sample_file):
        summarize_long_document(sample_file, model_name="moonshot-v1-128k")
    else:
        print(f"请准备测试文本并保存为 {sample_file} 后测试。")
在上面的代码中,temperature=0.3 是文档总结任务的关键参数。较高的温度值(如 0.8 或 1.0)虽然能增加文字多样性,但在摘要场景下容易引起模型的过度联想,甚至编造不存在的数据;而 0.3 的取值能让模型严格收敛于原文细节,确保提炼结论真实可靠。
三、超长体量文本的分块总结(Map-Reduce)实践
尽管 128k 上下文已能满足大部分场景,但在面对整套技术规程、行业白皮书合辑或几百页的历史案件卷宗时,单次请求依然可能超出限制。此外,长上下文模型存在“中间信息丢失”(Lost in the Middle)的现象——对文本首尾内容的关注度通常高于正文中间段落。采用分块总结(Map-Reduce)架构可以有效解决这些问题。
Map-Reduce 总结分为两阶段:
- Map 阶段(分段提炼):按照固定长度(如每块 1 万字)并设置重叠区间(如 500 字滑动窗口)将大文本拆分,调用
moonshot-v1-8k或32k模型分别提炼每个分块的关键事实。 - Reduce 阶段(整合归纳):将所有分块的提炼结果按顺序串联,再次送入模型做全篇整合,输出一份结构紧凑、脉络清晰的总报告。
以下是使用 Python 实现的分块总结核心逻辑:
import math
from typing import List
from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("MOONSHOT_API_KEY"),
    base_url="https://api.moonshot.cn/v1",
)

def chunk_text(text: str, chunk_size: int = 15000, overlap: int = 800) -> List[str]:
    """
    将长文本切分为带重叠窗口的分块列表
    """
    chunks = []
    start = 0
    total_len = len(text)

    while start < total_len:
        end = start + chunk_size
        chunk = text[start:end]
        chunks.append(chunk)
        if end >= total_len:
            break
        start += (chunk_size - overlap)
    return chunks

def map_reduce_summarize(full_text: str) -> str:
    """
    分块映射与归纳总结执行流程
    """
    chunks = chunk_text(full_text, chunk_size=12000, overlap=600)
    print(f"文档总长度 {len(full_text)} 字,已拆分为 {len(chunks)} 个处理分块。")

    intermediate_summaries = []

    # Map 阶段:逐块提取核心要点
    for idx, chunk in enumerate(chunks, 1):
        print(f"正在处理第 {idx}/{len(chunks)} 块...")
        prompt = (
            "请阅读以下文档片段,提取该片段中的核心论据、数据事实与关键进展。"
            "用 300 字以内的清晰要点列出,去除冗余修饰,保持客观。\n\n"
            f"片段内容:\n{chunk}"
        )
        resp = client.chat.completions.create(
            model="moonshot-v1-8k",
            messages=[{"role": "user", "content": prompt}],
            temperature=0.3,
        )
        sub_summary = resp.choices[0].message.content.strip()
        intermediate_summaries.append(f"【分块 {idx} 纲要】:\n{sub_summary}")

    # Reduce 阶段:整合所有子摘要
    print("\n所有分块处理完毕,正在进行全篇归纳 (Reduce)...")
    combined_notes = "\n\n".join(intermediate_summaries)
    reduce_prompt = (
        "以下是一篇超长文档各章节的核心提炼记录。请基于这些记录,撰写一份结构严谨的最终总结报告。\n"
        "要求:\n"
        "1. 梳理出贯穿全篇的核心发展脉络。\n"
        "2. 整合各章节提到的关键数据与核心结论。\n"
        "3. 形成条理清晰的结论总结。\n\n"
        f"各章节提炼记录:\n{combined_notes}"
    )

    final_resp = client.chat.completions.create(
        model="moonshot-v1-32k",
        messages=[{"role": "user", "content": reduce_prompt}],
        temperature=0.3,
    )

    return final_resp.choices[0].message.content
在切分文本时,设置一定大小的滑动重叠(Overlap)至关重要。重叠部分能确保位于分块边界处的句子、段落或核心论点不会被截断,从而避免模型因语境破碎产生理解偏差。
四、生产落地最佳实践与参数调优
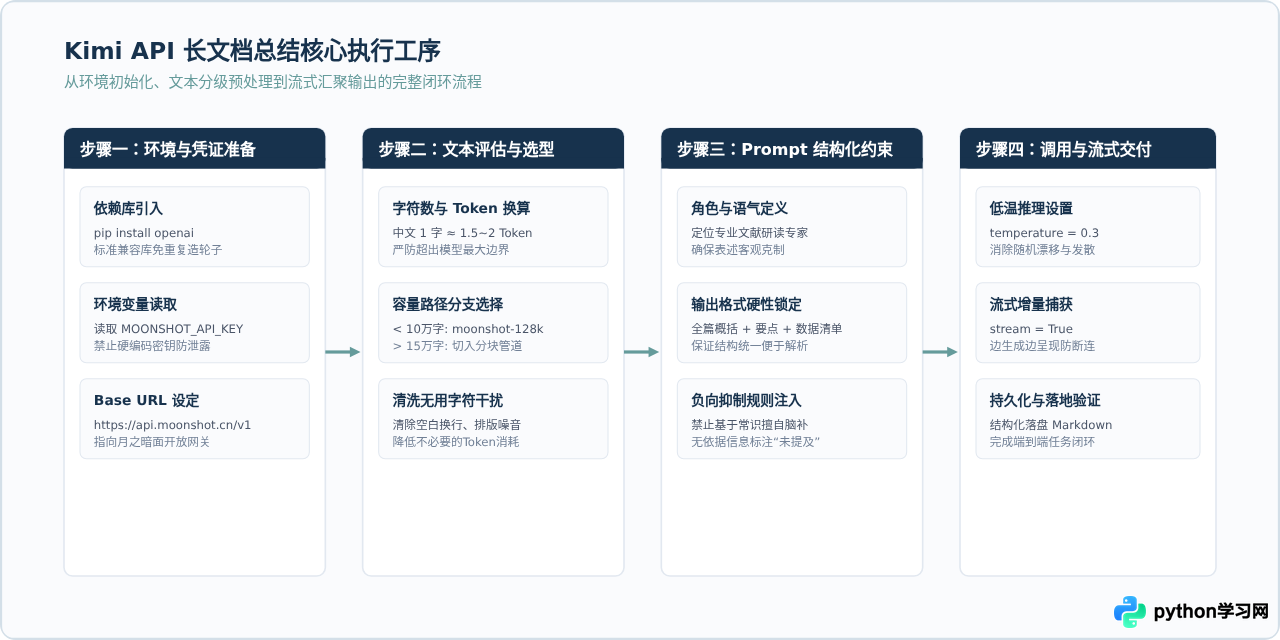
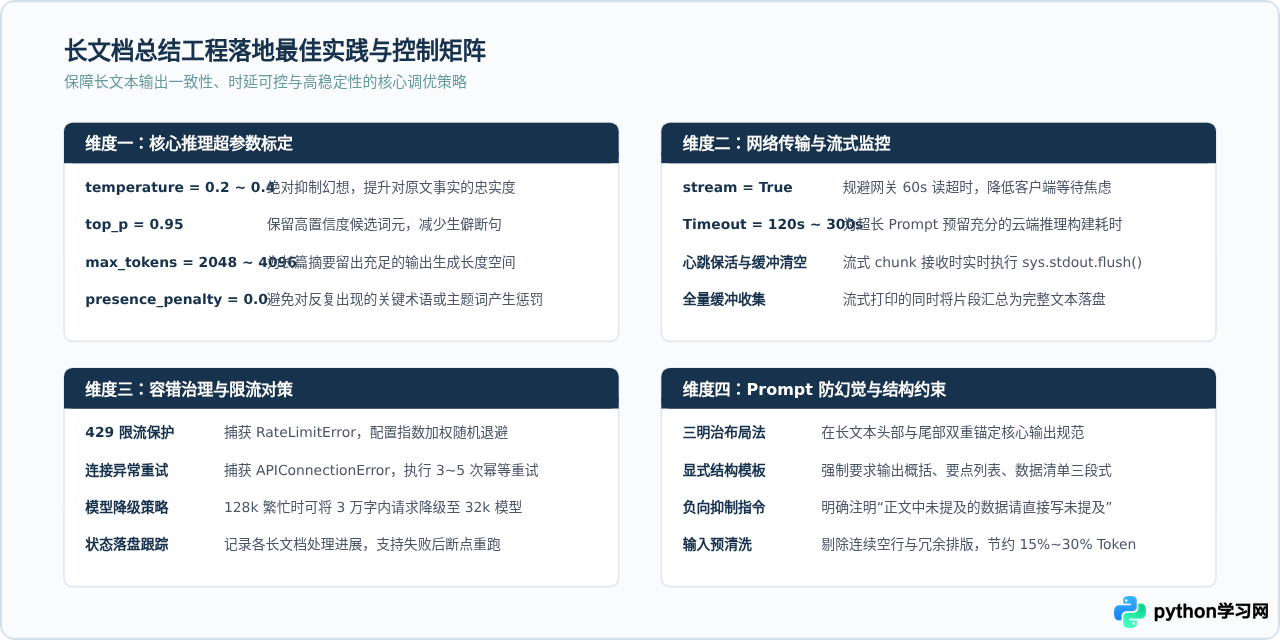
在将长文档总结脚本接入生产流水线(如自动化研报分析服务、工单自动分类器等)时,除了基础调用之外,还需要关注以下四个维度的工程优化:
1. 异常处理与指数退避重试
长文档请求包含巨大的输入 token,极易触碰 API 的并发或速率限制(RPM/TPM)。在直接调用时,若遇到 openai.RateLimitError 或偶发性的网络丢包,不可直接抛错退出,必须配置带有抖动的指数退避重试机制。
import time
import random
import openai

def call_with_retry(client, **kwargs):
    """
    带有指数退避与随机抖动的重试封装函数
    """
    max_retries = 5
    base_delay = 2.0

    for attempt in range(1, max_retries + 1):
        try:
            return client.chat.completions.create(**kwargs)
        except openai.RateLimitError as e:
            if attempt == max_retries:
                raise
            # 指数退避加随机抖动,避免大量并发请求在同一时刻碰撞重试
            delay = base_delay * (2 ** (attempt - 1)) + random.uniform(0.5, 1.5)
            print(f"[警告] 触发速率限制,正在执行第 {attempt} 次重试,等待 {delay:.2f} 秒...")
            time.sleep(delay)
        except openai.APIConnectionError as e:
            if attempt == max_retries:
                raise
            print(f"[网络抖动] 连接失败: {e},将在 3 秒后重试...")
            time.sleep(3)
        except openai.APIStatusError as e:
            # 状态码 4xx/5xx 处理
            print(f"[服务异常] 状态码: {e.status_code},响应: {e.response}")
            raise
2. Prompt 工程:防止长文本信息稀释
当输入文本达到数万字时,模型很容易遗忘 Prompt 前半部分提出的细小指令。为了增强指令约束力,推荐采用“三明治结构”布局 Prompt:
- 前端引导:在文档上方先明确角色定位、输出目标与负向约束;
- 正文注入:在中间段落放置完整的待总结长文本内容;
- 尾部锚定:在文档最底部再次重申核心要求(如“请牢记:严格基于上述文本输出,包含概括、要点与关键数据三部分”)。
3. 成本控制与文本预清洗
长文档总结的计费主要消耗在输入 Token 上。在将文档送入 API 之前,进行轻量级预清洗能够节约 15%~30% 的 Token 开销:
- 过滤网页抓取文本中残留的 HTML/CSS 标签和无用脚本;
- 合并连续三个以上的空行或无效分隔符;
- 去除纯版权声明、免责声明页眉页脚等非核心主体内容。
五、常见报错排查与验证
在实际接入调用中,开发者容易遇到以下几个常见报错:
openai.AuthenticationError: 401 Unauthorized:API Key 配置错误或未激活。需登录开放平台控制台核对 Key 的有效性,并确认是否有多余的空格字符。openai.BadRequestError: 400 Context Window Exceeded:输入文本与预留输出长度的总和超出了所选模型的上限。解决办法是将模型升级为moonshot-v1-32k或moonshot-v1-128k;若已是 128k 模型仍超限,则需切换为分块总结(Map-Reduce)架构。openai.RateLimitError: 429 Too Many Requests:请求并发数或单分钟 Token 消耗量超过账户等级限额。生产环境中除增加退避重试外,还应在本地建立请求队列以平滑突发流量。- 长请求连接中断或读超时:调用长文本模型时,如果未配置
stream=True,某些云网关会在 60 秒无数据传输后主动断开 HTTP 连接。切换为流式接收即可保持链路活跃。
总结:Kimi API 提供的 128k 超大上下文和标准的 OpenAI SDK 兼容性,大幅降低了长文本摘要的技术门槛。在实际落地中,遵循“10 万字以内单次直接总结、超大规程分块 Map-Reduce、低温推理配合流式输出”的技术路线,即可快速构建出高可用、高保真的长文档智能总结系统。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















