


Python list.sort()原地排序特性:为什么赋值后得到None
深入解析Python中list.sort()就地排序机制,解释为什么赋值后变量会变成None,对比list.sort()与sorted()的区别并提供正确的修复方案与最佳实践。
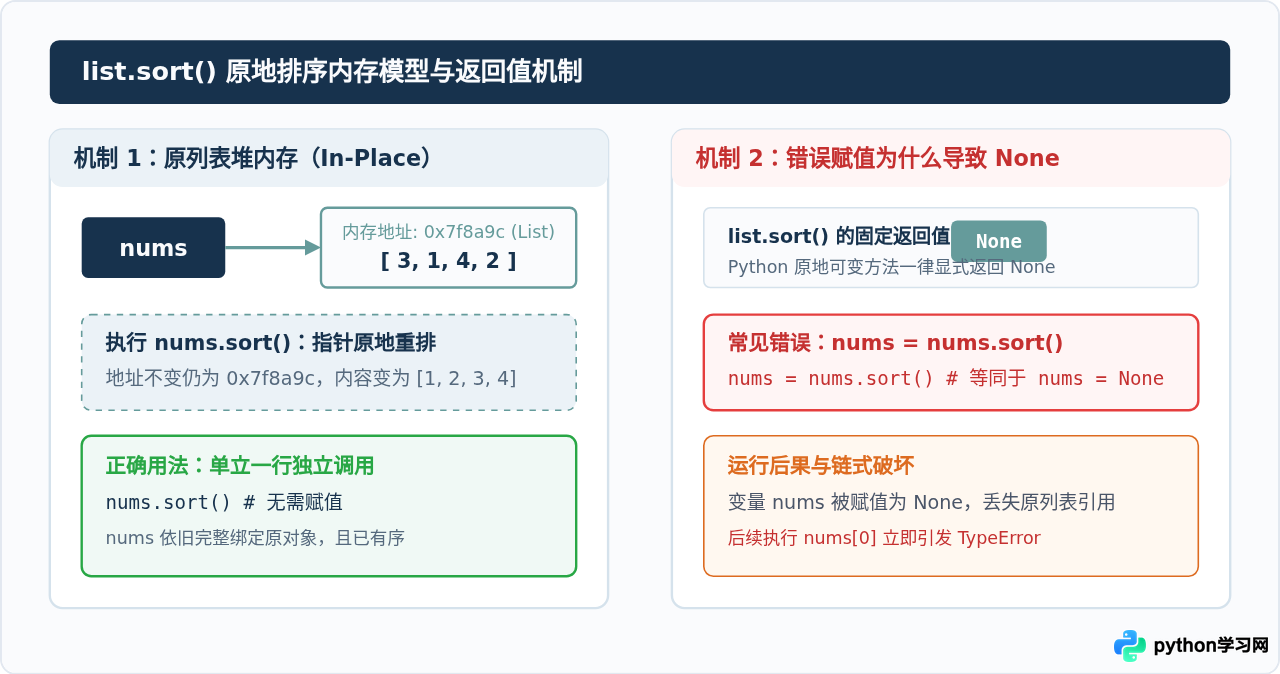
很多刚接触 Python 的开发者在对列表排序时,经常会顺手写下 numbers = numbers.sort() 这样的代码,紧接着在后续调用时便会遭遇意外的 None,甚至引发 TypeError: 'NoneType' object is not subscriptable 报错。产生这个现象的根本原因非常纯粹:Python 的 list.sort() 是一个“原地排序”(In-Place)方法,它直接在原列表所在的内存空间中调整元素顺序,自身并不返回新列表,其函数的返回值固定为 None。一旦将其执行结果赋值给变量,原变量保存的列表引用就会被 None 彻底覆盖。
一、为什么赋值后得到的是 None?
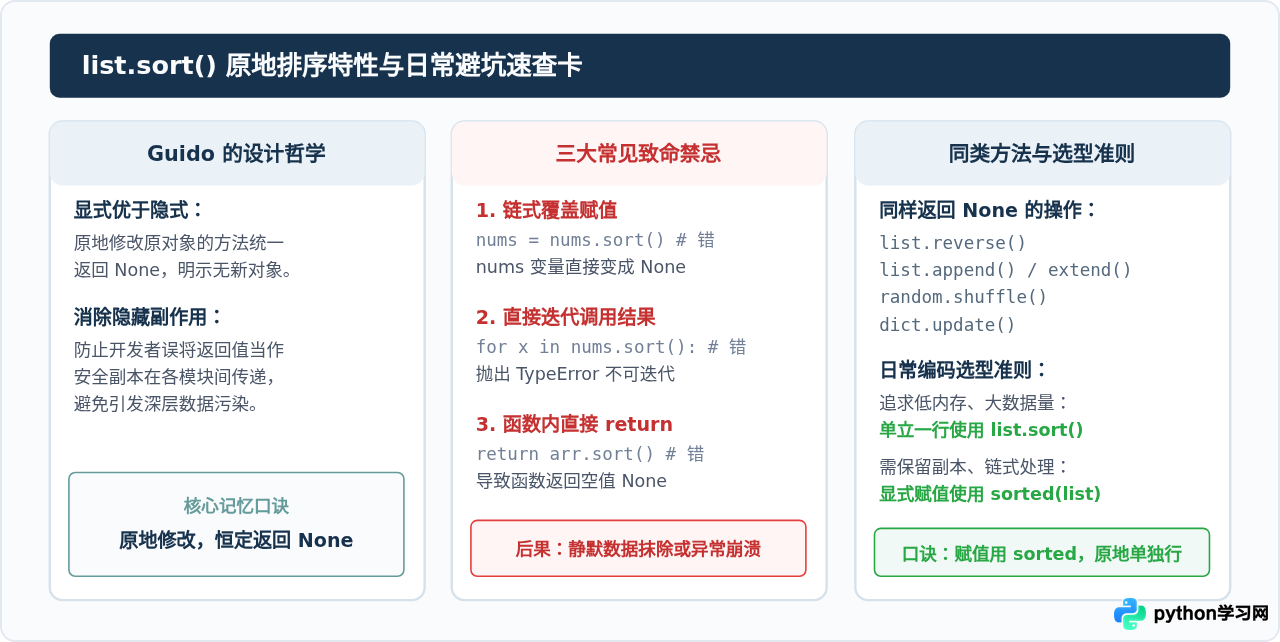
在 Python 中,方法对调用对象产生的副作用(是否修改对象自身)与返回值之间有一套严谨的 API 设计约定。Python 之父 Guido van Rossum 在设计内置类型时确立了一条重要原则:凡是原地直接修改原对象自身的可变类型方法,都统一返回 None。
这条设计约定的主要目的,是为了防止开发者对“是否产生了新对象”产生误解。如果 list.sort() 在就地修改列表的同时又返回了原列表对象,开发者就很容易误以为这个方法创建并返回了一份排好序的全新副本。随后在不知情的情况下把返回值传递给其他函数,修改该返回值就会引发不可预期的连带修改 Bug。
二、日常开发中最容易踩坑的三大错误场景
虽然原理十分清晰,但在实际编码时,开发者常常会因为思维惯性而在以下三个场景中不经意犯错:
1. 误将结果重新赋值给原变量
# 错误示例:重新赋值
scores = [88, 72, 95, 60]
scores = scores.sort()
print(scores)  # 输出: None
很多其他语言或工具链(如某些字符串处理方法或流式 API)习惯通过链式赋值更新变量,导致开发者下意识写出 a = a.sort()。执行之后,不仅没有得到有序列表,原有的数据引用也直接丢失。
2. 在循环或推导式中直接遍历 sort() 的结果
# 错误示例:遍历排序结果
names = ["Bob", "Alice", "David"]
for name in names.sort():  # 抛出 TypeError: 'NoneType' object is not iterable
    print(name)
因为 names.sort() 返回的是 None,而 None 并非可迭代对象,解释器会立即在 for 循环的第一行抛出异常。
3. 在函数中直接 return 排序调用的结果
# 错误示例:直接 return
def get_sorted_records(data):
    # 期望返回排序后的数据,实际却返回了 None
    return data.sort()

result = get_sorted_records([5, 2, 8])
print(result)  # 输出: None
这个隐患在业务代码中尤为隐蔽,经常导致调用该函数的下游代码在很久之后才抛出空指针或空对象异常,增加排查难度。
三、两种正确的解决方案
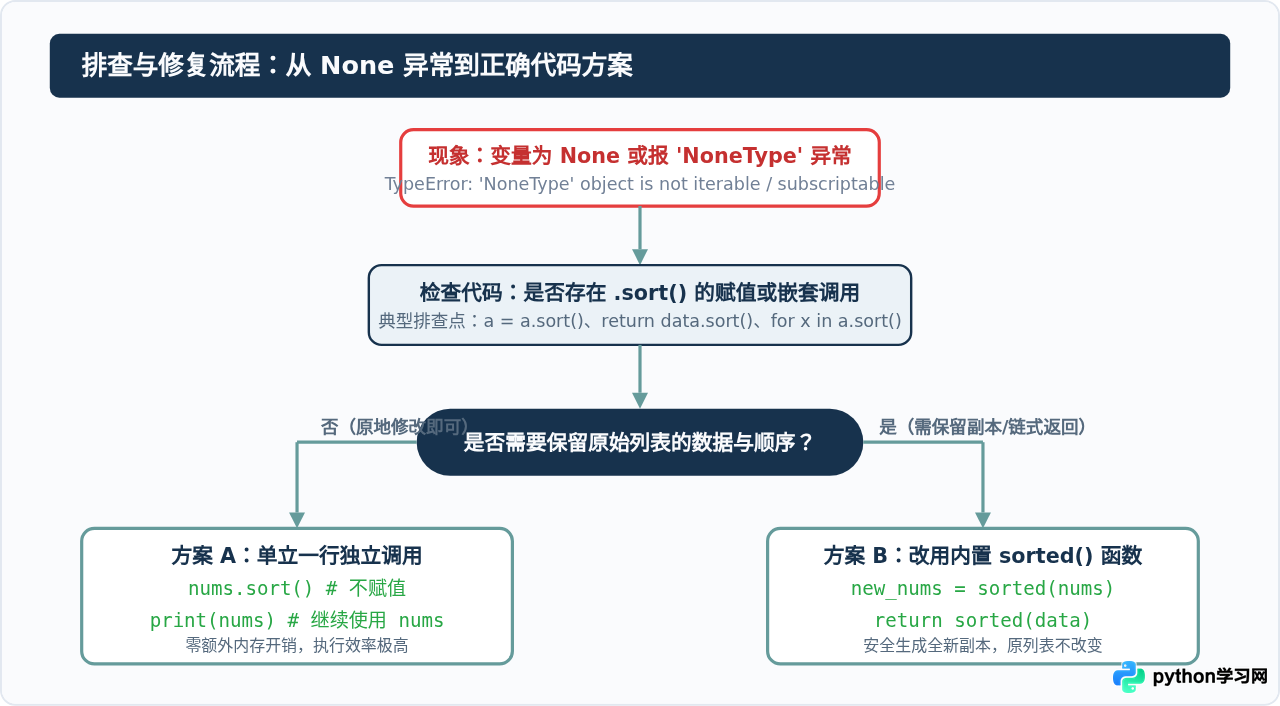
针对不同的业务场景,Python 分别提供了对应最佳实践的解决方案:
方案一:继续使用 list.sort(),但单立一行不进行赋值
如果你不需要保留列表原来的顺序,或者列表元素规模较大(如几十万条数据),优先使用 list.sort() 是最明智的,因为它不需要分配新的列表内存空间(空间复杂度为 O(1))。正确的写法是将排序操作独立成一行:
# 正确写法:单立一行调用
numbers = [38, 27, 43, 3, 9, 82, 10]

# 直接调用,不要写 numbers = numbers.sort()
numbers.sort()

# 在后续代码中直接使用已排序的 numbers
print(numbers)  # 输出: [3, 9, 10, 27, 38, 43, 82]

# 支持 reverse 与 key 参数
numbers.sort(reverse=True)
print(numbers)  # 降序: [82, 43, 38, 27, 10, 9, 3]
方案二:改用内置函数 sorted(),安全获取新列表
如果你需要将排序结果赋值给新变量、保留原列表原始顺序、或者在函数中直接 return,应当使用 Python 内置的 sorted() 函数。它会创建一个排好序的新列表并返回,完全不触碰原对象:
# 正确写法:使用 sorted() 进行赋值
original_scores = [88, 72, 95, 60]

# sorted() 返回一个全新的有序列表
sorted_scores = sorted(original_scores)

print("新列表:", sorted_scores)      # 输出: [60, 72, 88, 95]
print("原列表:", original_scores)    # 输出: [88, 72, 95, 60](原样保留)

# 支持在函数中直接返回或在循环中直接遍历
def sort_user_ages(ages):
    return sorted(ages)

for age in sorted([25, 18, 30]):
    print(age)
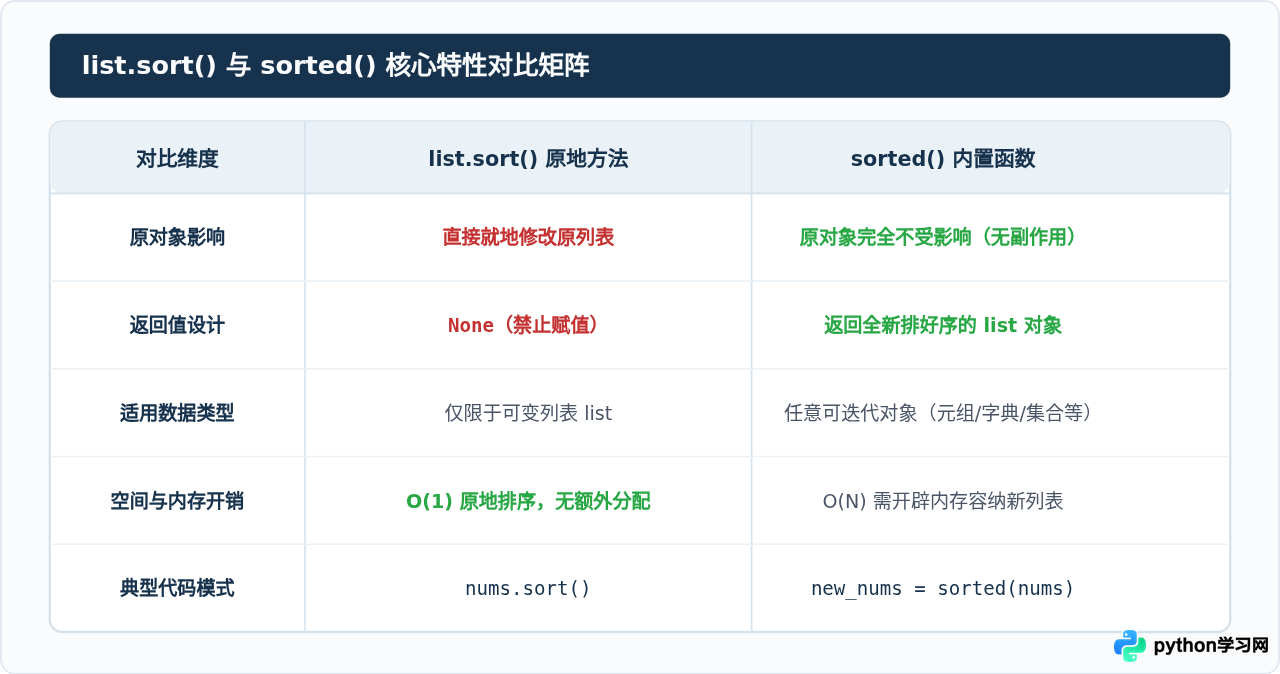
四、list.sort() 与 sorted() 核心特性对比
为了在实际编码中做出正确的选型决策,我们可以从底层修改方式、返回值、适用类型及内存成本等多个维度对两者进行全面对照:
五、原理延伸:Python 中其他遵循“就地返回 None”原则的常见方法
理解了 list.sort() 的设计哲学后,你就会发现 Python 标准库中大量方法都遵循着相同的契约。只要牢记“凡是原地修改容器内部结构的操作,返回值通常都是 None”,就能在编写其他代码时举一反三,避开同类陷阱:
list.reverse():就地反转列表元素,返回值同样是None。反转并获取新列表应使用reversed()或切片[::-1]。list.append(item)与list.extend(iterable):就地向列表中追加元素,返回None。random.shuffle(seq):就地随机打乱序列顺序,返回None。切勿写出shuffled = random.shuffle(arr)。dict.update(other):就地更新字典键值对,返回值同样是None。
六、总结
list.sort() 执行后返回 None 不是 Python 的设计缺陷,而是为了保证数据安全、杜绝隐式对象拷贝所确立的明晰规范。解决这一问题的关键规则非常简单:
- 如果你想修改原列表且无需生成新对象:直接单独写一行
nums.sort(),绝对不要进行等号赋值。 - 如果你想保留原始数据或将排序结果赋值给新变量:直接使用内置函数
new_nums = sorted(nums)。
掌握原地修改与函数式返回的界限,不仅能彻底告别 None 覆盖变量的困扰,也能让你写出的 Python 代码更加规范、优雅和可靠。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















