


Python修饰器工作原理:函数是怎么被增强的
深入解析Python修饰器(装饰器)的工作机制,从一等公民函数、闭包作用域到语法糖展开,系统阐明函数在不修改原代码的前提下是如何完成逻辑包装与透明增强的。
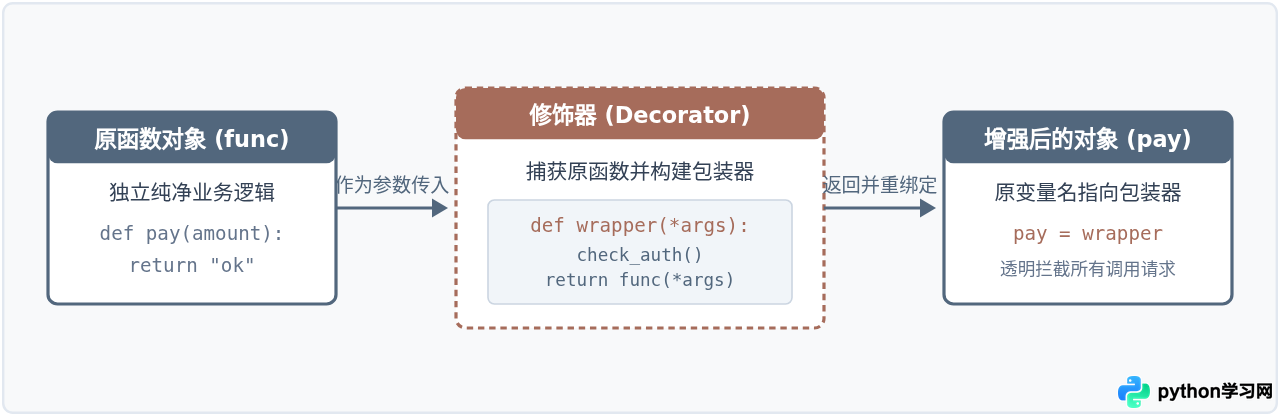
Python 修饰器(Decorator,常称装饰器)的核心机制并非在底层改写原函数的二进制字节码,而是在模块加载或定义期利用闭包特性,将原函数封装进一个代理包装函数(wrapper),并将原函数名重新绑定给该代理对象。外界后续调用该函数名时,执行的实际上是具有前置、后置增强逻辑的包装函数。
一、基础支撑:函数在 Python 中作为“一等公民”
要透彻理解修饰器,必须先明确 Python 的底层对象哲学:函数是一等对象(First-Class Object)。这意味着函数与普通的整数、字符串或列表没有本质区别。函数本身是一个存在于堆内存中的 PyFunctionObject 实例,函数名仅仅是一个指向该内存地址的局部或全局变量标识符。
既然函数名只是普通的引用变量,就必然支持三项核心操作:
- 作为参数传递:可以将一个函数名传递给另一个接收函数的形参;
- 作为返回值交付:可以在一个函数体内定义新函数,并将其作为执行结果返回;
- 变量重命名与覆盖:可以随时将一个全新的函数对象赋值给原有的函数名变量。
修饰器之所以能够成立,正是建立在上述三项特性的组合之上。我们可以通过简单的纯手动代码还原这一过程:
def log_decorator(func):
    def wrapper(*args, **kwargs):
        print(f"[日志] 正在执行: {func.__name__}")
        result = func(*args, **kwargs)
        print(f"[日志] 执行完毕")
        return result
    return wrapper

def send_email(address):
    print(f"向 {address} 发送邮件")

# 手动增强:原变量名 send_email 重新指向 wrapper
send_email = log_decorator(send_email)
send_email("test@example.com")
执行 send_email("test@example.com") 时,外部感知不到任何语法差异,但控制台却输出了前后两条日志。这便是修饰器的一切雏形。
二、关键基石:闭包与自由变量的作用域绑定
在上面的手动增强代码中,常常引发初学者困惑的一点是:在 log_decorator(send_email) 执行完毕后,log_decorator 已经出栈并返回了,为什么新函数 wrapper 在未来被调用时,仍然能够准确找到并调用最初的 func 变量?
答案是闭包(Closure)。当内部函数(wrapper)引用了外层非全局函数(log_decorator)的局部变量(func)时,Python 不会像处理普通局部变量那样在函数退出时直接回收它,而是将该变量转化为一个自由变量(Free Variable),打包存入包装函数的 __closure__ 属性中。
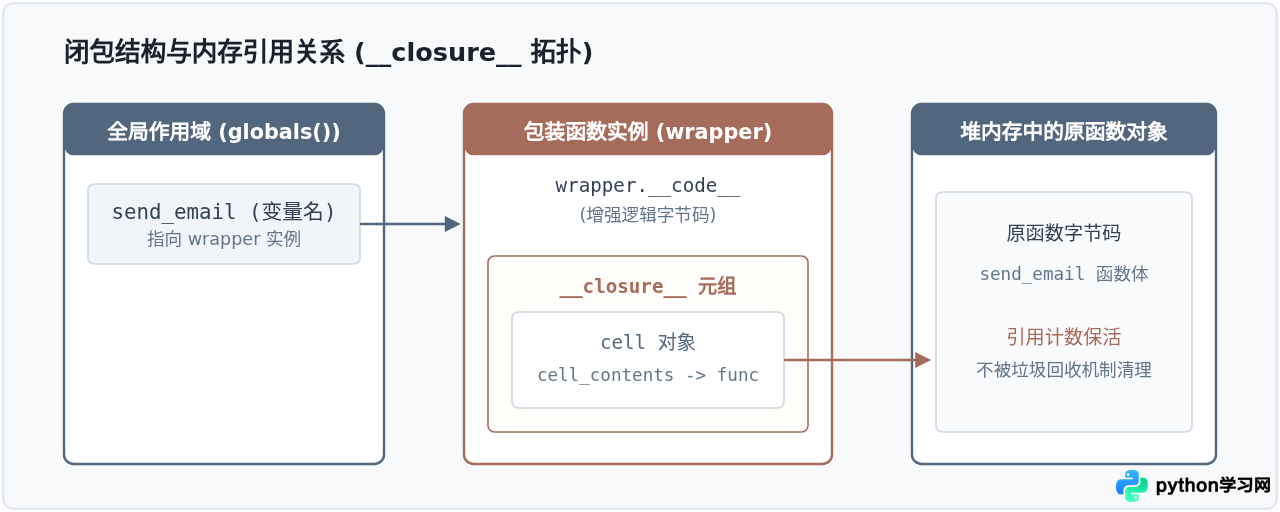
你可以通过 Python 内置属性直观验证该机制:打印 send_email.__closure__[0].cell_contents,会直接显示原函数的引用。闭包在此充当了一座“桥梁”,使得原函数始终常驻内存,随时等待包装函数在执行到对应步骤时代为触发。
三、语法糖 @ 的本质与展开推导
Python 在 2.4 版本正式引入了 @ 符号。很多开发者容易将 @ 视为某种“黑魔法”,认为解释器在每次运行到函数调用时都会去动态拦截。事实恰好相反:@ 只是一个极为纯粹的编译期/定义期语法糖。
语法糖的展开规则极其固定且透明。当解释器解析到以下代码时:
@log_decorator
def calculate(a, b):
    return a + b
它完全等价于:
def calculate(a, b):
    return a + b
calculate = log_decorator(calculate)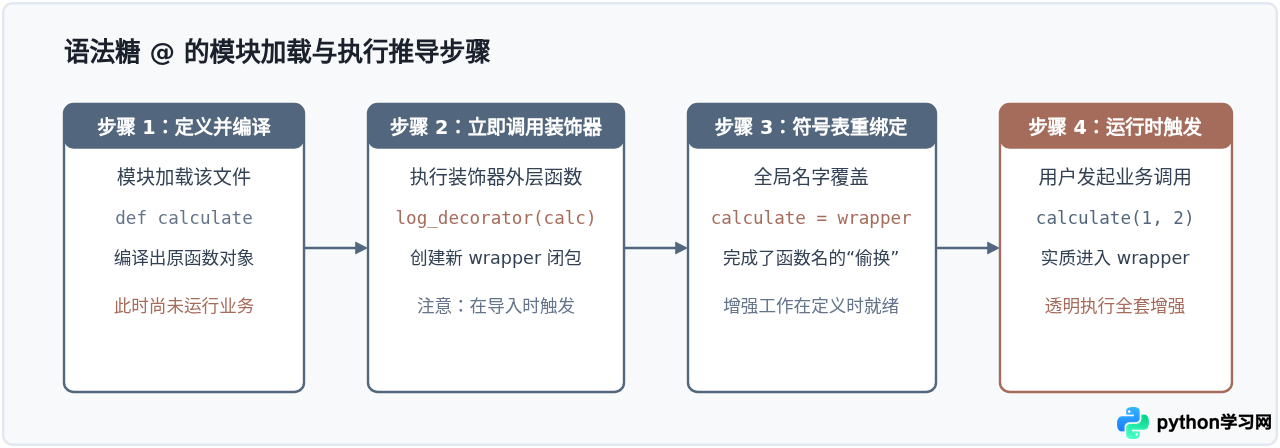
关键认知:增强发生在什么时候?
修饰器的外层函数是在模块导入(import)或脚本被 Python 读取定义时立即执行的,并不是等函数被首次调用时才跑。如果修饰器函数外部写了耗时操作或副作用代码,会导致程序启动速度大幅变慢。
四、运行时控制流:参数穿透、返回值接力与元数据修复
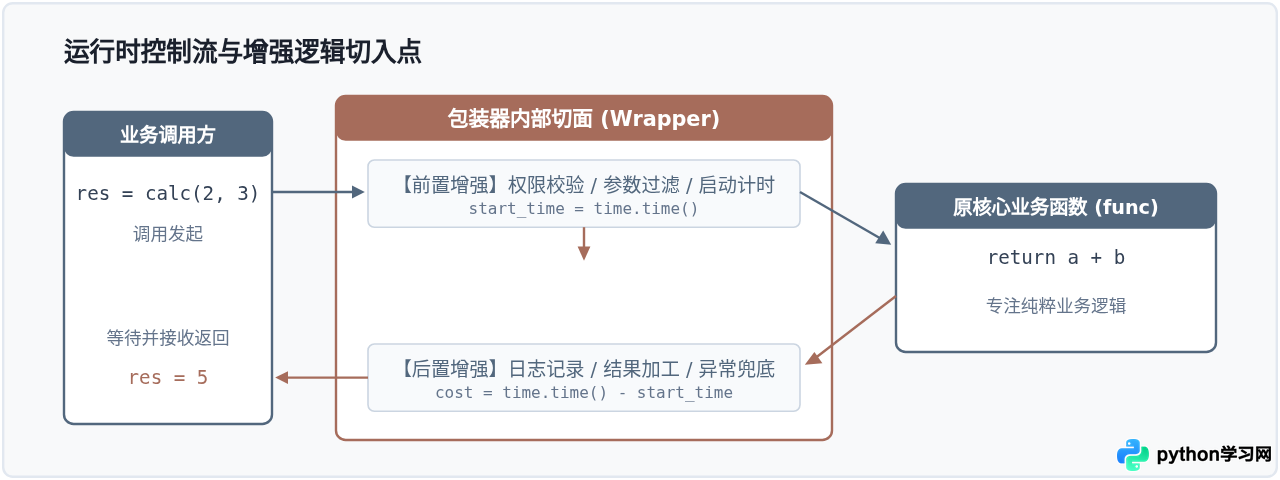
当原函数被替换为 wrapper 之后,一次真实的函数调用会经历严谨的控制流接力。为了保证修饰器的通用性与透明性,包装器必须规范处理以下三个核心细节:
- 通用入参代理(
*args, **kwargs):装饰器通常并不知道原函数具体有多少个位置参数或关键字参数。wrapper(*args, **kwargs)可以完整打包任意形式的参数,并在内部以func(*args, **kwargs)解包转发。 - 返回值中转:许多新手常犯的错误是直接写
func(*args, **kwargs)却忘记return result。如果包装函数不显式 return 原函数的运算结果,外部调用方收到的返回值将永远是None。 - 函数元数据丢失与
functools.wraps:因为func已经变成了wrapper,如果不做修复,执行calculate.__name__会返回'wrapper',函数原有的 docstring(文档注释)和签名也会一并丢失。标准库提供的@functools.wraps(func)负责将原函数的元属性自动复制到wrapper上。
五、进阶场景:带参数的修饰器是如何工作的
我们在很多框架中经常见到带配置参数的修饰器,例如重试机制 @retry(max_times=3) 或路由注册 @app.route('/login')。这种装饰器比普通装饰器多了一层嵌套,本质是装饰器工厂函数(Decorator Factory)。
它的结构由三层嵌套组成:
import functools

def retry(max_times=3):
    # 第一层:外层工厂,接收修饰器的配置参数
    def decorator(func):
        # 第二层:真正的修饰器,接收目标函数
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            # 第三层:最终的代理包装器,处理业务参数与控制流
            for attempt in range(1, max_times + 1):
                try:
                    return func(*args, **kwargs)
                except Exception as e:
                    print(f"第 {attempt} 次失败: {e}")
                    if attempt == max_times:
                        raise
        return wrapper
    return decorator

@retry(max_times=3)
def query_database(sql):
    ...
按照语法糖展开推导,带参数修饰器的解析过程是:
# 第一步:先执行工厂函数,得到返回的 decorator
temp_decorator = retry(max_times=3)

# 第二步:将原函数传给该 decorator,得到真正的 wrapper
query_database = temp_decorator(query_database)
合并起来即为 query_database = retry(max_times=3)(query_database)。三层结构层层嵌套,外层闭包持有配置参数 max_times,中层闭包持有原函数 func,内层包装器负责在运行时实现多轮重试控制。
六、总结:装饰器的多层复合与本质认知
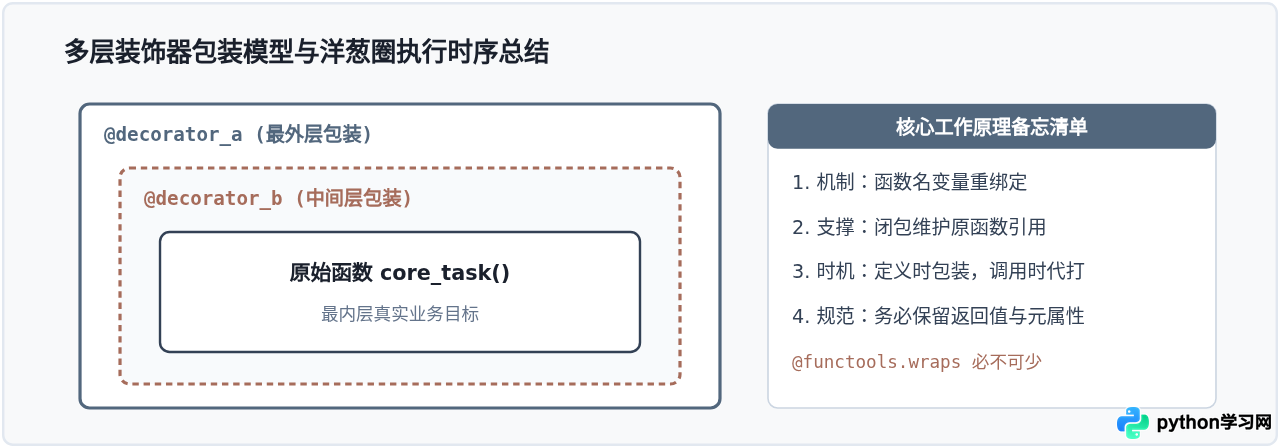
当一个函数上方同时应用了多个装饰器时,其复合顺序也是基于同一套展开原理。例如:
@decorator_a
@decorator_b
def task():
    pass
按照展开规则,它等价于:
task = decorator_a(decorator_b(task))这决定了多修饰器的两个黄金准则:
- 包装顺序(定义期):自下而上(先执行
decorator_b包装原函数,再由decorator_a包装decorator_b的返回结果); - 调用顺序(运行时):自外而内(外部调用
task()时,先进入decorator_a的前置逻辑,再进入decorator_b的前置逻辑,触达原函数后,按相反顺序退出)。
归根结底,Python 修饰器并不是语言层面新增的独立底层运行实体,而是基于高阶函数、闭包作用域与引用重绑定构建出的一套极其精妙的设计模式。它允许我们在不侵入原有代码结构、不打破调用接口的前提下,干净地为函数织入横切关注点(Cross-Cutting Concerns),这也是现代 Python 架构中实现优雅解耦的重要基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















