


Python嵌套for循环的缩进层级与代码结构规范
深入讲解 Python 嵌套 for 循环的缩进层级标准、执行控制流与作用域逻辑,提供降低代码圈复杂度与扁平化重构的具体规范与实用示例。
在 Python 编程中,嵌套 for 循环是处理多维数组、组合排列与矩阵遍历的核心手段。由于 Python 依靠严格的缩进来界定代码块范围,不规范的多层嵌套不仅容易诱发 IndentationError,还会使代码圈复杂度急剧升高。本文将明确 Python 嵌套循环的缩进语法标准、执行时序逻辑,并给出控制层级深度与扁平化重构的具体结构规范。
一、缩进层级基础与 PEP 8 语法规范
Python 与 C、Java 等使用花括号 {} 划定代码块边界的语言不同,它将空白字符缩进作为语言语法的核心组成部分。在嵌套 for 循环结构中,每一个嵌套层级都代表着一个独立的逻辑作用域层级。
根据 Python 官方规范 PEP 8,在编写嵌套循环时必须遵循以下基础原则:
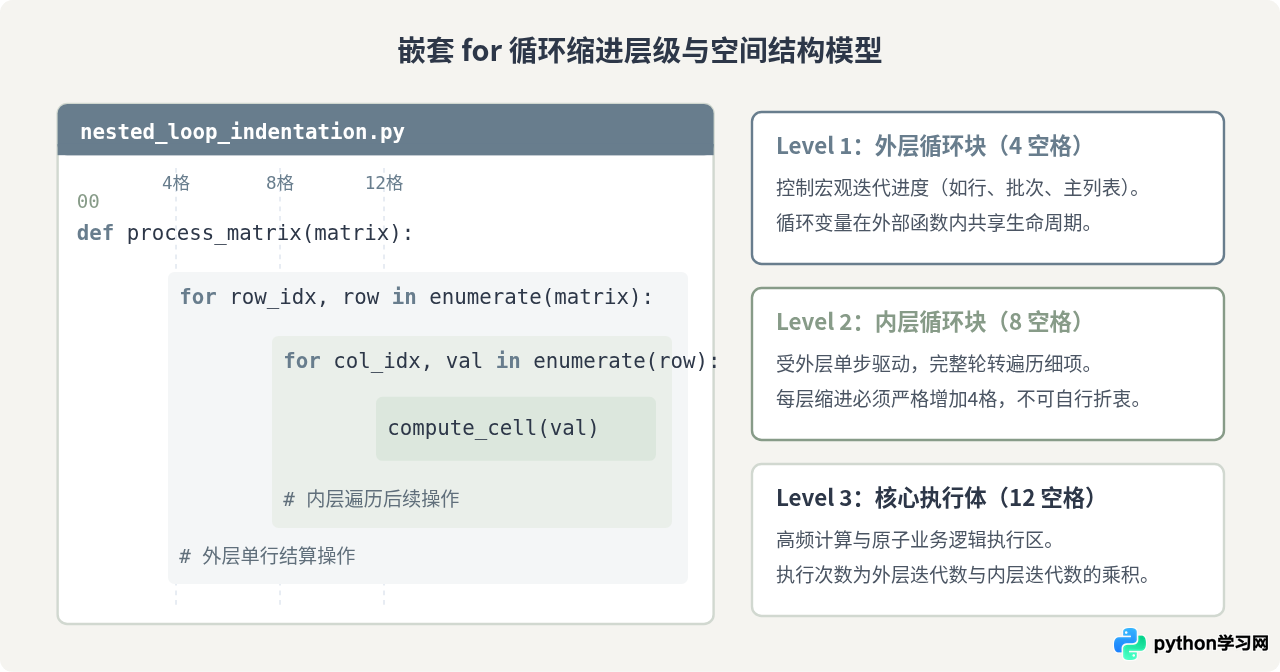
- 每级严格使用 4 个空格:外层
for语句如果是模块顶层则为 0 缩进(在函数内则为 4 空格);第一层循环体缩进 4 空格,第二层内嵌for语句在此基础上缩进 4 空格(累计 8 空格),其内部执行体则缩进 12 空格。 - 严禁混用制表符与空格:制表符(Tab)在不同编辑器中的展现宽度不同,混用会导致看似对齐但解释器抛出
TabError: inconsistent use of tabs and spaces in indentation。现代编辑器应统一配置为按下 Tab 键自动展开为 4 个空格。 - 行尾冒号是缩进块的起始标志:每遇到一次
for ... in ...:,下一行必须增加一个层级的缩进,直至该循环范围结束。
二、嵌套循环的执行时序与控制流机制
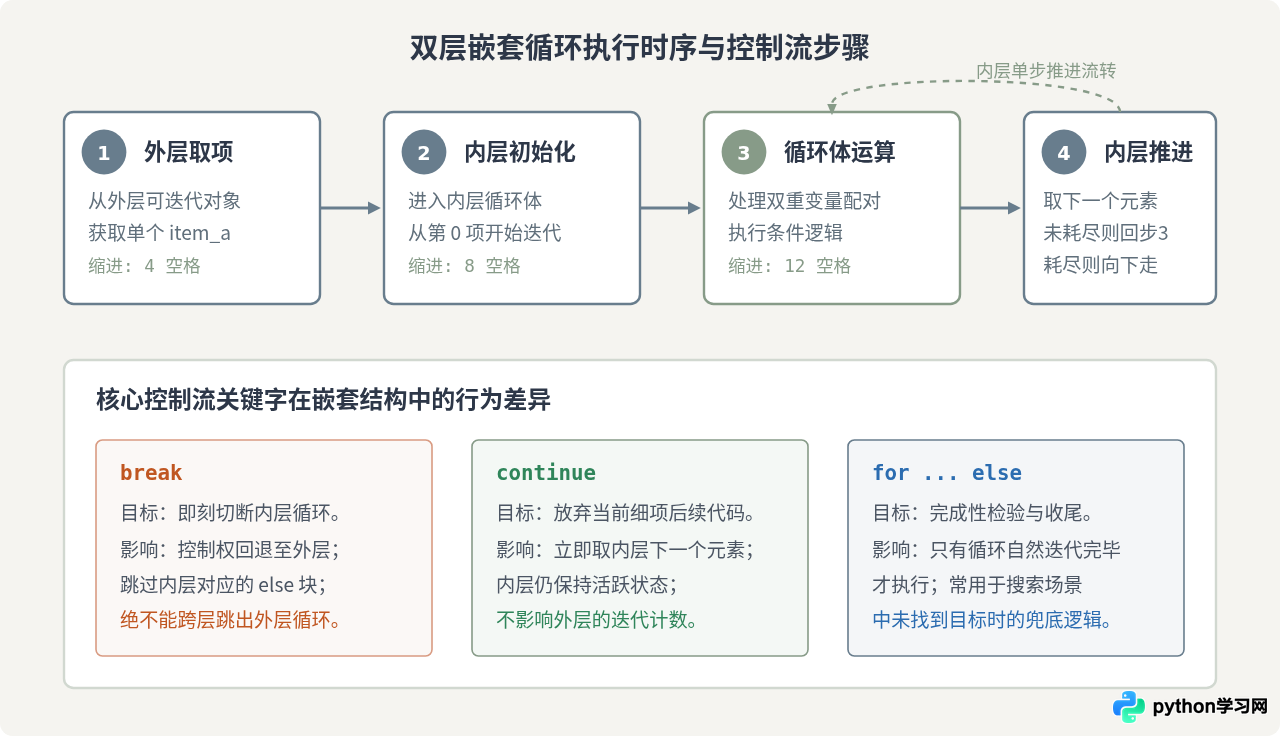
理解嵌套循环的物理执行顺序,是避免逻辑偏移与死循环的前提。双层循环的本质是“时钟模型”:外层循环类似于时针,外层每跳动一格,内层循环(分针)就要从头到尾转满一整圈。
在嵌套层级中,break 与 continue 的作用范围严格受限于其所在的当前缩进层级:
- 内层的
break仅跳出内层:如果在 8 或 12 格缩进的内层执行体中触发break,程序仅会终止当前内层循环的后续轮次,控制流会立即返回到 4 格缩进的外层循环体中继续执行,而不会连带中断外层。 continue仅推进当前层级:内层的continue仅提前结束内层的本次循环,直接进入内层的下一个元素;它不会对外层的步进产生影响。- 循环专属的
else子句:无论是外层还是内层循环,都可以配备else:块。该块只有在当前循环未被 break 打断、正常遍历完毕时才会触发。其缩进层级必须与对应的for关键字严格对齐。
三、深层多重嵌套的弊端与关键差异重构对比
当业务逻辑需要同时遍历三个或更多维度(例如:批次、用户、权限列表、操作记录)时,新手程序员往往会直觉地编写三层甚至四层 for 循环。这种形态在工程中常被称为“金字塔代码(Arrow Anti-pattern)”。
深层多重嵌套的主要危害包括:
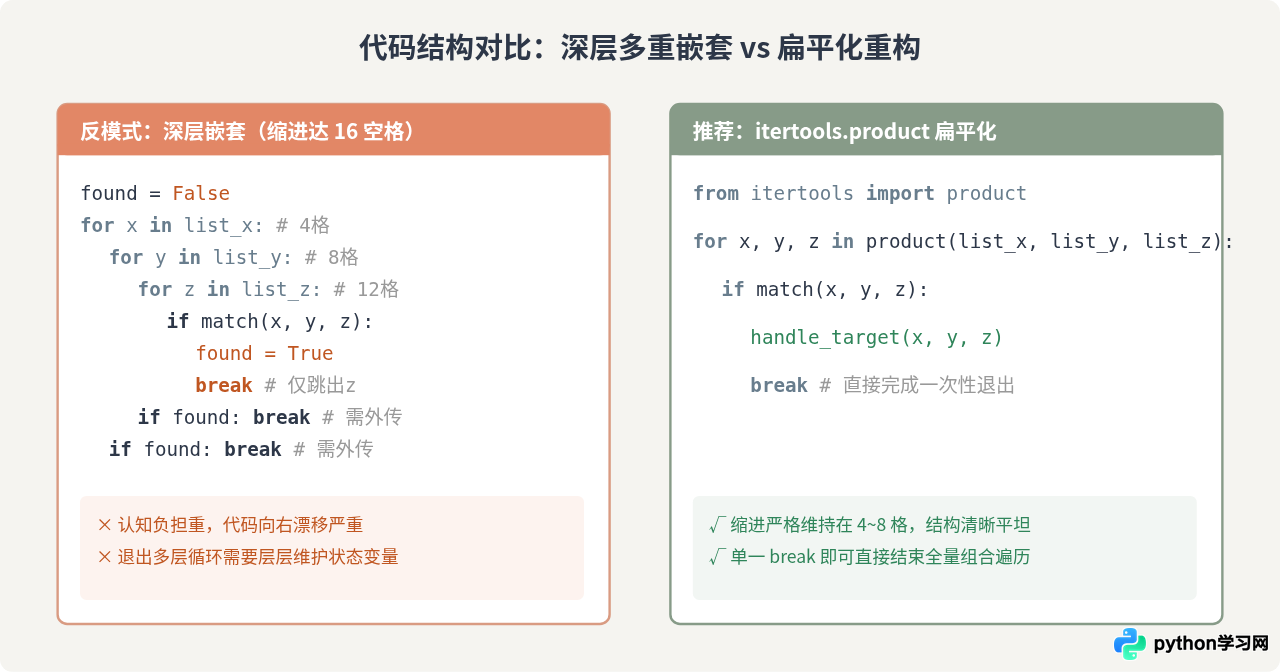
- 视觉认知过载:缩进迅速消耗行宽,深层代码被严重推向屏幕右侧,阅读时视线被迫频繁在多层对齐线之间跳跃。
- 变量作用域混淆:在 Python 中,
for循环变量并不会创建新的局部作用域。深层嵌套中使用i, j, k极易发生误改或拼写错误。 - 跨层跳出极其脆弱:若在第三层发现满足条件需要完全终止整个搜索,常规做法需要引入外部状态标志位(Flag),每层都要手动
if flag: break,逻辑冗余且极易遗漏。
深层嵌套 vs 扁平化重构方案对比
| 评估维度 | 深层嵌套做法 (3层及以上 for 循环) | 扁平化重构做法 (itertools / 拆分函数) |
|---|---|---|
| 最大缩进深度 | 16 ~ 24+ 个空格(4~6 个缩进层级) | 4 ~ 8 个空格(1~2 个缩进层级) |
| 控制流复杂度 | 多层嵌套 break 与标志位交织,极其繁琐 |
直接单层 break,或利用函数 return 提前退出 |
| 代码可测试性 | 各层计算逻辑紧密耦合在巨型函数内,无法独立单测 | 内层处理抽象为独立辅助函数,输入输出清晰,易于单测 |
| 执行效率与开销 | 纯 Python 解释器循环,深层开销不可忽视 | itertools.product 为 C 级别高效生成器迭代,节约内存 |
四、重构实践与代码结构规范清单
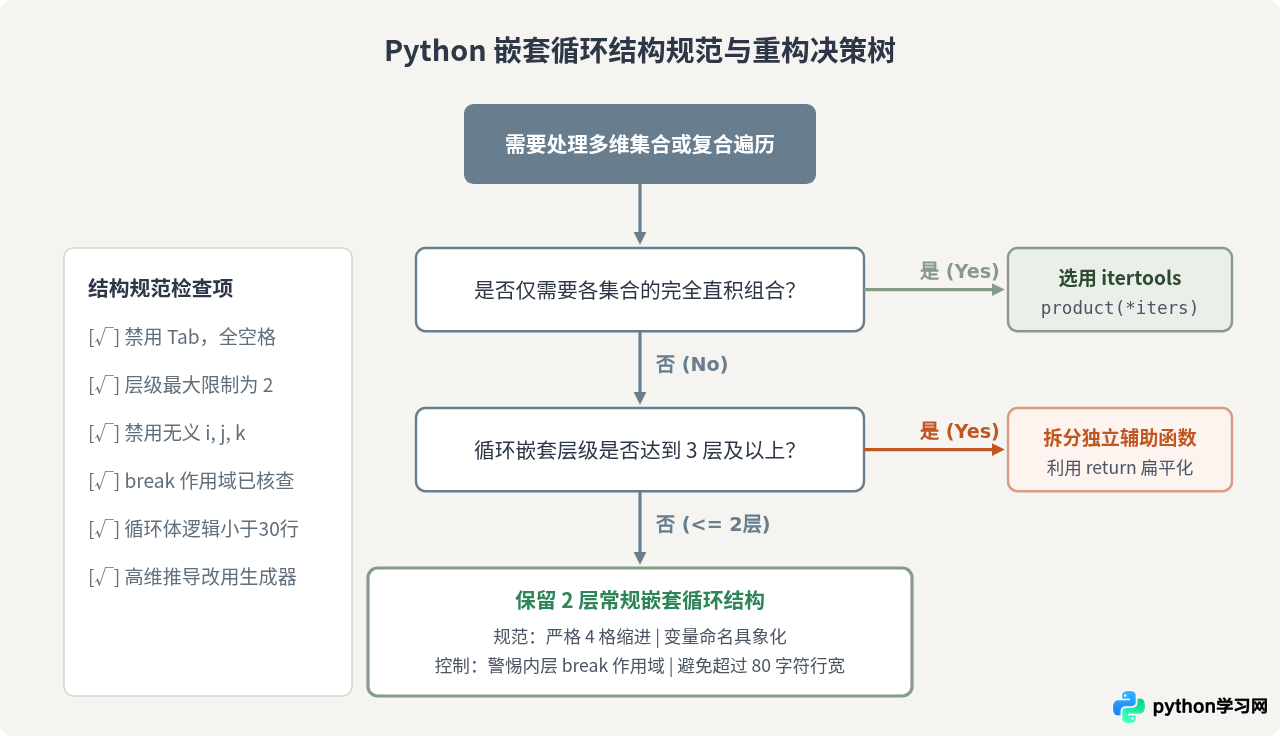
为了让嵌套 for 循环在团队协作和长期维护中保持高质量,推荐在编码过程中落实以下三项工程化重构技巧:
1. 语义化变量命名替代单字母索引
在双层循环中,尽量避免使用 i, j 这类容易看串的单字符。应该使用明确指示当前维度对象的名词:
# 不推荐:容易在内部逻辑中误将 i 与 j 颠倒
for i in range(len(departments)):
    for j in range(len(departments[i].employees)):
        send_notice(departments[i].employees[j])

# 推荐:直接解构对象,命名直观且缩进安全
for dept in departments:
    for employee in dept.employees:
        send_notice(employee)
2. 提炼辅助函数并利用 Early Return
如果需要在多层循环中查找特定元素并在找到后立刻退出,最优雅的方式是将搜索逻辑封装为一个独立的子函数。在找到目标的一刹那直接执行 return result,从而彻底消除外部状态标志位:
def find_first_match(data_matrix, target_id):
    """通过提前返回消除多层跳出标志位"""
    for row_idx, row in enumerate(data_matrix):
        for col_idx, item in enumerate(row):
            if item.id == target_id:
                return (row_idx, col_idx, item)
    return None
3. 审慎使用嵌套列表推导式
虽然列表推导式(List Comprehension)支持嵌套,如 [item for row in matrix for item in row],但其阅读顺序与书写习惯极容易引发困惑。规范建议:
- 推导式嵌套不得超过 2 层。
- 如果内部包含复杂的过滤条件(
if ... else ...),坚决改写为常规的多行缩进for循环,保障可读性。
五、常见缩进报错排查与实战要点
1. IndentationError: unexpected indent
原因:在某一代码行首部输入了多余的空格,导致其缩进无法与任何上级块匹配。例如在内层 for 的同级写了 9 个空格,而该层级期望的是 8 个空格。
解决办法:在 VSCode、PyCharm 等现代编辑器中开启“显示空白字符(Render Whitespace)”功能,快速定位未对齐的行并重新格式化。
2. TabError: inconsistent use of tabs and spaces in indentation
原因:同一代码文件中混用了真实的制表符 \t 和常规空格字符。Python 3 默认对混用零容忍,一旦发现直接抛出错误。
解决办法:使用编辑器的“Convert Indentation to Spaces(将缩进转为空格)”命令,或者在终端执行 autopep8 --in-place your_script.py 进行自动化规范清洗。
总结:嵌套 for 循环是处理多维关系的自然表达,但优秀的 Python 代码应当“扁平优于嵌套(Flat is better than nested)”。在必须使用嵌套时,严格遵守 PEP 8 的 4 空格缩进梯度;在面临 3 层及以上的复杂逻辑时,果断采用 itertools.product、生成器表达式或拆分子函数,让代码结构始终维持在清晰、易读且易于测试的状态。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















