


Python joblib与Ray:高性能并行计算库推荐
针对Python多核与分布式并行计算需求,深入对比joblib与Ray的核心机制、架构模型、实战代码与选型策略。
在处理数据预处理、模型调优或批量仿真等耗时任务时,Python默认的单线程执行方式受全局解释器锁(GIL)限制,往往无法有效利用现代多核CPU及集群资源。解决这一瓶颈的核心路径在于采用成熟的并行计算库。在Python生态中,joblib与Ray是针对不同计算规模与复杂度演化出的两款代表性工具:joblib专注于单机多核场景下的轻量级循环并行与内存共享优化,而Ray则为多机分布式、复杂异步任务及分布式状态管理提供了现代化底层架构。本文将系统梳理两者的核心机制、执行模式及选型边界。
一、单机多核极简提速:joblib的核心机制与实践
joblib最初作为scikit-learn的计算底座被广泛使用,其最大优势在于对原生Python代码极低的侵入性。如果你的核心需求是加速一个耗时的for循环,且计算任务运行在一台单机多核服务器上,joblib通常是最直观且几乎无学习成本的选择。
joblib的核心API主要由Parallel和delayed构成。delayed充当装饰器捕获目标函数及其调用参数,而Parallel调度器则负责管理工作进程池并将任务切块分发。此外,joblib支持内存映射(Memory Mapping)机制,在多进程处理大型NumPy数组时,允许子进程直接共享只读内存块,从而有效规避了原生进程间序列化(Pickle)带来的巨大通信开销。
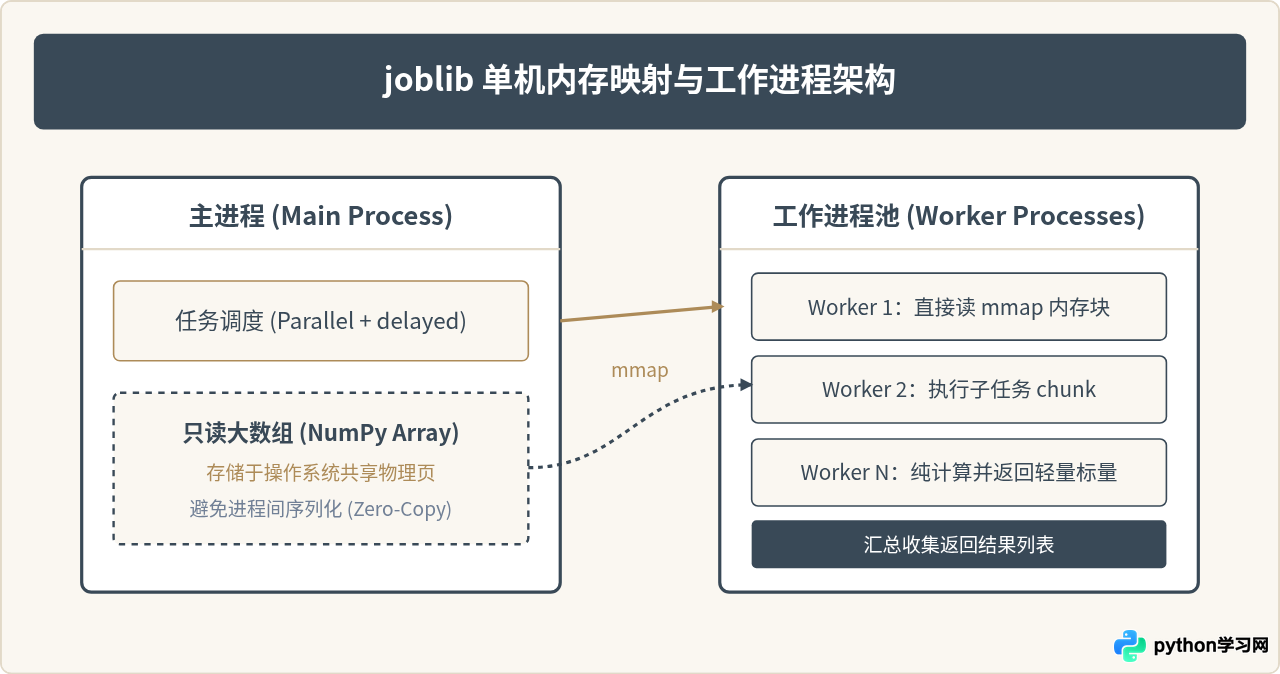
joblib代码实现示例
安装joblib非常快捷,执行pip install joblib即可。下面展示一个通过joblib实现CPU密集型批量运算的标准代码结构:
import time
import numpy as np
from joblib import Parallel, delayed

def calculate_chunk(data_slice, power):
    # 模拟耗时运算
    return np.sum(data_slice ** power)

if __name__ == "__main__":
    # 生成待处理数据列表
    data_chunks = [np.random.rand(1000000) for _ in range(8)]

    start_time = time.time()

    # n_jobs=-1 自动匹配所有物理/逻辑核心;backend可选 'loky' (默认) 或 'threading'
    results = Parallel(n_jobs=-1, backend="loky")(
        delayed(calculate_chunk)(chunk, power=2) for chunk in data_chunks
    )

    elapsed = time.time() - start_time
    print(f"示例运算完成,汇总结果长度: {len(results)},耗时: {elapsed:.2f} 秒")
在Windows与macOS平台下,由于进程生成模式(spawn)的差异,所有启动Parallel的主逻辑代码必须放置在if __name__ == "__main__":保护块内,否则会引发进程递归创建异常。
二、分布式与异步通用计算引擎:Ray的架构优势
当计算任务的体量超出单机物理规格(如需要TB级内存、多台服务器GPU集群协同、或存在大量有状态服务维护)时,joblib的单机模型便无法胜任。Ray正是为此设计的通用分布式计算框架。
Ray通过两项核心抽象重构了分布式编程模式:
- Tasks(无状态任务):通过
@ray.remote装饰标准Python函数。调用函数时返回一个ObjectRef(类似于Future句柄),任务由Ray的底层调度器异步分派到各计算节点执行。 - Actors(有状态计算单元):通过
@ray.remote装饰Python类。Actor在分布式节点上保持实例状态,支持远程方法调用,非常适合维护深度学习参数副本、连接池或流式聚合状态。
在底层数据传输上,Ray在各个节点启动了基于共享内存的分布式对象存储系统(Plasma Object Store),支持节点内零拷贝读取以及节点间的快速序列化流转。
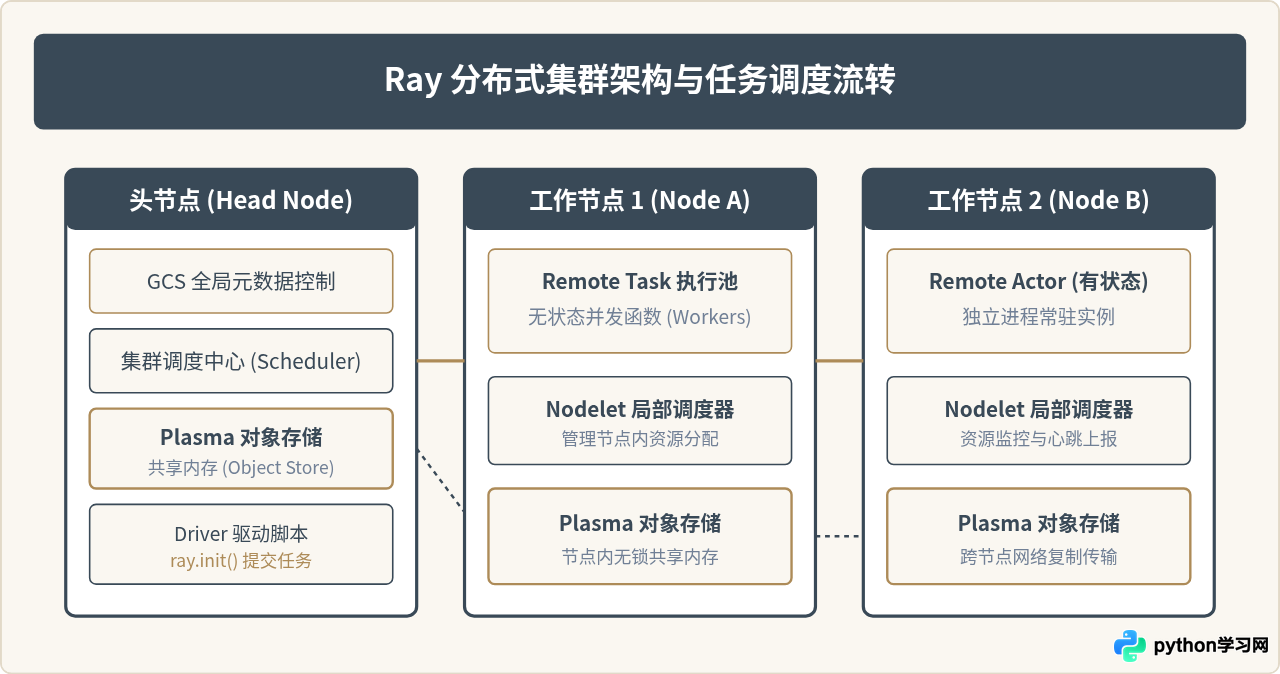
Ray代码实现示例
使用pip install ray安装核心包。单机或集群环境下均使用相同的API,Ray会在本地自动启动微型集群:
import time
import ray

# 初始化本地Ray运行环境
ray.init(ignore_reinit_error=True)

# 1. 定义无状态任务 (Task)
@ray.remote
def process_data(idx, duration):
    time.sleep(duration)
    return f"任务 {idx} 完成计算"

# 2. 定义有状态服务 (Actor)
@ray.remote
class ProgressTracker:
    def __init__(self):
        self.count = 0

    def increment(self):
        self.count += 1
        return self.count

if __name__ == "__main__":
    # 异步非阻塞调用,立即返回 ObjectRef
    futures = [process_data.remote(i, 0.5) for i in range(4)]

    # 实例化 Actor 并调用方法
    tracker = ProgressTracker.remote()
    tracker_future = tracker.increment.remote()

    # 获取结果阻塞等待
    results = ray.get(futures)
    current_count = ray.get(tracker_future)

    print(f"Task 结果: {results}")
    print(f"Actor 当前计数: {current_count}")

    # 关闭环境
    ray.shutdown()
三、实操步骤:从单机脚本过渡到并行计算的路径
为了让现有的串行代码安全、渐进式地获得并行加速能力,建议按照明确的实施路径展开重构,避免过早陷入复杂的分布式调试泥潭。
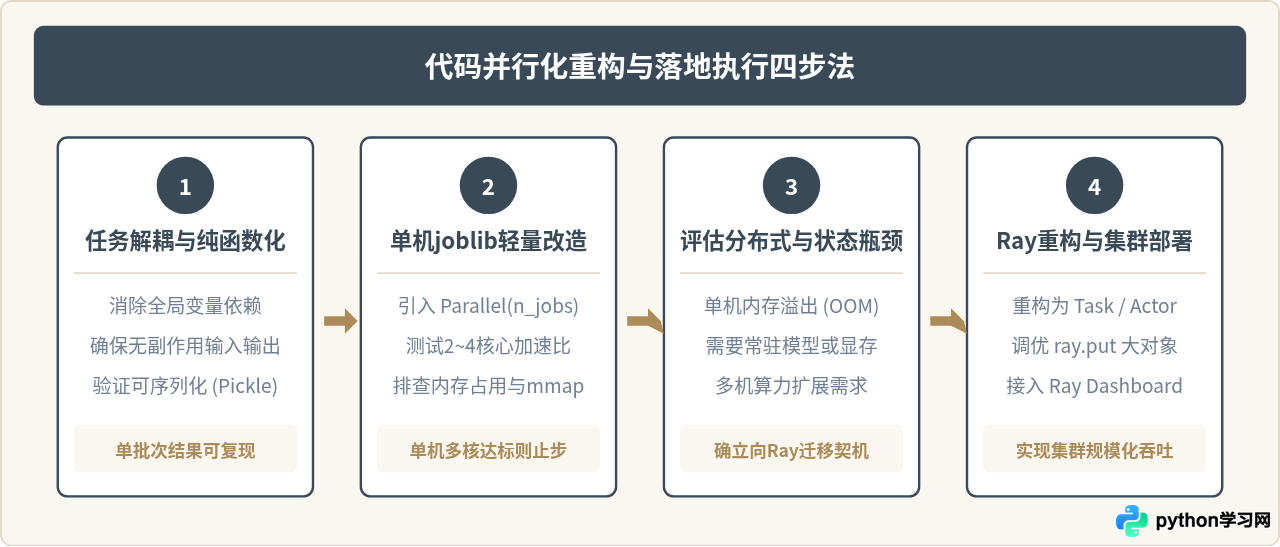
- 步骤一:剥离状态,纯函数化。检查循环内部的代码逻辑,确保任务函数只依赖明确的入参,不修改外部共享全局变量。若无法纯函数化,在多进程环境下容易发生竞争或隐蔽的数据不一致。
- 步骤二:单机joblib验证。使用
Parallel(n_jobs=4)(delayed(func)(x) for x in items)改写循环。观察CPU占用率是否达到预期。如果单机已能满足性能目标,无需额外引入集群框架。 - 步骤三:瓶颈诊断。如果运算量增长导致单机内存爆炸,或者任务之间需要共享只读大模型(例如几GB的BERT/LLM模型副本),此时进程间拷贝将耗尽带宽,出现扩展瓶颈。
- 步骤四:切入Ray并优化对象分发。将目标函数改写为
@ray.remote。对于多个任务共用的大型数据,先执行data_ref = ray.put(large_data)存入Plasma存储,再将data_ref传入任务,避免无谓的重复序列化传输。
四、维度横评与选型决策指南
为了帮助开发者根据实际项目规模做出合理决策,以下对两者的关键工程特性进行横向对照,并提供清晰的选型对照总结:
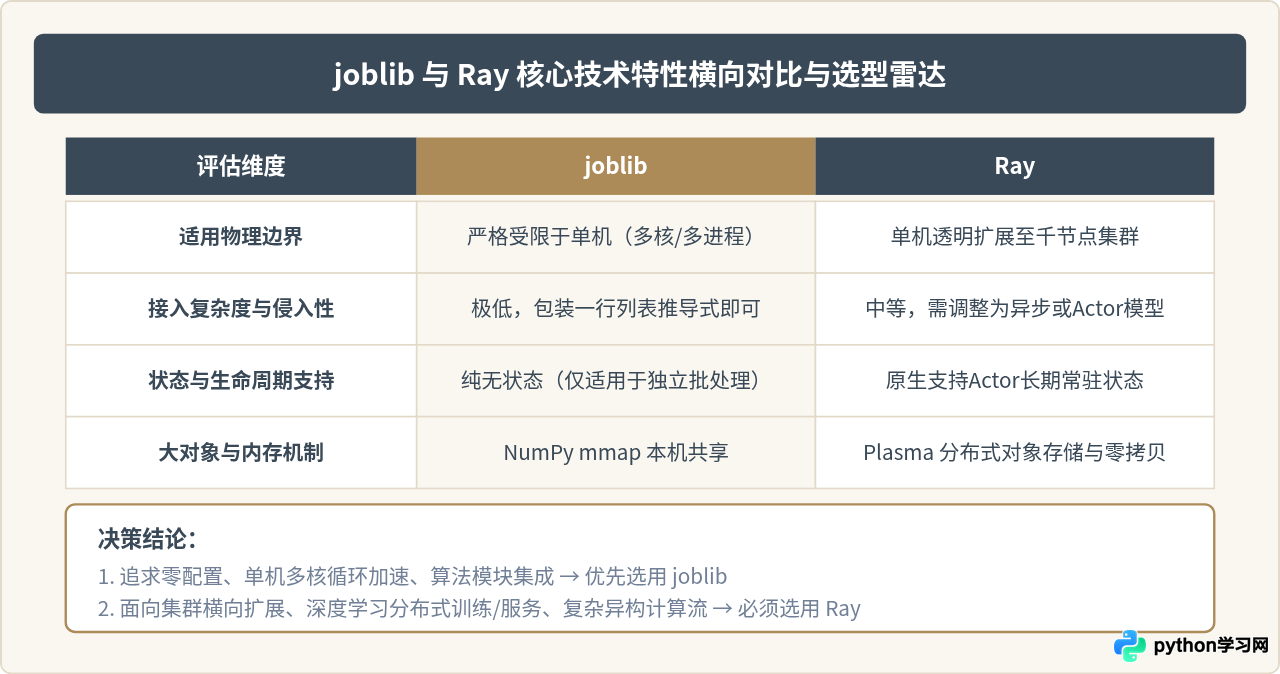
值得一提的是,joblib与Ray并非绝对排斥。Ray官方提供了对joblib的适配后端ray.util.joblib.register_ray()。开发者可以通过标准joblib接口编写代码,并指定上下文使用Ray作为调度底座,从而直接将原本基于joblib的单机模型超参数搜索任务平滑扩展至多机Ray集群中运行:
import joblib
from ray.util.joblib import register_ray

# 注册 Ray 后端至 joblib
register_ray()

# 在 context 中运行原本基于 joblib 的任务,直接获得集群调度能力
with joblib.parallel_backend("ray"):
    # 此处的计算任务将自动分发至 Ray 集群的各个节点执行
    pass
五、结语
在Python高性能计算的工具链选择中,没有绝对的优劣,只有场景的适配。对于绝大多数传统机器学习、中轻度数据清洗与批处理任务,单机joblib以极简的语法设计和可靠的内存映射机制提供了最高的投入产出比;而当面临大规模深度学习、跨机资源聚合以及包含复杂有状态服务的复杂流水线时,Ray先进的无状态Task与有状态Actor架构则是构筑现代分布式计算基础设施的坚实底座。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















