


Python新手必备:按领域分类的常用第三方库清单
针对Python初学者梳理的常用第三方库按领域分类清单,系统介绍数据分析、Web开发、网络请求、自动化办公与工程辅助等核心领域的必备库,提供规范安装步骤、示例代码、选型依据与避坑指南。
Python 能够风靡全球并在各个行业广泛应用,其核心优势之一在于拥有极其庞大且成熟的第三方生态系统。对于初学者而言,掌握了基础语法之后,往往会面临“面对具体任务不知道用什么库、库与库之间有什么区别、如何规范安装与管理”的困扰。本文按照实际应用领域系统梳理最常用、工业界验证充分的第三方库,解析其核心功能与适用边界,并提供规范的工程环境搭建方法与选型准则。
一、第三方库的规范安装与环境隔离
在开始接触任何第三方库之前,首先需要建立正确的环境管理意识。许多新手习惯直接在系统全局 Python 环境下运行 pip install,这极易引发依赖版本冲突,甚至破坏操作系统内置的脚本运行环境。因此,使用虚拟环境(Virtual Environment)是开发 Python 项目的标准工程实践。
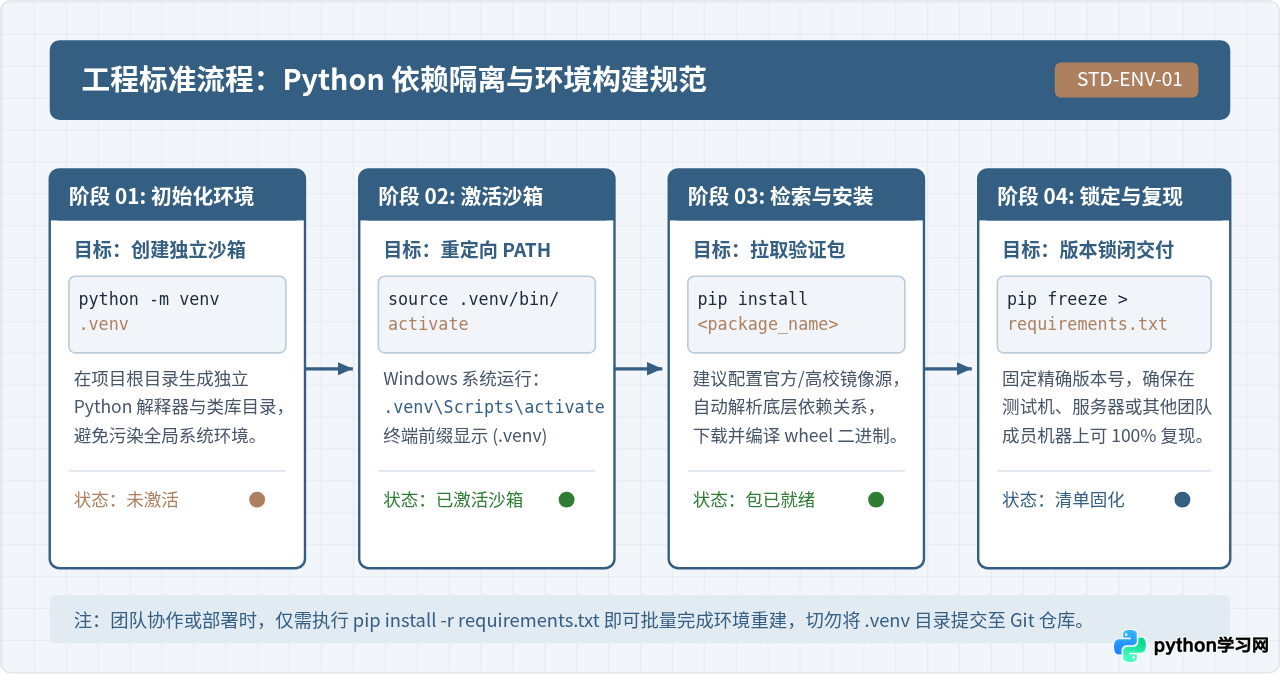
标准操作步骤如下:
- 创建虚拟环境:在项目目录下执行
python -m venv .venv。此时会在当前目录生成一个名为.venv的文件夹,内置独立的 Python 副本和包目录。 - 激活环境:
- macOS / Linux:
source .venv/bin/activate - Windows(PowerShell):
.venv\Scripts\Activate.ps1
(.venv)标记。 - macOS / Linux:
- 安装第三方库:激活后执行
pip install 库名,例如pip install pandas。 - 固化依赖清单:开发或交付阶段,运行
pip freeze > requirements.txt导出依赖,他人只需运行pip install -r requirements.txt即可一键还原相同环境。
二、Python 常用第三方库领域分布全览
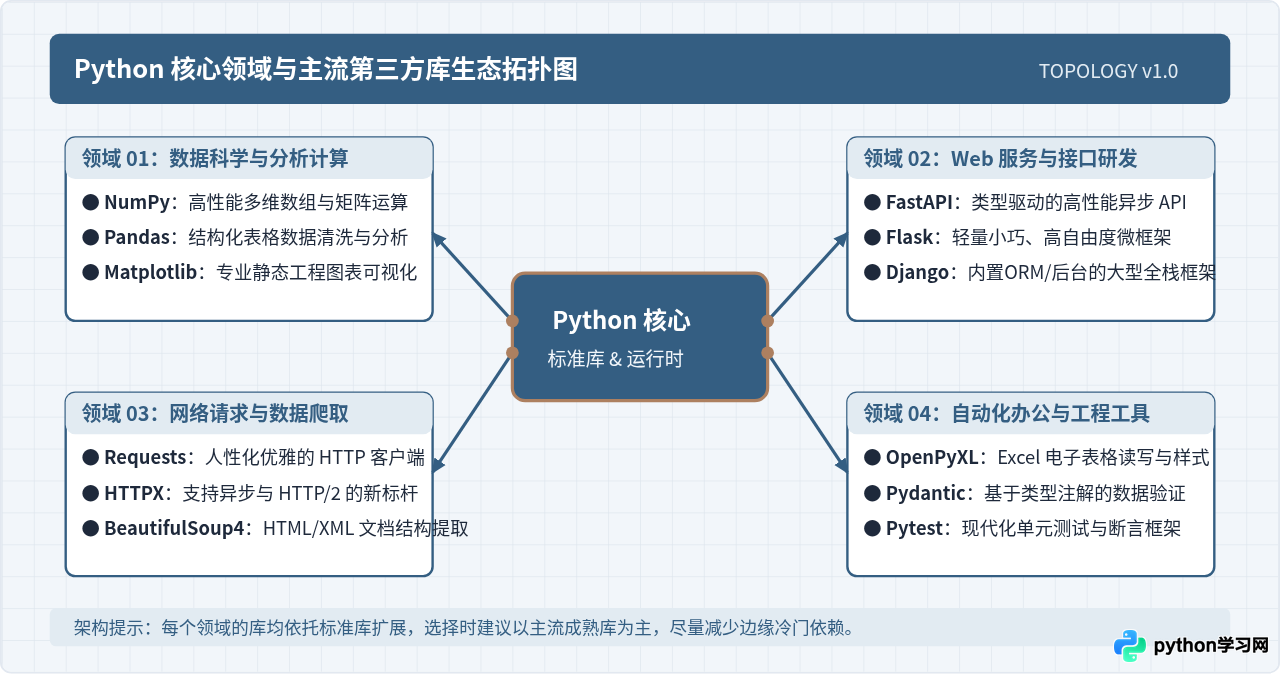
Python 生态非常广泛,但在日常开发中,80% 以上的需求集中在数据处理、网络通信、Web 研发、自动化办公及工程工具五个核心领域。了解每个领域的主力库及其定位,可以避免“重复造轮子”或“误选小众生僻库”。
三、各领域核心库详解与示例代码
1. 数据处理与分析领域
在这个领域,最经典的核心组合是 NumPy 与 Pandas,配合图表可视化库 Matplotlib:
- NumPy:提供高性能的 N 维数组对象(
ndarray)以及大量的数学函数。它是整个 Python 科学计算生态的基石。 - Pandas:基于 NumPy 构建,提供
Series(一维)和DataFrame(二维表格)数据结构。无论读取 CSV、Excel 还是 SQL 数据库,Pandas 都是数据清洗、筛选、聚合和统计的首选。 - Matplotlib:Python 最基础也是功能最完备的绘图库,能够生成折线图、柱状图、散点图等各类出版级图表。
csv 模块已足够;一旦涉及行列切片、缺失值填充、跨表关联(merge)或统计计算,应果断引入 pandas。
# 示例:使用 Pandas 进行基础数据统计与清洗
import pandas as pd

# 创建示例表格数据(模拟销售记录)
data = {
    "product": ["Keyboard", "Mouse", "Monitor", "Keyboard", "Mouse"],
    "quantity": [12, 25, 6, 8, 15],
    "price": [299.0, 99.0, 1299.0, 299.0, 99.0]
}
df = pd.DataFrame(data)

# 计算每个产品的总销售额
df["total_amount"] = df["quantity"] * df["price"]
summary = df.groupby("product")["total_amount"].sum().reset_index()

# 示例输出验证
print("=== 产品销售额汇总 ===")
print(summary)
# 输出示例:
#      product  total_amount
# 0   Keyboard        5980.0
# 1    Monitor        7794.0
# 2      Mouse        3960.0
2. 网络请求与数据爬取领域
编写爬虫或对接第三方 RESTful API 时,最常用的是 Requests,解析网页结构则使用 BeautifulSoup4:
- Requests:被誉为“人类可读的 HTTP 库”。相比标准库繁琐的
urllib.request,Requests 提供了极简的 API,自动处理编码转换、Cookie 保持和 JSON 解析。 - HTTPX:现代化的 HTTP 客户端,语法与 Requests 保持高度一致,但原生支持异步操作(
async/await)以及 HTTP/2,适合高并发抓取场景。 - BeautifulSoup4(bs4):专用于解析 HTML 和 XML 文档,提供直观的 CSS 选择器和属性查找接口,容错率高。
# 示例:使用 Requests 安全请求 API 并获取结构化 JSON
import requests

url = "https://httpbin.org/get"
params = {"category": "developer", "lang": "python"}
headers = {"User-Agent": "MyDataCollector/1.0"}

try:
    # 发送 GET 请求并设置超时时间(防止网络卡死)
    response = requests.get(url, params=params, headers=headers, timeout=5)

    # 检查 HTTP 状态码(非 200 会抛出 HTTPError 异常)
    response.raise_for_status()

    # 直接反序列化为字典
    result_data = response.json()
    print("返回参数验证:", result_data.get("args"))
    # 示例输出:返回参数验证: {'category': 'developer', 'lang': 'python'}
except requests.exceptions.RequestException as err:
    print(f"请求失败: {err}")
3. Web 后端与接口开发领域
Python 在 Web 领域的框架梯队非常分明:
- FastAPI:近年来发展最迅猛的 API 框架。深度结合 Python 3.6+ 的类型注解(Type Hints)与 Pydantic,具备自动生成 Swagger/OpenAPI 在线交互文档、自动入参校验以及出色的异步性能。
- Flask:经典的微框架。核心代码极少,扩展机制灵活,适合小型演示应用、工具型后台或微服务。
- Django:工业级全栈框架。“开箱即用”理念的代表,自带 ORM、管理后台、用户认证和安全防护体系,适合需求庞大、规范标准的中大型企业系统。
四、典型业务场景下的多库协同工作流
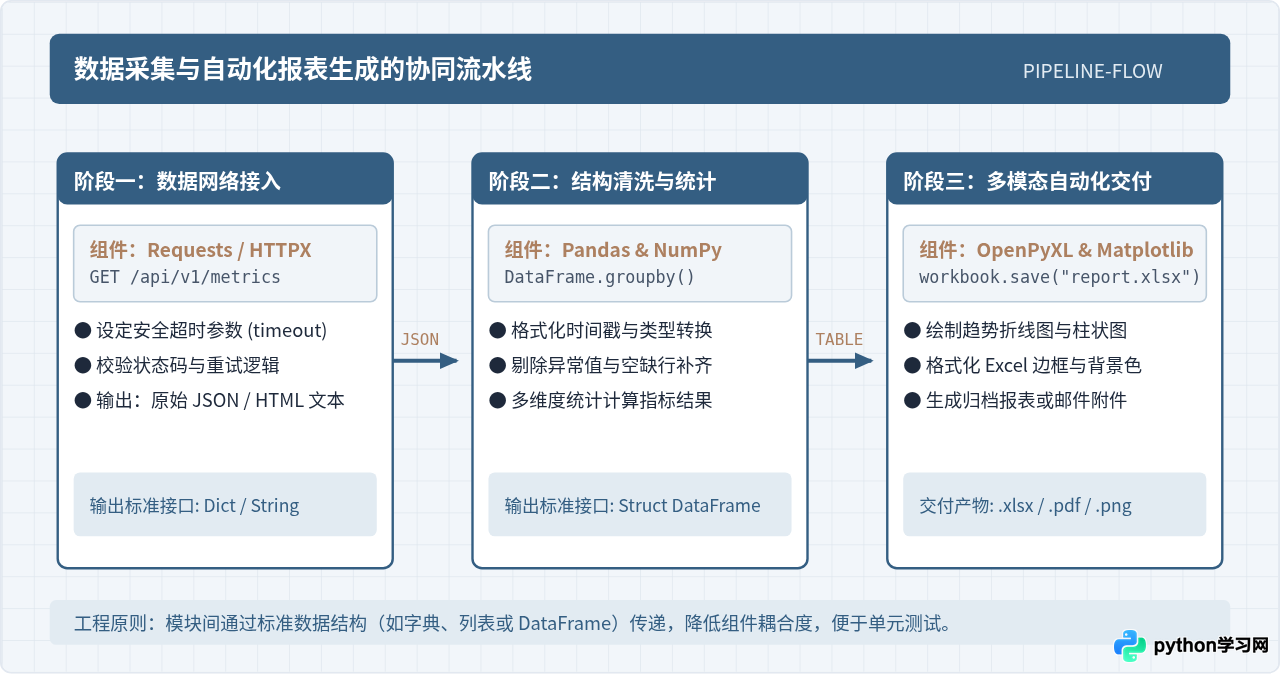
在实际企业应用中,很少有单一库孤立工作。最常见的模式是多个库协同形成流水线:通过网络库采集数据、利用数据处理库清洗、结合自动化办公库生成报告,完成业务闭环。
4. 自动化办公与文件处理领域
处理常见文档类型时,Python 拥有针对不同文件格式的专门库:
- OpenPyXL:专门用于读取和写入 Excel 2010 xlsx/xlsm 文件。支持单元格样式设定、公式写入以及多 Sheet 管理,是自动化报表的核心。
- python-docx:用于创建和更新 Microsoft Word(.docx)文件,可精确控制段落、标题、表格及文字格式。
- pypdf:用于读取、提取文本、合并、拆分或加密 PDF 文件的纯 Python 库。
5. 工程开发与测试工具领域
为了保证代码健壮性和日常维护效率,以下工具库在新项目中建议直接引入:
- pytest:Python 事实上的标准测试框架。相比内置的
unittest,语法极其简洁(直接使用原生的assert语句),拥有功能强大的fixture机制和庞大的插件体系。 - Pydantic:通过 Python 原生的类型注解来完成数据解析与强校验。如果入参类型不匹配,会自动给出清晰易懂的错误报错,是现代 Python 后端与数据处理的核心基础设施。
- Loguru:开箱即用的优雅日志库。省去了标准库
logging繁重的配置过程,一句from loguru import logger即可享受色彩高亮、自动文件轮转(rotation)与异常回溯跟踪。
五、新手第三方库选型与避坑决策指南
PyPI 上有数十万个开源包,良莠不齐。引入不合适的库不仅会增加项目维护负担,还可能引入潜在的安全漏洞或版本死锁。新手在引入新库时,应当遵循一套明确的评估流程。
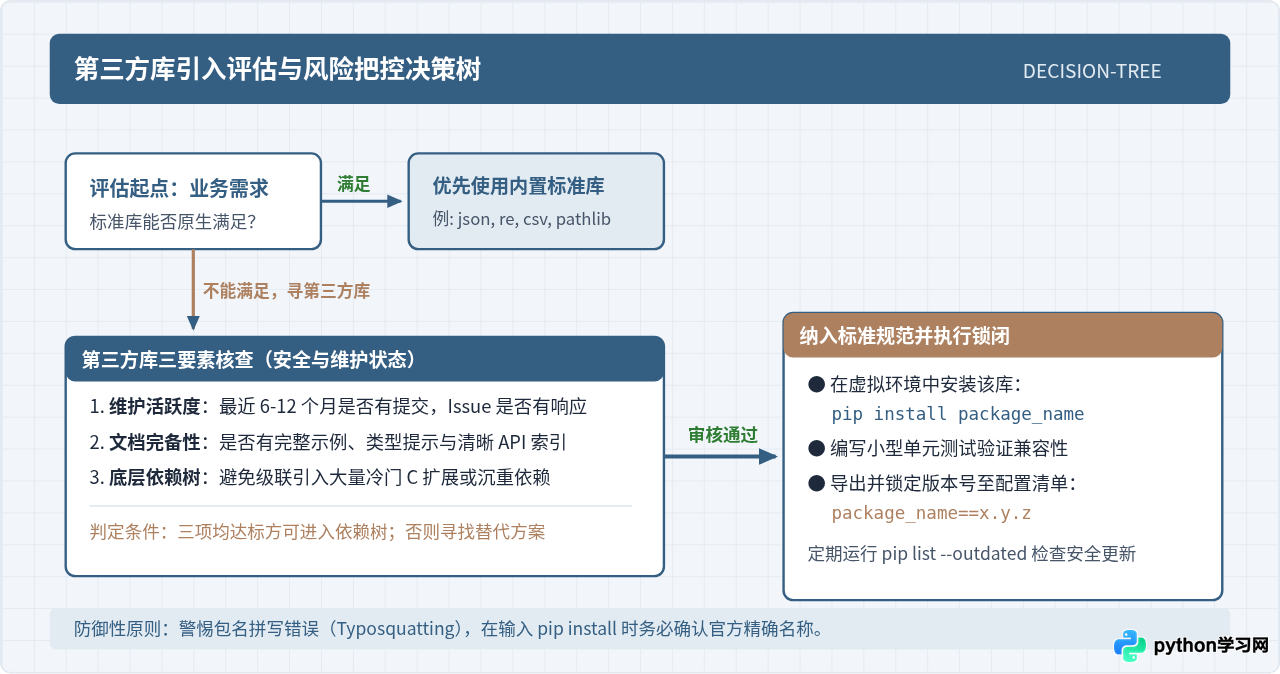
新手在引入第三方库时,务必警惕以下常见误区与陷阱:
- 陷阱一:过度依赖外部库做简单任务。例如读取一个配置文件,很多新手会盲目安装复杂的第三方解析器,而实际上 Python 标准库自带的
json、configparser或内置的pathlib已经能够高效、零依赖地完成工作。 - 陷阱二:忽略 C 语言编译环境限制。部分高性能库(如早期版本的某些图像处理或科学计算库)需要底层 C++ 编译器(如 Windows 下的 MSVC)。新手如果在没有预编译 wheel 文件的机器上安装,会出现报错。因此应优先确认该库在 PyPI 上是否提供与当前系统架构对应的预编译 Wheel 包(
.whl)。 - 陷阱三:拼写混淆与假包投毒(Typosquatting)。黑客经常在 PyPI 上上传名称类似官方库的恶意包(例如将
requests故意写成requsets)。输入安装命令前,一定要核对官方文档给出的精确包名。 - 陷阱四:不锁定版本导致环境突崩。第三方库如果经历主版本迭代(如从 1.x 升级到 2.0),可能会废弃旧 API。如果不使用
requirements.txt固定版本号(如pandas==2.2.1),在未来重新部署时可能因为自动拉取了最新版而导致现有程序崩溃。
六、常用第三方库分类速查表
为方便日常查阅与快速检索,下表总结了本文涵盖的核心第三方库及其主要特征:
| 所属领域 | 常用库名称 | 核心应用场景 | 新手学习建议 |
|---|---|---|---|
| 数据科学与分析 | Pandas | 表格数据读写、清洗、过滤、分组统计 | 重点掌握 DataFrame 索引、缺失值处理与 groupby 操作 |
| 数值计算 | NumPy | 多维数组运算、线性代数、批量向量化计算 | 理解向量化操作,避免在数据密集计算中使用原生 for 循环 |
| 网络请求 | Requests | 调用 RESTful API、同步网络爬虫请求 | 始终记得配置 timeout 参数,并调用 raise_for_status() 检查响应 |
| HTML 解析 | BeautifulSoup4 | 从抓取的网页源码中提取结构化标签与文本 | 推荐配合 lxml 解析器使用,效率更高、容错更强 |
| Web API 开发 | FastAPI | 高性能异步微服务、前后端分离后端 API | 配合类型提示(Type Hints)编写接口,自动获得在线交互文档 |
| 自动化办公 | OpenPyXL | 读写 Excel 表格、定制样式、公式写入 | 大数据量导出时开启 write_only 模式以节省内存 |
| 工程测试 | pytest | 编写与运行自动化单元测试、测试用例固件 | 学习使用 fixture 管理测试上下文,编写纯净的断言函数 |
| 日志管理 | Loguru | 项目执行过程追踪、自动分级输出与日志回溯 | 直接取代默认 print,利用 rotation 自动按体积切分日志文件 |
初学者在学习 Python 时,不必一次性掌握所有第三方库。合理的成长路径是:先熟练掌握虚拟环境与 pip 的使用,再根据当前手头的实际任务(例如先学网络请求加自动化办公,或者先学数据清洗与图表制作),专注掌握两到三个核心库的基本用法。随着工程经验的积累,再逐步将单元测试、类型验证和日志工具融入到日常开发中,形成稳健、规范的代码风格。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















