


为什么Python切片采用左闭右开区间设计
深入解析Python切片为何采用左闭右开区间 [start:stop) 设计,结合元素长度计算、连续切片无缝拼接、栅栏数分界线模型以及零基索引设计,详细讲解其底层逻辑与工程优势。
sequence[start:stop] 采用左闭右开区间 [start: stop),即包含起始下标 start 对应的元素,但不包含结束下标 stop 对应的元素。这种设计直接解决了三个工程痛点:子序列长度恰好等于 stop - start、两个连续子序列可通过相同下标直接无缝拼接 s[:i] + s[i:] == s,并且与从 0 开始计数的索引体系天然融合,最大限度消除因 +1 或 -1 产生的越界与偏差错误。
一、直观体验:切片左闭右开的运行表现
在 Python 中,无论是字符串、列表还是元组,使用切片语法提取子序列时,结束位置的索引始终不会被纳入结果。例如:
# 示例代码:提取下标从 2 到 4 的元素(不包含 5)
numbers = [10, 20, 30, 40, 50, 60]
subset = numbers[2:5]

print("截取结果:", subset)
# 预期输出: 截取结果: [30, 40, 50]
初学编程时,许多开发者会困惑:既然 numbers[5] 对应数值 60,为什么 numbers[2:5] 却只包含到 numbers[4](即数值 50)?要回答这个问题,我们需要从区间数学特性的推导讲起。
二、核心理由一:子序列长度计算等于 stop - start
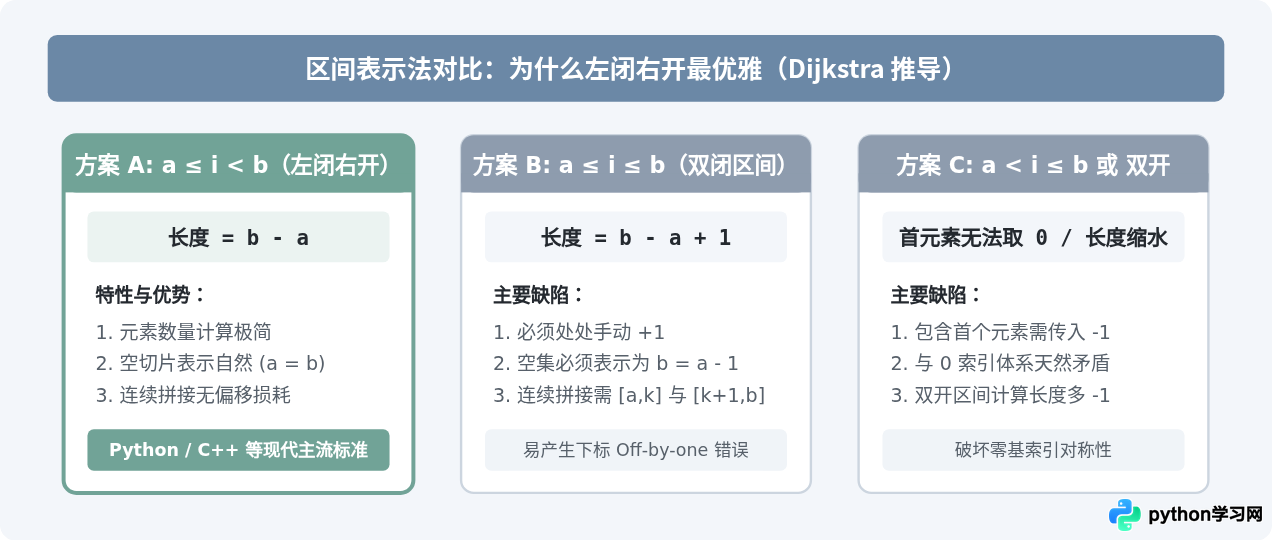
计算机科学先驱 Edsger W. Dijkstra 曾在其知名手稿《为什么编号应该从零开始》(EWD831)中详细论述过连续区间的表示方法。连续的四个自然数子区间形式如下:
a ≤ i < b(左闭右开)a ≤ i ≤ b(双闭区间)a < i ≤ b(左开右闭)a < i < b(双开区间)
在所有可能中,只有 a ≤ i < b 和 a < i ≤ b 能够保证:包含的元素个数直接等于上界减去下界,即 b - a。
如果使用双闭区间 [start, stop],元素的个数将是 stop - start + 1。这看似只是多写一个 +1,但在实际工程开发中,开发者不仅需要在计算长度时牢记 +1,更会在循环边界、内存申请和分块计算时反复权衡是否已经 +1,成为最常见的“差一错误”(Off-by-one Error)温床。
# 在左闭右开区间下:
items = ["a", "b", "c", "d", "e", "f", "g"]
slice_part = items[2:6]

# 截取的元素个数 = 6 - 2 = 4
print("元素个数:", len(slice_part)) # 输出: 4
三、核心理由二:相邻子序列无缝拼接 s[:k] + s[k:] == s
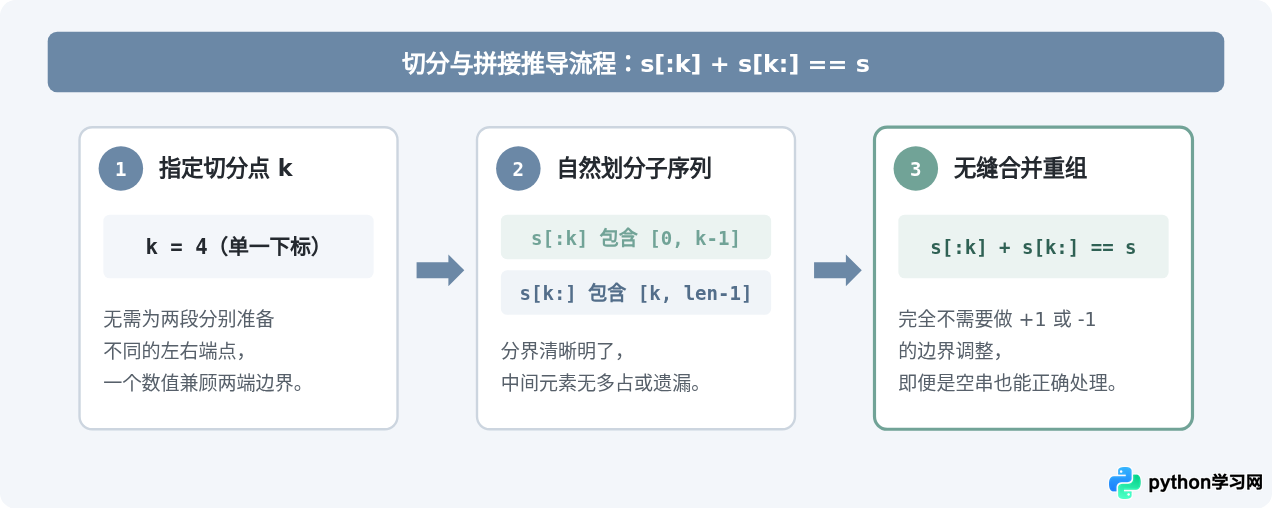
在数据处理中,将一个序列在某个分界点 k 处拆分为两半,并在后续逻辑中重新连接,是非常高频的操作。左闭右开区间提供了一种绝对对称且无缝的特性:
s 和有效索引 k,恒有:s[:k] + s[k:] == s。
注意看前半段的结束下标与后半段的起始下标都是 k。因为 s[:k] 不包含 k,而 s[k:] 恰好从 k 开始,两者交界处既没有重复包含元素,也没有遗漏任何元素:
text = "PythonCode"
k = 6

first_half = text[:k]  # 取前 6 个字符: 'Python'
second_half = text[k:] # 从下标 6 开始取到末尾: 'Code'

print("无缝重构完整字符串:", first_half + second_half == text)
# 输出: True
如果采用双闭区间,前半部分为了包含到第 k 个位置,后半部分就必须从 k + 1 开始,即写成 s[:k] + s[k+1:]。一旦需要跨段操作或者处理边界 k=0,就必须处处添加条件分支去兼容下标越界问题。
四、核心理由三:与 0 索引体系的完美共生
Python 采用以 0 为起始的索引机制(Zero-based Indexing)。在左闭右开设计下:
sequence[:n]精确代表提取序列的前 n 个元素;sequence[n:]精确代表在跳过前 n 个元素后取剩余的所有元素。
比如 s[:3] 直接就是取前 3 个元素,你完全不需要在脑海中做 3 - 1 = 2 的心算转换。如果切片是闭区间,提取前 3 个元素就不得不写成 s[0:2],这会严重违背人类数数的直觉逻辑。
五、心智模型:分界线模型(栅栏原则)
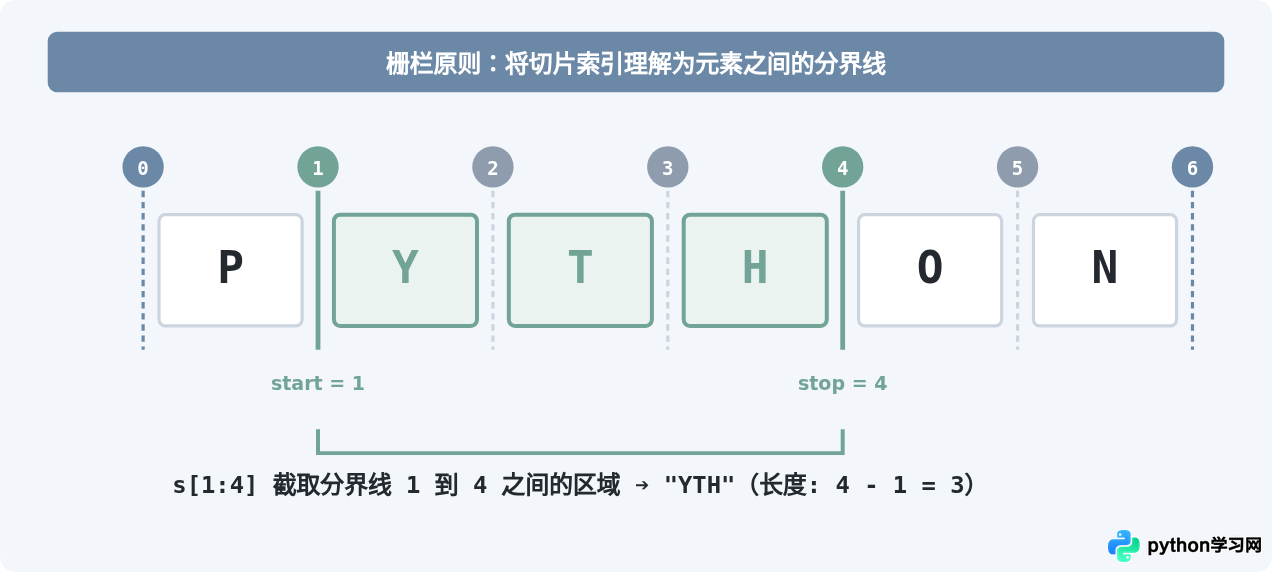
理解左闭右开区间最好的直观模型,是把切片索引想象为元素之间的分界线(Fenceposts),而不是指向元素本体的槽位。
对于长度为 6 的字符串 "PYTHON",一共存在 7 条分界线,编号分别为 0 到 6。切片 [start:stop] 的含义是截取从分界线 start 到分界线 stop 之间的全部字符:
六、空切片与边界保护的自然实现
在算法与业务开发中,空子序列(Empty Slice)是极为常见的边界状态。左闭右开区间对空子序列的表达非常优雅:
- 当
start == stop时,例如s[3:3],所截取的区间长度为3 - 3 = 0,直接返回空序列[]或"",不会产生任何错误。 - 如果采用闭区间
[a, b],若要表达空集,必须满足b = a - 1。这不仅破坏了下标单调递增的自然性质,更可能在处理a = 0时引入负数索引-1,在 Python 这类支持负数索引的语言中引发意料之外的取末尾元素行为。
# 当 start == stop 时自然返回空列表,不会抛出 IndexError
data = [1, 2, 3, 4]
empty_part = data[2:2]
print("空切片结果:", empty_part) # 输出: []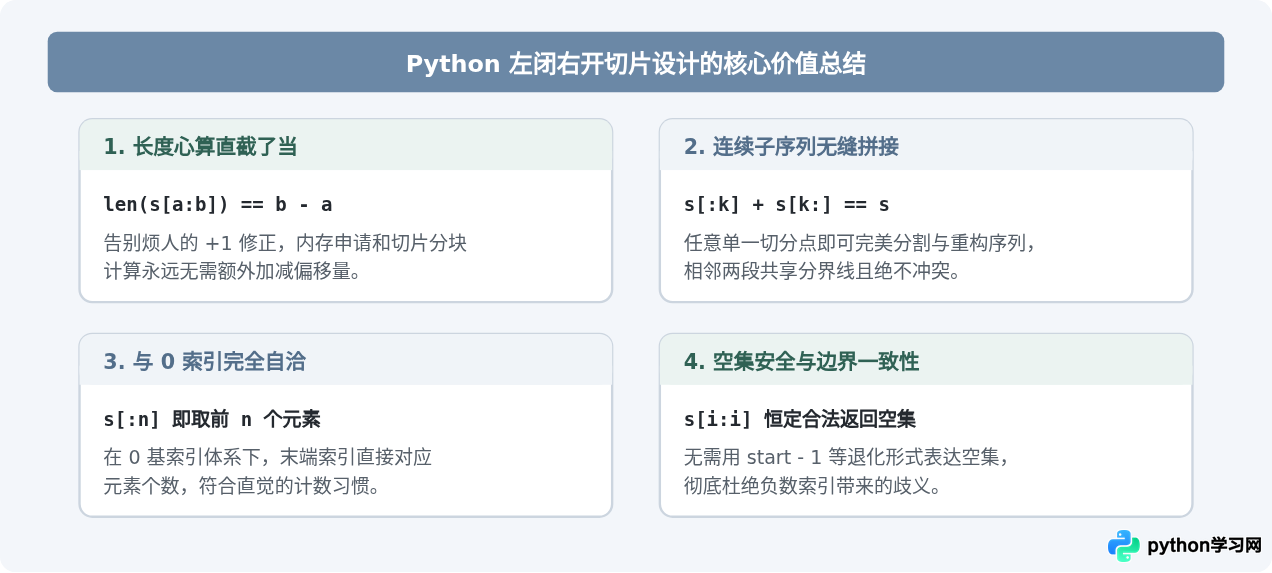
七、结语
Python 切片的左闭右开设计并非随意的语法偏好,而是计算机科学中针对区间数学、分界线模型以及零基索引深思熟虑后的最优解。它用极简的规则统一了序列长度计算、前后切分拼接、前 N 项提取以及空集合表示,从底层语言设计层面消除了绝大多数差一错误(Off-by-one errors),展现了 Python“优美胜于丑陋、明了胜于晦涩”的设计哲学。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















