


Python for循环加速方案选型:何时用NumPy、Numba还是并行计算
针对Python密集计算中的for循环性能瓶颈,本文系统解析NumPy向量化、Numba JIT编译与多进程并行计算的底层原理、适用边界与代码实现,提供清晰的选型决策树与工程落地指导。
一、Python for循环的瓶颈根源与选型决策链
原生Python在执行for循环时速度较慢,本质是由解释器的动态执行机制决定的。CPython在每次迭代时都要对变量进行动态类型检查、装箱与拆箱(PyObject封装)、属性字典查找以及全局解释器锁(GIL)状态同步。这些开销在纳秒级的简单算术操作中占比高达95%以上,导致密集循环的执行效率远落后于编译型语言。
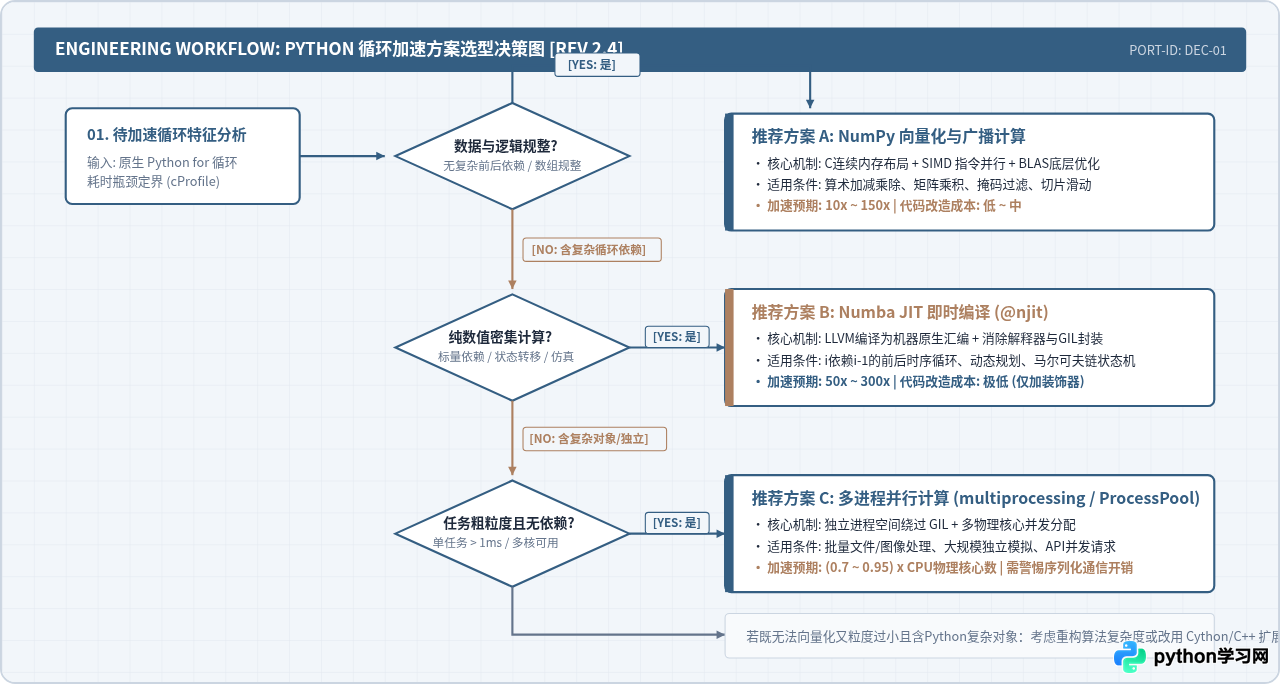
面对性能瓶颈,盲目重构往往费时费力。通过分析算法的数据规整性、前后迭代依赖性与单任务计算粒度,可以建立一条明确的加速方案决策路径。
二、方案一:NumPy 向量化(何时选与如何用)
1. 适用场景与技术原理
NumPy的核心优势在于同质化内存连续存储与预编译底层执行。当你的for循环满足以下两个特征时,应直接使用NumPy:
- 数据规整性:处理的数据是同构的数字、向量、矩阵或多维张量,无需操作异构Python字典或对象属性。
- 无前后状态依赖:第
i次循环的计算完全独立于第i-1次循环的结果,可以通过数组表达式批量执行。
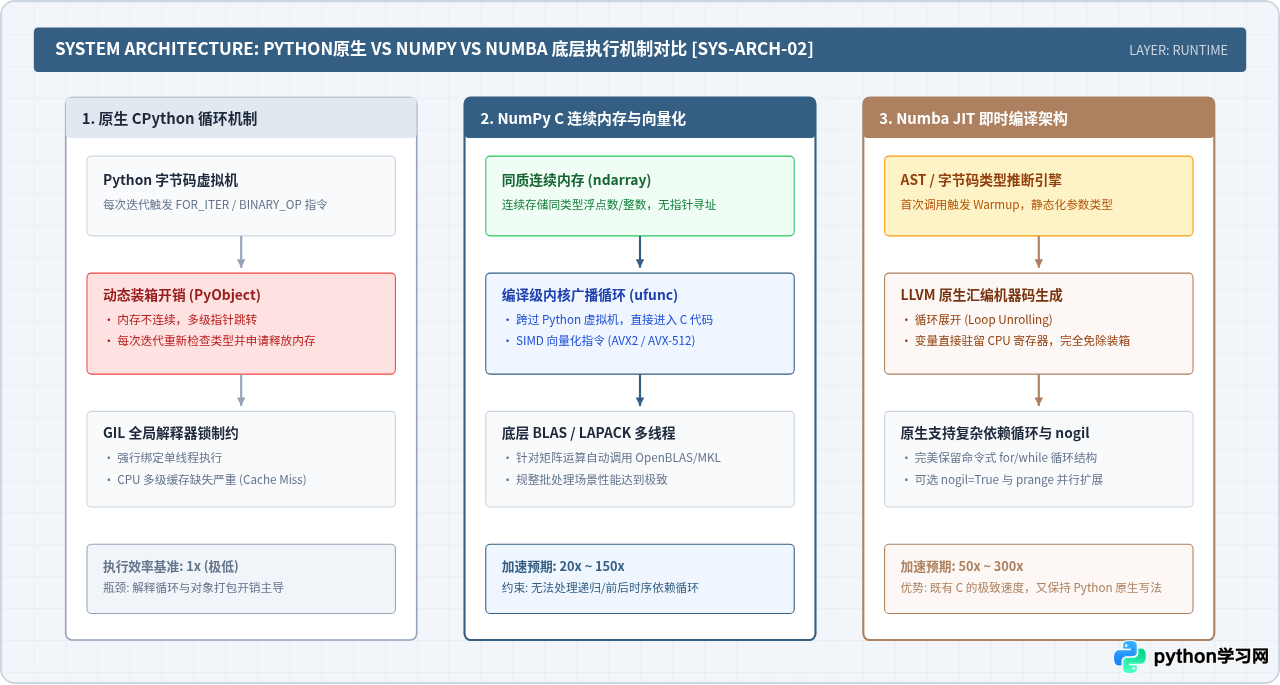
NumPy数组在底层是C语言连续分配的连续内存块(C-contiguous),不包含Python对象的头部冗余元数据。执行向量化操作时,底层通过编译好的C/Fortran内核直接调用现代CPU的SIMD(单指令多数据流,如AVX-512)指令,在一个时钟周期内并发处理多个浮点数,彻底消除Python解释器的调度开销。
2. 典型重构代码对比
以下为一个典型的数据点欧氏距离计算场景。原生Python使用双重for循环,而NumPy利用广播机制直接实现向量化:
import numpy as np

# 场景:计算点集合与目标点之间的欧氏距离
points = np.random.rand(1000000, 3)
target = np.array([0.5, 0.5, 0.5])

# 【方案 0:原生 Python for 循环(低效做法)】
def calc_distances_native(pts, tgt):
    distances = []
    for i in range(len(pts)):
        dx = pts[i][0] - tgt[0]
        dy = pts[i][1] - tgt[1]
        dz = pts[i][2] - tgt[2]
        dist = (dx**2 + dy**2 + dz**2) ** 0.5
        distances.append(dist)
    return distances

# 【方案 1:NumPy 广播向量化(推荐做法)】
def calc_distances_numpy(pts, tgt):
    # 利用广播机制自动扩展维度,调用底层 C 语言连续向量差与范数
    diff = pts - tgt
    return np.sqrt(np.sum(diff ** 2, axis=1))
x[i] = a * x[i-1] + b * x[i-2]),强行使用NumPy向量化往往需要构造复杂的托普利茨矩阵或卷积,反而会导致内存暴涨。此时强推向量化是不合适的,应该转向下文的Numba。
三、方案二:Numba JIT 编译器(何时选与如何用)
1. 适用场景与技术原理
当算法必须保留显式的for循环结构时,Numba是性能与改造成本综合表现最好的工具。典型场景包括:
- 算法存在严格的时序依赖:如物理模拟积分、马尔可夫链状态更新、金融时间序列递推计算、动态规划等。
- NumPy实现过于消耗内存:某些操作若转换为NumPy广播,会生成巨大的临时高维数组耗尽内存,而纯循环原地计算只需
O(1)额外空间。
Numba通过LLVM编译器架构,在函数被首次调用时读取Python字节码,推断变量的具体机器类型,并直接生成与C语言相同执行效率的原生机器码。只要使用 @njit(即 @jit(nopython=True)),代码在执行循环时便会脱离Python虚拟机,完全运行在CPU寄存器与底层缓存中。
2. 典型重构代码对比
以金融收益率的一阶自回归时序计算(AR(1)模型)为例,由于每一步严重依赖前一步的计算结果,无法直接进行NumPy广播:
import numpy as np
from numba import njit

# 模拟 5,000,000 个时序节点的依赖更新
n = 5000000
alpha = 0.85
shocks = np.random.normal(0, 1, size=n)

# 【方案 0:原生循环(耗时严重)】
def simulate_ar1_native(shocks, alpha):
    out = np.empty_like(shocks)
    out[0] = shocks[0]
    for t in range(1, len(shocks)):
        out[t] = alpha * out[t-1] + shocks[t]
    return out

# 【方案 2:Numba JIT 加速(几乎无需改动逻辑代码)】
@njit(fastmath=True)
def simulate_ar1_numba(shocks, alpha):
    out = np.empty_like(shocks)
    out[0] = shocks[0]
    for t in range(1, len(shocks)):
        out[t] = alpha * out[t-1] + shocks[t]
    return out
四、方案三:并行计算(何时选与如何用)
1. 适用场景与技术原理
NumPy与Numba主要解决的是单核CPU利用效率问题。当单核计算性能已经压榨到极致,或者任务本身属于粗粒度任务批处理时,应选用并行计算:
- 任务完全解耦:每次循环迭代之间毫无数据交互(Embarrassingly Parallel,易并行任务),如独立跑1000组参数模拟、批量转换10万张图片等。
- 单次迭代计算耗时大于1毫秒:如果每次循环只有几微秒,跨进程传递数据与进程调度开销将远超计算本身,不仅不加速反而严重变慢。
由于Python CPython的GIL存在,计算密集型任务不能使用 threading 模块(多线程在GIL制约下只能交替占用单个物理核心),必须使用 multiprocessing 或 concurrent.futures.ProcessPoolExecutor 启动独立的操作系统级子进程,每个子进程拥有独立的Python解释器实例与内存空间。
2. 典型重构代码对比
以下为一个对大批量独立数据样本进行重度拟合/特征提取的工程示例:
from concurrent.futures import ProcessPoolExecutor
import os
import time

# 模拟单次较重任务(例如图像处理、复杂矩阵解方程等耗时 5ms 以上的函数)
def heavy_processing_task(sample_id):
    total = 0
    for i in range(200000):
        total += (i ^ sample_id) % 97
    return total

# 样本列表
sample_list = list(range(1000))

# 【方案 0:单进程串行 for 循环】
def run_serial(samples):
    return [heavy_processing_task(s) for s in samples]

# 【方案 3:ProcessPoolExecutor 进程池粗粒度分块并行】
def run_parallel(samples):
    # 根据 CPU 物理核心数合理分配工人进程数
    max_workers = os.cpu_count() or 4
    # chunksize 关键参数:避免高频细粒度通信,将任务按批次打包发送给子进程
    chunk_size = max(1, len(samples) // (max_workers * 4))

    with ProcessPoolExecutor(max_workers=max_workers) as executor:
        results = list(executor.map(heavy_processing_task, samples, chunksize=chunk_size))
    return results
pickle 序列化,子进程计算完成后再通过管道回传反序列化。如果循环中每次传递的是一个几百兆的庞大DataFrame或列表,序列化与跨进程内存复制将成为新的灾难性瓶颈。对于大型共享只读数组,应使用 multiprocessing.shared_memory 或在多进程外层只传递轻量索引。
五、循环性能优化落地四步法工程流程
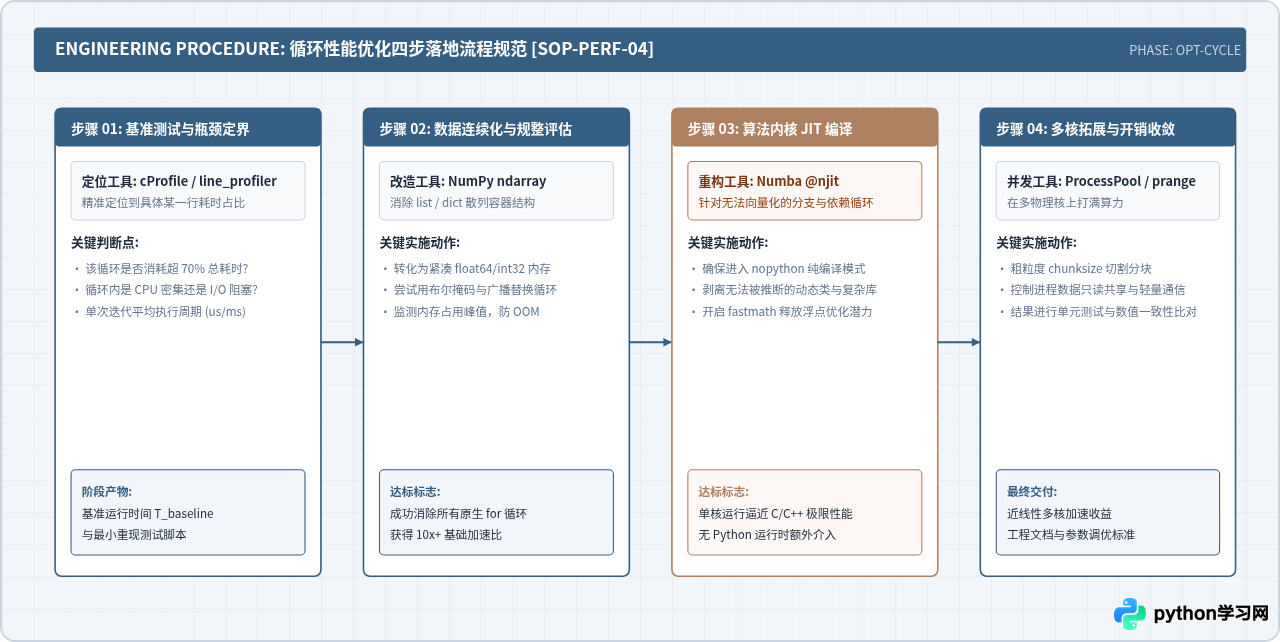
在实际生产环境中,针对存量代码的性能重构必须遵循严格的工程化流程,切忌凭主观臆断随意改写代码。
六、方案全维度对比与组合优化策略
为了让选型更加直观,下表对三种核心加速方案从底层技术特性、改造代价及适用边界进行了横向对比:
| 对比维度 | NumPy 向量化 | Numba (@njit) | 多进程并行计算 |
|---|---|---|---|
| 加速核心机制 | C连续内存 + SIMD单指令多数据流 + 底层BLAS | LLVM 原生机器码即时编译,脱离解释器 | 独立操作系统子进程,绕过单核 GIL 限制 |
| 典型加速比 | 10x ~ 150x | 50x ~ 300x | 接近物理核心数倍数(扣除调度损耗) |
| 代码改造难度 | 低到中等(需转换为向量/矩阵思维) | 极低(大多仅加装饰器,保留for结构) | 中等(需设计任务拆分、合并与序列化接口) |
| 时序依赖循环支持 | 较差(难以优雅表达 i 依赖 i-1) |
极佳(完美保持原生迭代时序逻辑) | 不支持(任务间必须完全独立解耦) |
| 内存开销特征 | 广播与中间临时变量可能占用较大显存/内存 | 原地计算,额外内存占用趋近于 0 | 多进程各自占用独立内存空间,开销倍增 |
| 首次执行开销 | 无(即调即用) | 存在数毫秒到数百毫秒的 Warmup 编译耗时 | 存在子进程创建与上下文初始化延迟 |
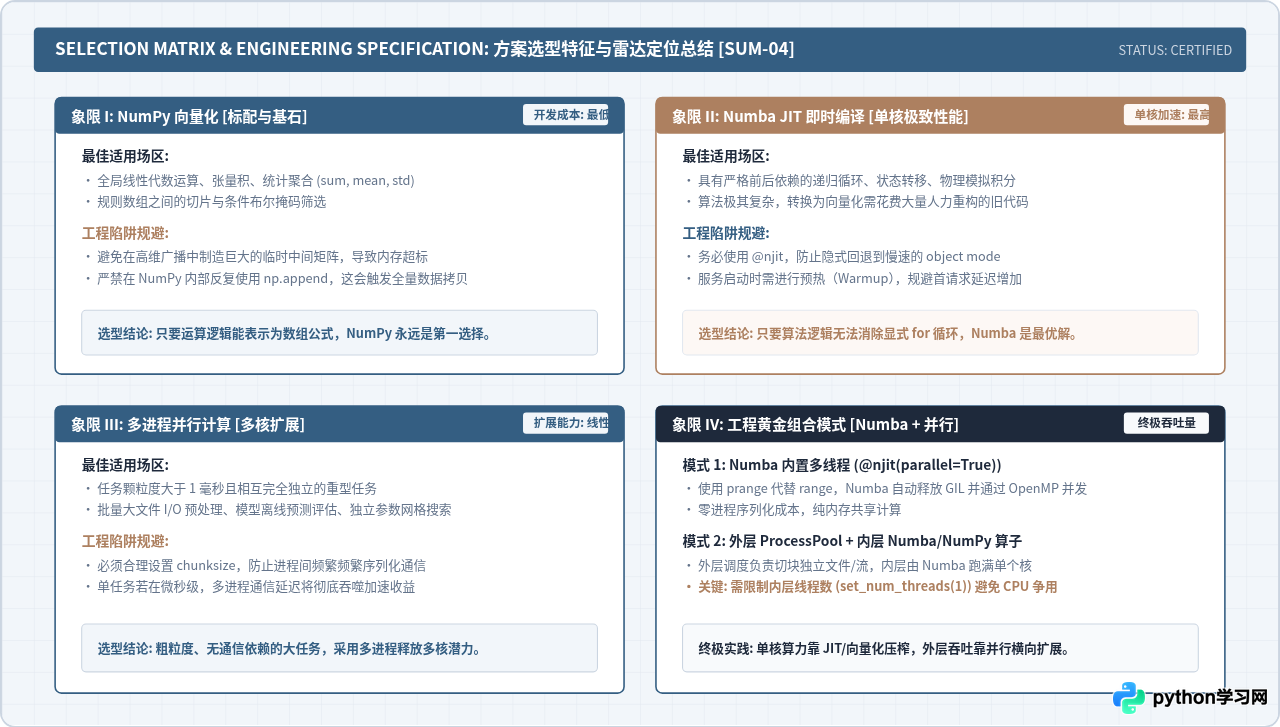
七、常见工程误区与排错提醒
在实施循环优化的过程中,开发者最容易踩入以下四个陷阱:
- 误区一:细粒度循环盲目上多进程。如果一个for循环只需执行数微秒,改用
multiprocessing后,创建子进程与通过管道序列化对象的耗时比计算本身高出几百倍,导致程序性能断崖式下跌。规则:单次迭代耗时未达到毫秒级,严禁使用多进程。 - 误区二:Numba 函数内部混入复杂 Python 对象。在
@njit修饰的函数中,若传入了 Pandas DataFrame、字典或自定义类,Numba 将无法推断类型并报错,或者在未指定nopython=True时隐式回退到 object 模式,执行速度与原生 Python 无异。规则:始终使用@njit,只传递基础数字与 NumPy 连续数组。 - 误区三:NumPy 广播产生巨大中间数组导致 OOM。在计算成对距离等矩阵操作时,若数据量达到百万级别,扩展维度广播会尝试在内存中开辟上百 GB 的连续空间,直接引发系统内存耗尽。规则:超大规模数据应采用分块计算,或改用 Numba 原地标量累加。
- 误区四:多层嵌套并发引发 CPU 核心严重争用。在外层使用了
ProcessPoolExecutor启动 8 个子进程,内层调用的 NumPy 或 Numba 又默认开启了 8 线程并行,导致 64 个并发工作单元争抢 8 个物理核心,严重的上下文切换损耗将抵消所有加速收益。规则:外层多进程时,内层应设置环境变量OMP_NUM_THREADS=1和MKL_NUM_THREADS=1。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















