


Web后端与AI开发:Python和Java的主流应用场景对比
深入对比Python和Java在Web后端开发与AI开发中的主流应用场景,从框架生态、性能特点、开发效率等维度帮助开发者做出合理的技术选择。
Python和Java是当前后端开发与AI领域使用最广泛的两种语言,但它们的优势区间并不重叠。Python在AI和数据处理上积累了无可替代的生态,Java在大规模Web后端和企业系统中保持着稳固地位。本文从实际应用场景出发,逐个维度说明两者的差异和适用条件,帮助你在具体项目中做出有依据的选择。
一、Web后端开发:各自的主场在哪里
Java的Web后端优势
Java在Web后端领域的核心竞争力来自三个方面:成熟的企业级框架、出色的并发处理能力,以及长期维护的可靠性。
Spring Boot是Java后端事实上的标准框架。它提供了从依赖注入、事务管理到安全认证的完整方案,几乎覆盖了企业应用的所有基础需求。一个典型的Spring Boot接口定义如下:
@RestController
@RequestMapping("/api/users")
public class UserController {

    @Autowired
    private UserService userService;

    @GetMapping("/{id}")
    public ResponseEntity<User> getUser(@PathVariable Long id) {
        User user = userService.findById(id);
        return ResponseEntity.ok(user);
    }

    @PostMapping
    public ResponseEntity<User> createUser(@Valid @RequestBody UserDTO dto) {
        User saved = userService.create(dto);
        return ResponseEntity.status(HttpStatus.CREATED).body(saved);
    }
}
这段代码背后,Spring已经处理了参数校验、异常映射、序列化等工作。Java的强类型系统在大型项目中起到了天然的约束作用——编译阶段就能发现接口不匹配、类型错误等问题,这在几十人协作的项目中比运行时报错有效得多。
在高并发场景下,Java的JVM经过二十多年的优化,在长时间运行的服务中表现稳定。配合虚拟线程(Java 21引入的Project Loom),处理大量IO密集型请求时不再需要复杂的异步编程模型。银行、电商、物流等行业的核心交易系统普遍选择Java,看重的正是这种可预测的性能和长期稳定性。
Python的Web后端特点
Python在Web后端的优势是开发速度和灵活性。Django和Flask是两个主要选择,定位不同:Django是"全家桶",内置ORM、管理后台、认证系统;Flask是"微框架",核心精简,按需引入组件。
用Flask写同样的用户接口,代码量明显更少:
from flask import Flask, request, jsonify

app = Flask(__name__)

@app.route("/api/users/<int:user_id>", methods=["GET"])
def get_user(user_id):
    user = UserService.find_by_id(user_id)
    return jsonify(user.to_dict())

@app.route("/api/users", methods=["POST"])
def create_user():
    data = request.get_json()
    user = UserService.create(data)
    return jsonify(user.to_dict()), 201
Python后端更适合中小规模的项目、快速原型验证,以及需要与数据处理流程紧密集成的场景。比如一个内部数据分析平台,后端需要调用pandas做数据清洗,再用matplotlib生成图表返回前端——这种场景下Python不需要跨语言调用,整个流程在一个技术栈内完成。
需要正视的问题是Python在CPU密集型任务上的性能瓶颈。CPython的全局解释器锁(GIL)限制了多线程并行计算的效率。对于单纯的Web请求处理(IO密集型),这个限制影响不大;但如果后端需要做大量计算,就需要通过多进程、异步框架(如FastAPI配合uvicorn)或将计算任务下放到专门的服务来解决。
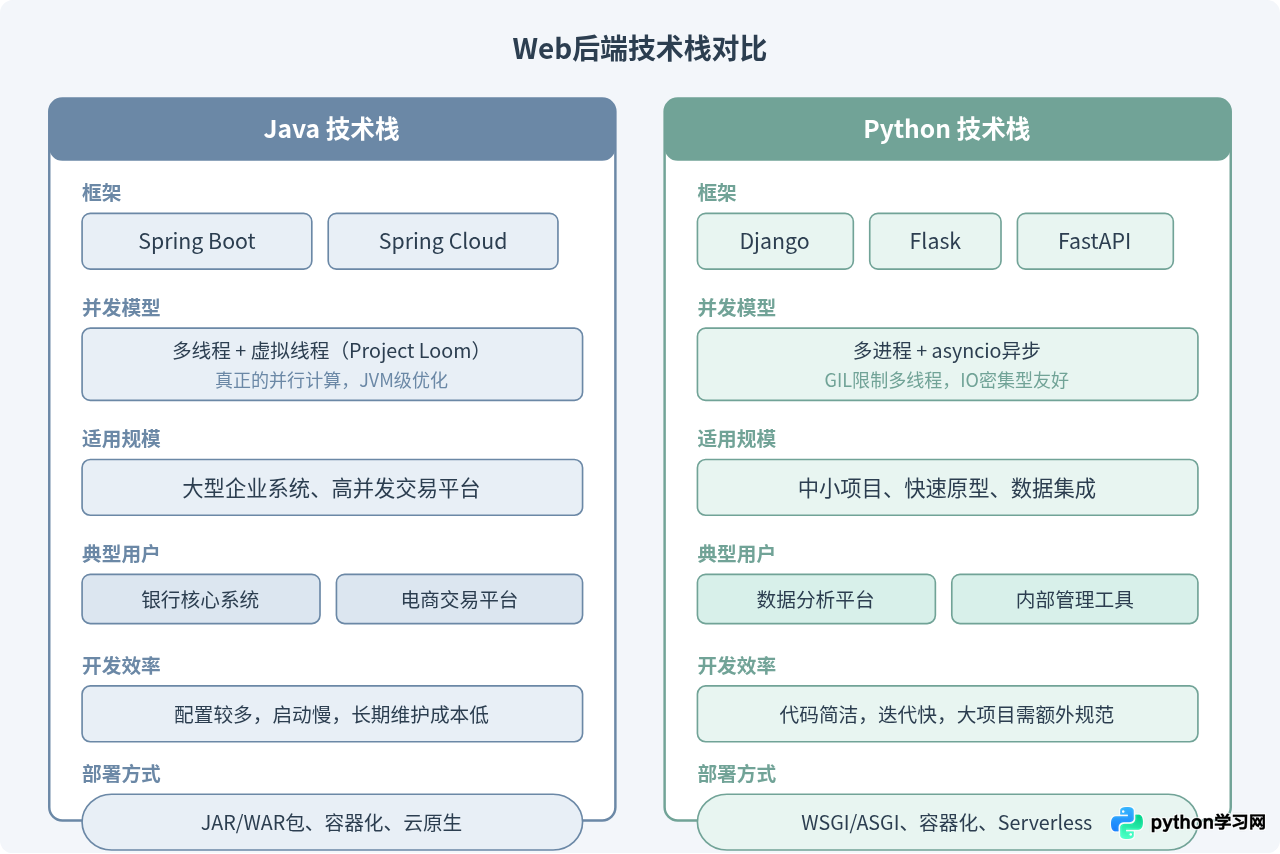
图1:Python与Java在Web后端开发中的技术栈与特点对比
二、AI开发:Python为什么占据主导地位
Python的AI生态
在AI和机器学习领域,Python的主导地位不是偶然形成的,而是由工具链的完整性决定的。从数据预处理到模型训练再到部署推理,Python覆盖了完整的工作流:
- 数据处理:NumPy提供高性能数值计算,pandas处理结构化数据,两者是几乎所有数据工作的起点
- 模型训练:TensorFlow和PyTorch是深度学习的两大框架,scikit-learn覆盖了传统机器学习算法
- 可视化:matplotlib、seaborn用于数据分析图表,TensorBoard用于训练过程监控
- 部署推理:ONNX Runtime、TensorFlow Serving、Triton Inference Server均提供Python接口
一个使用PyTorch训练图像分类模型的基本流程如下:
import torch
import torch.nn as nn
from torchvision import datasets, transforms, models

# 数据预处理
transform = transforms.Compose([
    transforms.Resize(224),
    transforms.ToTensor(),
    transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
])

train_dataset = datasets.ImageFolder("data/train", transform=transform)
train_loader = torch.utils.data.DataLoader(train_dataset, batch_size=32, shuffle=True)

# 加载预训练模型并替换分类层
model = models.resnet18(pretrained=True)
model.fc = nn.Linear(model.fc.in_features, 10)  # 10个分类

# 训练
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
criterion = nn.CrossEntropyLoss()

for epoch in range(10):
    for images, labels in train_loader:
        outputs = model(images)
        loss = criterion(outputs, labels)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
这段代码从数据加载到模型训练,全程在Python中完成,不需要切换语言或额外的胶水代码。PyTorch底层的计算内核是C++和CUDA实现的,Python只负责描述计算流程,实际运算速度不受Python解释器限制。
Java在AI领域的角色
Java在AI方面并非完全空白。Deeplearning4j(DL4J)是JVM平台上较成熟的深度学习框架,适合已有Java技术栈的团队在不切换语言的前提下做模型训练。Apache Spark的MLlib提供了分布式机器学习能力,在大数据量的特征工程和传统算法训练上有优势。
但现实情况是,AI领域的新算法、新模型几乎都首先发布Python实现。研究论文附带的代码、Hugging Face上的预训练模型、各大云平台的AI SDK,Python版本总是最先完善。选择Java做AI开发,意味着可用的模型和工具更少,社区支持更弱,遇到问题时可参考的资料也更有限。
Java在AI领域更实际的定位是模型部署和推理服务。训练阶段用Python,把训练好的模型导出为ONNX格式,然后在Java后端通过ONNX Runtime的Java API加载推理。这种方式既利用了Python的训练生态,又保持了线上服务用Java的一致性。

图2:AI开发全流程中Python与Java的典型分工与协作模式
三、关键维度逐项对比
开发效率与代码量
完成同样的功能,Python的代码量通常是Java的三分之一到二分之一。Python不需要声明类型、不需要编译、不需要写getter/setter,交互式环境(Jupyter Notebook、IPython)可以逐行测试代码。这种快速反馈循环在探索性工作中尤其有价值——数据分析师不需要每次修改后重新编译运行整个项目。
Java的类型声明和编译步骤在小项目中是负担,但在大项目中变成了优势。当代码量超过几万行、参与者超过十人时,静态类型带来的自动补全、重构支持和编译期检查,能显著降低集成错误。
性能与资源消耗
纯计算性能上,Java通过JIT编译通常比CPython快5到10倍。但在AI场景下,这个差距被框架的C++/CUDA内核抹平了——Python调用PyTorch做矩阵运算时,实际执行速度和Java调用同一底层库没有本质区别。
在Web后端场景下,Java应用的内存占用通常高于Python(JVM本身就需要几百MB),但在高负载下的吞吐量和延迟稳定性上,Java有明显优势。Python的异步框架(如uvicorn + FastAPI)在IO密集型场景下性能表现不差,但在CPU密集型请求处理上仍有瓶颈。
生态与社区
两种语言的包管理和生态成熟度不在一个方向上:
| 维度 | Python | Java |
|---|---|---|
| 包管理 | pip / conda,简单直接 | Maven / Gradle,功能完善但配置繁琐 |
| AI/ML库 | 极其丰富,主流首选 | 可用但有限,更新滞后 |
| Web框架 | Django、Flask、FastAPI | Spring生态,完整成熟 |
| 企业工具 | 较弱,需要额外整合 | 监控、日志、分布式追踪完善 |
| 招聘市场 | AI和数据岗位首选 | 后端和企业开发岗位首选 |
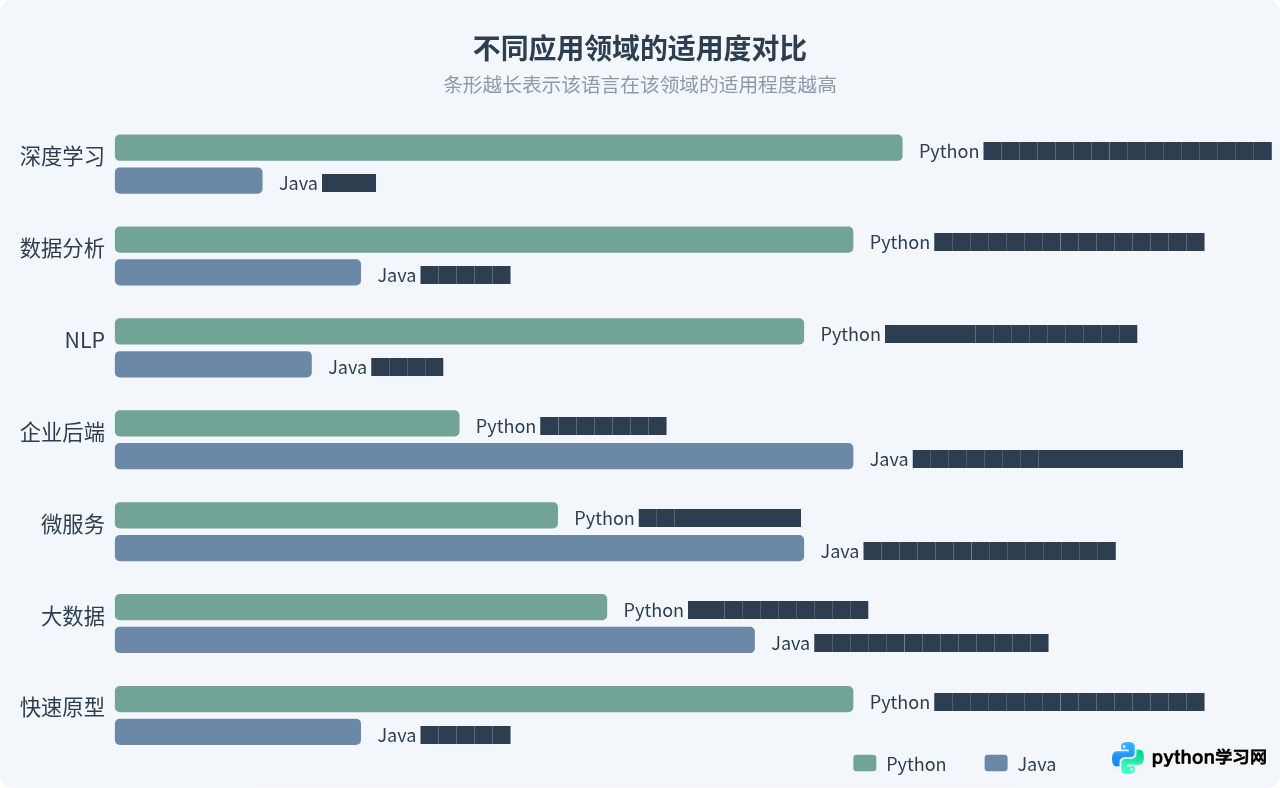
图3:Python与Java在不同应用领域中的适用程度对比
四、实际项目中怎么选
技术选择不能脱离项目背景。以下是几种常见场景和对应的建议:
场景一:从零搭建一个AI产品后端。产品需要接收用户输入,调用模型推理,返回结果。如果团队以AI工程师为主,选Python更顺畅。FastAPI提供了足够好的异步性能,模型加载和推理都在同一进程内完成,开发和调试效率高。当请求量增长到Python单机扛不住时,水平扩容(多实例 + 负载均衡)通常比切换语言成本更低。
场景二:已有Java后端系统,需要接入AI能力。这是企业中最常见的情况。不建议把Java后端重写成Python,而是把AI功能作为独立的Python微服务部署,通过REST API或gRPC与Java主服务通信。Java端只需要发HTTP请求或gRPC调用,不涉及模型细节。
// Java端调用Python AI服务的示例
@Service
public class AIService {

    private final RestTemplate restTemplate;

    public PredictionResult predict(InputData input) {
        String aiServiceUrl = "http://ai-service:8000/predict";
        ResponseEntity<PredictionResult> response = restTemplate.postForEntity(
            aiServiceUrl, input, PredictionResult.class
        );
        return response.getBody();
    }
}场景三:需要高并发的交易系统。核心交易链路建议用Java。Spring Boot配合关系型数据库的事务管理、消息队列的可靠投递、分布式锁等能力在Java生态中是开箱即用的。Python虽然也能做到,但需要更多的手动整合,在出问题时的排查手段也不如Java成熟。
场景四:数据分析平台或内部工具。Python是更好的选择。Django Admin可以在半天内搭出一个可用的管理后台,pandas和SQLAlchemy处理数据查询和转换,Jupyter Notebook方便数据团队探索和验证,部署到云上的成本也不高。
五、混合使用的工程实践
实际项目中,Python和Java混合使用越来越常见。关键是处理好两者之间的通信和边界划分。
通信方式选择
REST API是最简单的方式,适合请求频率不高、延迟要求不严格的场景。gRPC在需要高性能通信时更合适,它基于HTTP/2和Protocol Buffers,序列化效率比JSON高,支持流式传输。消息队列(如Kafka、RabbitMQ)适合异步处理,Python端完成模型推理后把结果写入消息队列,Java端消费结果后更新数据库。
部署与运维
容器化是混合技术栈的基础。Python服务和Java服务各自打包为Docker镜像,通过Kubernetes编排。需要注意的是Python镜像的依赖管理——AI相关的Python包往往很大(PyTorch的Docker镜像可以超过5GB),需要精心选择基础镜像并做多阶段构建来控制镜像大小。
监控方面,两种语言都有成熟的Prometheus客户端库。建议统一使用OpenTelemetry做分布式追踪,它同时支持Python和Java,可以把一次请求在不同语言服务间的调用链完整串起来。
六、总结与选择依据
把Python和Java的选择简化为三个核心问题:
- 项目的核心技术挑战是什么?如果是AI/ML模型开发、数据分析或快速原型验证,Python是首选。如果是高并发事务处理、复杂业务逻辑或大规模团队协作的企业系统,Java更可靠。
- 团队的技术背景是什么?语言本身的优劣不如团队对它的熟悉程度重要。一个Java团队硬切Python做Web后端,短期效率会显著下降。
- 是否可以混合使用?在微服务架构下,混合使用是最务实的方案。Python负责AI和数据服务,Java负责核心业务逻辑和网关,两者通过API通信。
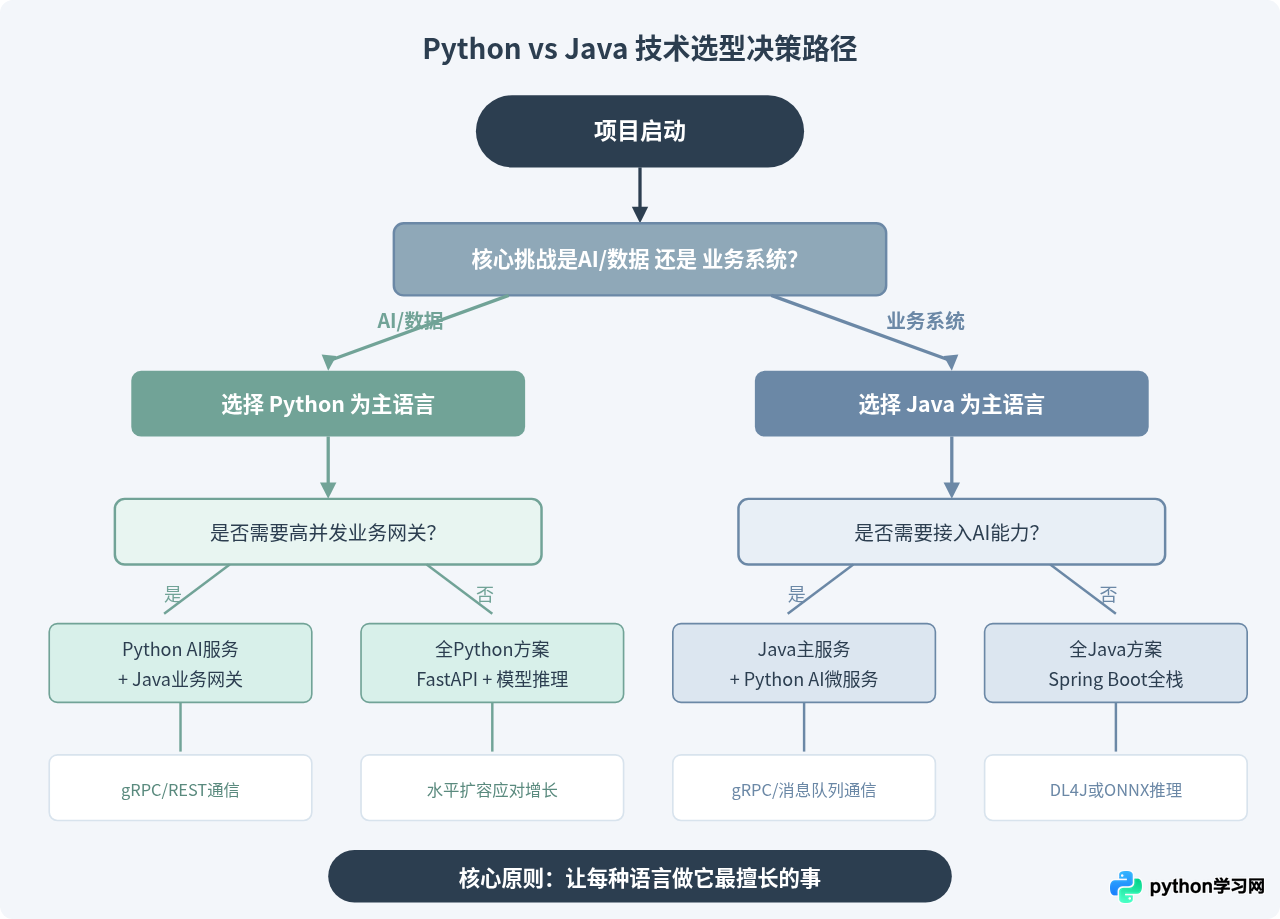
图4:Python与Java技术选型的决策路径与推荐方案
不存在哪种语言绝对优于另一种的结论。Python和Java在编程语言层面的差异——动态与静态类型、解释与编译、简洁与严谨——使得它们在不同场景下各有所长。理解这些差异的具体表现,比记住笼统的优缺点更有助于做出好的技术决策。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















