


Python循环语句后面的else子句有什么作用
深入解析Python循环语句后面的else子句的作用与运行机制,结合代码示例、执行流程图与常见误区,讲透for...else和while...else在元素检索、重试机制中的实战应用与最佳重构方案。
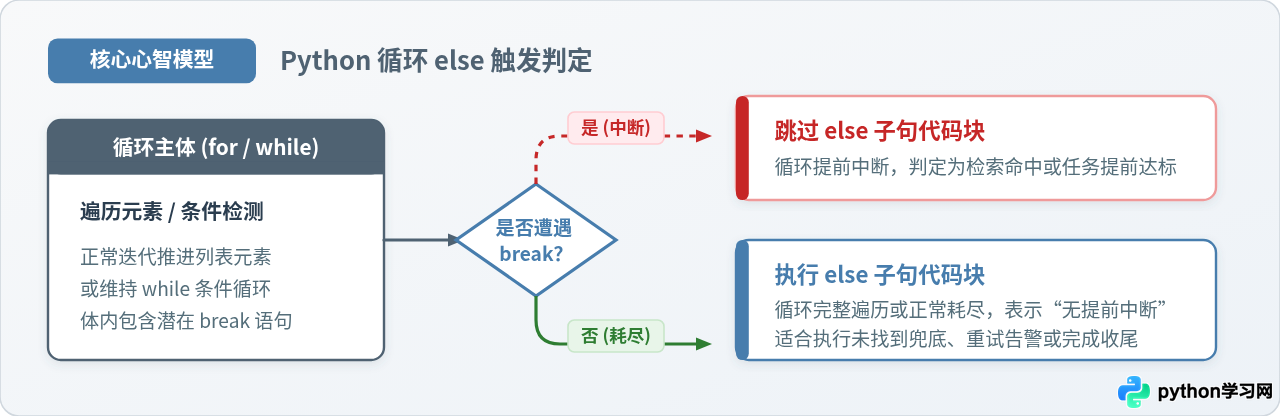
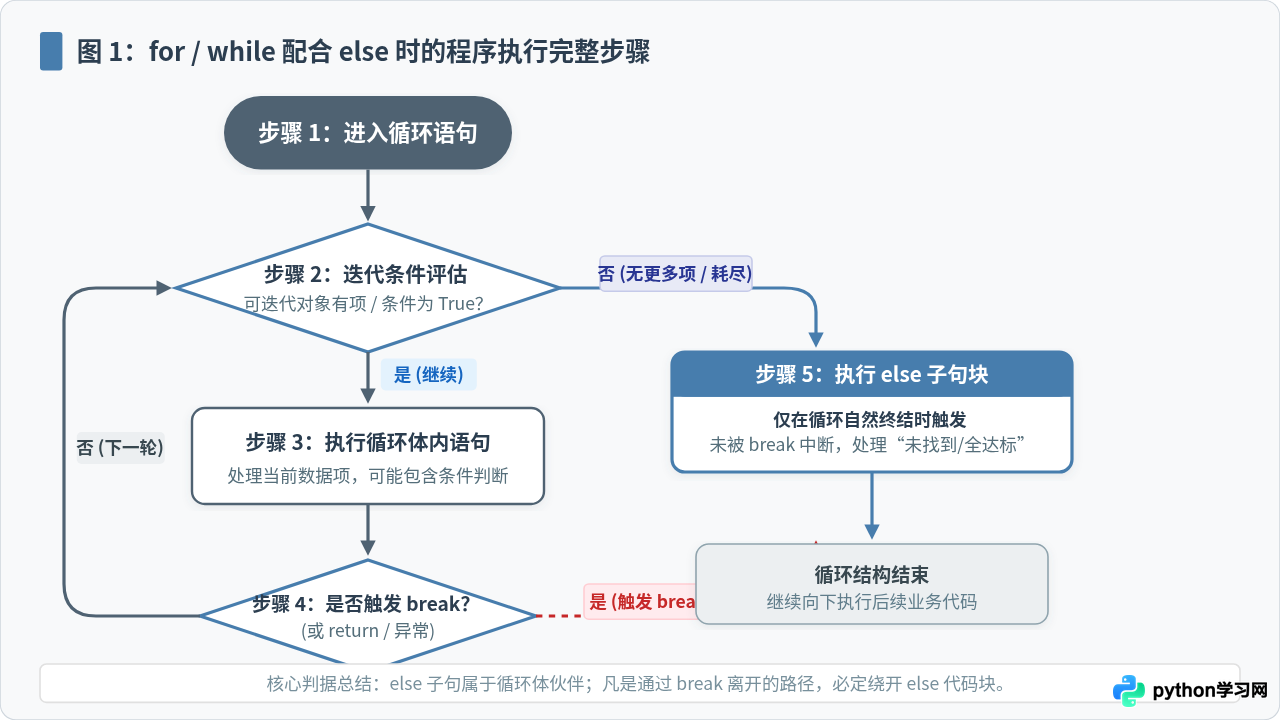
for 和 while 循环后面的 else 子句并不是在条件不满足时像普通 if-else 那样进行二选一互斥分支,而是专门在循环正常遍历结束、中途未被 break 语句打断时才会执行。只要循环在执行过程中触发了 break,else 代码块就会被直接跳过。这个语法结构最主要的作用,是简洁地处理“在循环中查找目标未果”或“耗尽全部重试次数”等状态收尾,从而省去手动定义布尔标志位(flag)的繁琐操作。
一、执行时机:else 究竟什么时候运行?
很多刚从 C/C++、Java 或 JavaScript 转到 Python 的开发者,看到循环后面的 else 时,第一反应往往是把它类比为“如果循环条件一开始就不成立,就走 else”。这种直觉在 Python 里是完全错误的。
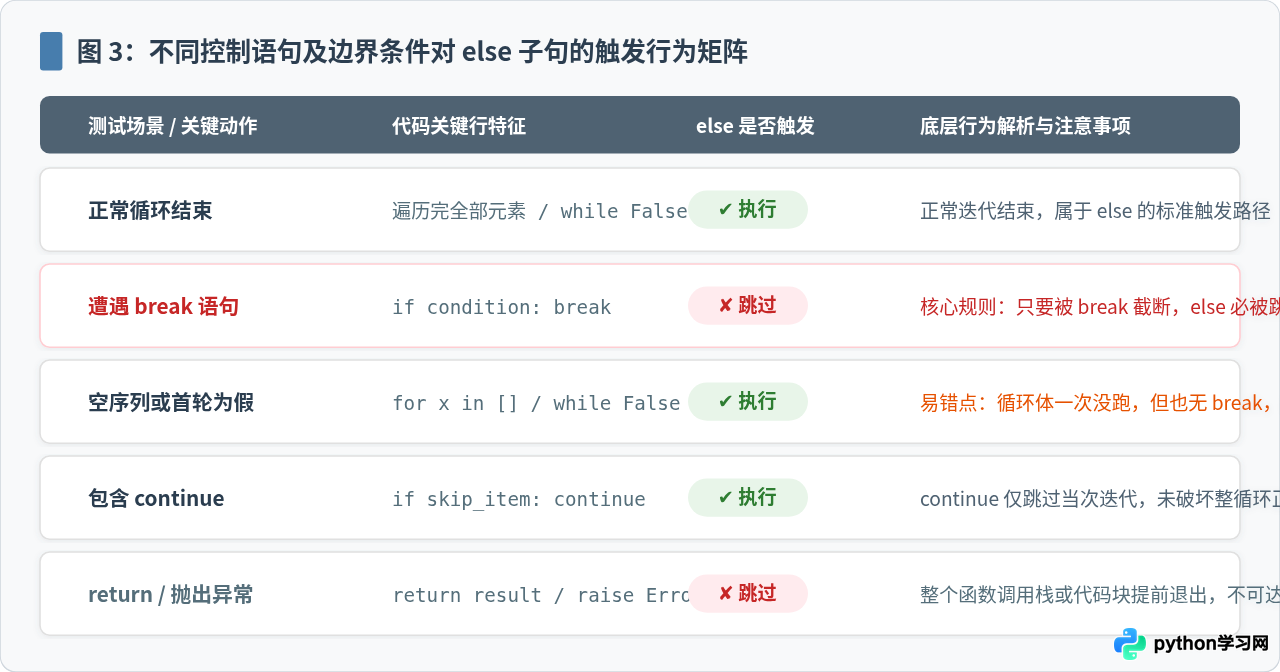
在 Python 的底层设计中,循环语句的 else 可以理解为“无 break 中断时的后置处理块(no-break then)”。它的完整触发规则可以归纳为以下几点:
- 正常穷尽可迭代对象:在
for循环按顺序遍历完列表、元组、字典或生成器中的每一个元素后,程序会无缝进入else代码块。 - 循环条件自然变为 False:在
while循环中,当判断条件由真变假自然退出时,程序会立即进入else代码块。 - 空序列或初始条件即为假:当
for x in []遍历一个空列表,或者while False时,循环体内部代码一次都不会执行,但由于整个过程从未触发 break,因此else依然会被执行。 - 触发 break 时直接跳过:一旦循环体内的
if分支命中了break并强行中断循环,else代码块将被永久忽略,程序直接跳到循环外部的下一行语句。 - 触发 return 或抛出异常:如果循环体内执行了
return退出整个函数,或者抛出了未被捕获的异常,控制流脱离了循环上下文,else同样不会被执行。
二、实战推导:消除繁琐的 Flag 标志变量
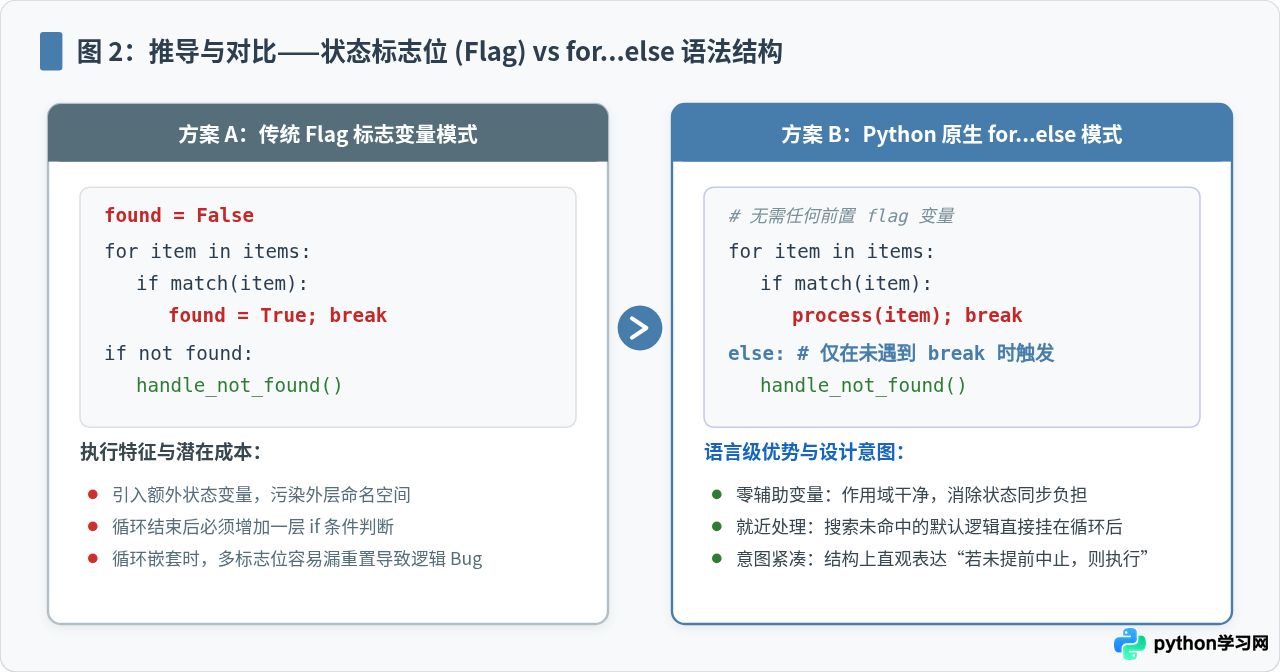
理解了触发时机后,我们通过一个常见的业务需求来看看它的具体价值:在一组商品数据中检索特定编号的项,如果找到则输出信息并停止;如果整批数据都扫完了仍未找到,则需要输出“未找到该商品”的默认提示。
1. 传统写法:借助布尔标志变量
在不支持循环 else 的语言中,我们通常需要先在循环外部声明一个 found = False,找到时置为 True 并 break,最后在循环外部再次用 if not found: 做检查:
# 示例一:使用标志变量进行检索
products = ["Keyboard", "Mouse", "Monitor", "Headset"]
target = "Printer"

# 1. 外部维护标志位
found = False
for item in products:
    if item == target:
        print(f"找到目标商品: {item}")
        found = True
        break

# 2. 循环后二次判定
if not found:
    print("遍历全部商品,未找到目标")
这种写法逻辑没有任何问题,但存在明显的维护成本:额外引入了变量 found,增加了阅读者追踪状态的认知负荷;当业务逻辑变长或嵌套循环时,还容易遗漏标志位的重置。
2. 优雅写法:利用 for...else 原生语法
使用 Python 原生支持的 for...else,可以省去标志变量的声明与判定,代码逻辑更加内聚:
# 示例二:使用 for...else 简洁写法
products = ["Keyboard", "Mouse", "Monitor", "Headset"]
target = "Printer"

for item in products:
    if item == target:
        print(f"找到目标商品: {item}")
        break
else:
    # 仅在整个循环遍历完毕且未曾 break 时触发
    print("遍历全部商品,未找到目标")
在上面的示例中,由于列表中不存在 "Printer",循环完整执行完 4 次迭代,没有一次触发 break,于是自动落入 else 子句,输出“遍历全部商品,未找到目标”。
三、另一个经典场景:带重试次数的循环
除了线性检索,另一个极其契合 loop...else 的场景是有限次数的网络请求或任务重试。假设我们需要向远端服务发起请求,允许最多重试 3 次,成功则立即处理响应并结束;若重试全部用尽依然失败,则执行告警或后备降级逻辑:
# 示例三:重试限制与告警兜底
import random
import time

max_retries = 3
for attempt in range(1, max_retries + 1):
    print(f"正在尝试第 {attempt} 次连接...")
    # 模拟请求成功率
    success = (random.random() > 0.7)
    if success:
        print("连接成功,准备进入业务逻辑。")
        break
    time.sleep(0.5)
else:
    # 3 次循环完整耗尽,没有一次 break 成功
    print("警告:已达最大重试次数,所有连接尝试均失败,触发容灾策略。")
在这个模式下,break 表达“任务提前达成,无需继续”,而 else 表达“穷举所有可能性之后仍未成功,进入失败后处理”。结构清晰,层次分明。
四、容易踩坑的常见误区与细节辨析
虽然语法简单,但在日常开发和代码审查中,有三个常见误区最容易让初学者困惑:
误区 1:认为“空循环不会执行 else”
很多开发者误以为 else 是“循环体执行后的回调”,因此觉得空列表既然没有运行循环体,自然也不会执行 else。请看以下代码:
# 空列表测试
for x in []:
    print(x)
else:
    print("进入了 else 分支!")

# 输出结果示例:
# 进入了 else 分支!
由于空列表在第一时间就“正常耗尽”,没有任何 break 被触发,因此它完完全全符合 else 的执行前提,必定会输出对应内容。
误区 2:continue 会不会阻断 else?
答案是绝对不会。continue 的作用是放弃当前单次迭代剩余的代码,直接进入下一次迭代的判定与执行。只要在所有迭代轮次中都没有触发 break,最终序列遍历完毕时依然会正常触发 else。
误区 3:视觉层面的“悬挂 else 歧义”
当循环体内部逻辑较长(例如超过 20 行),或者循环内部包含多层 if-elif-else 嵌套时,循环最底部的 else: 在缩进上极易被同事(甚至未来的自己)误读为内层某个 if 的对应分支。这种代码可读性隐患是导致该语法备受争议的主要原因。
五、工程建议:什么时候该用,什么时候应该重构?
在真实的工程项目中,是否使用循环语句的 else 子句,取决于代码长度、团队习惯以及是否有更直观的替代方案:
- 循环体非常简短(5~10 行以内),一眼就能看清整个
for...break...else结构; - 算法题中的素数判定、因数检查、无害元素碰撞排查等纯粹逻辑;
- 轻量级的循环重试流程。
重构方案 A:封装成函数,使用早期返回(Early Return)
当逻辑变复杂时,最推荐的重构方案是将循环检索抽取为独立的纯函数。在循环内找到目标直接 return,循环结束后自然 return None 或抛出异常。这种方式在所有编程语言中通用,没有任何语法心智负担:
def find_user_by_id(user_list, target_id):
    # 提前返回模式替代 loop-else
    for user in user_list:
        if user["id"] == target_id:
            return user
    return None  # 循环自然结束时返回默认值
重构方案 B:利用 any() 或 all() 内置函数
如果你使用循环的目的只是为了检查“是否存在某个满足条件的项”或者“是否所有项都满足条件”,使用 Python 内置的高阶函数 any() 或 all() 结合生成器表达式,不仅具备短路求值特性,而且表达更地道(Pythonic):
# 检查是否有未支付订单
orders = [{"id": 101, "paid": True}, {"id": 102, "paid": False}]

# 替代复杂的 for...break...else 标志位判断
has_unpaid = any(not o["paid"] for o in orders)
print(f"是否存在未支付订单: {has_unpaid}")
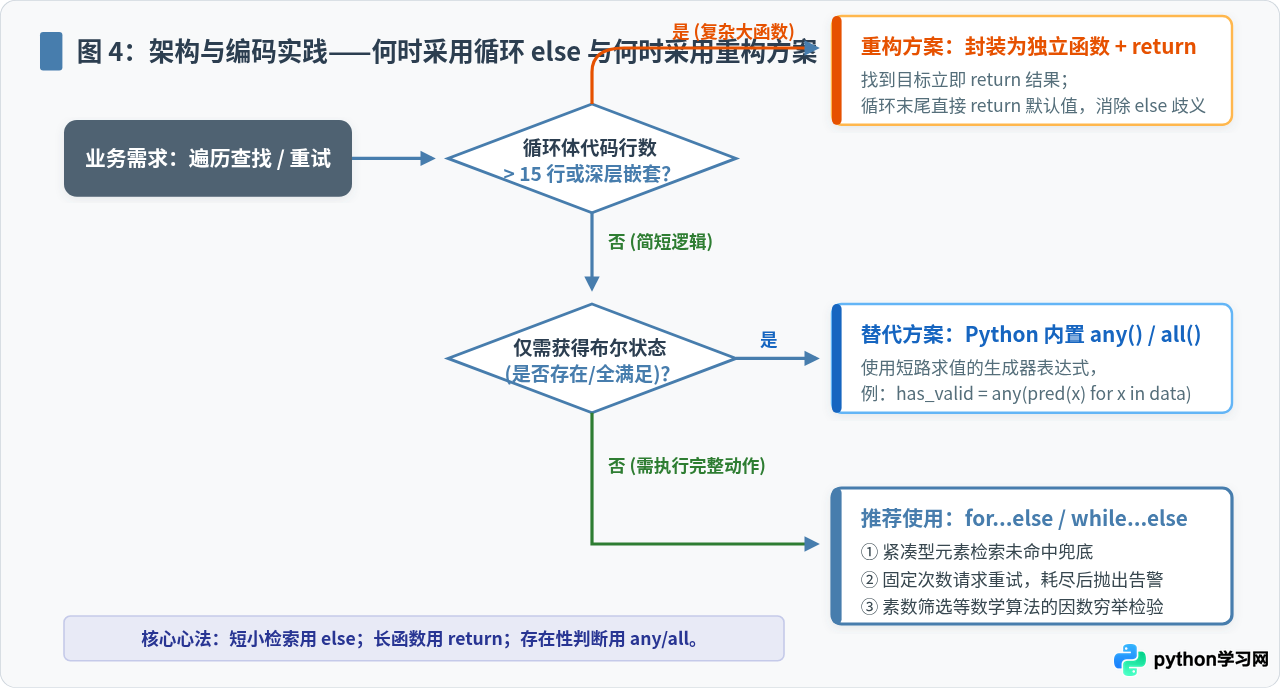
Python 循环语句后面的 else 子句本质是“当循环未被 break 中断时的自然完成分支”。它为检索未命中和重试耗尽提供了干净的原生语法支持。在编写简短清晰的算法检索时可以放心使用;在长代码或复杂业务逻辑中,则优先推荐抽取函数并结合 return 或内置高阶函数。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















