


Python主要就业方向盘点:Web开发、数据分析与AI的区别
全面盘点Python三大主要就业方向:Web开发、数据分析与人工智能。从核心定位、技术栈、实际工作链路、数学门槛与选择依据展开深入对比,帮助读者找到适合自己的技术路径。
学习 Python 达到一定阶段后,很多学习者会发现单纯掌握语法并不足以支撑求职,因为 Python 在工业界主要分化为三个彼此独立又高度专业的方向:Web 后端开发、数据分析与人工智能(算法与机器学习)。这三个方向使用的编程语言虽同为 Python,但核心解决的问题、日常交付的产出物、依赖的技术栈外延以及对数学和工程素养的要求大相径庭。本文将通过详尽的核心对比、技术栈剖析、日常工作链路拆解与能力阶梯梳理,帮助你清晰区分这三大方向,并根据自身背景做出切实可行的职业抉择。
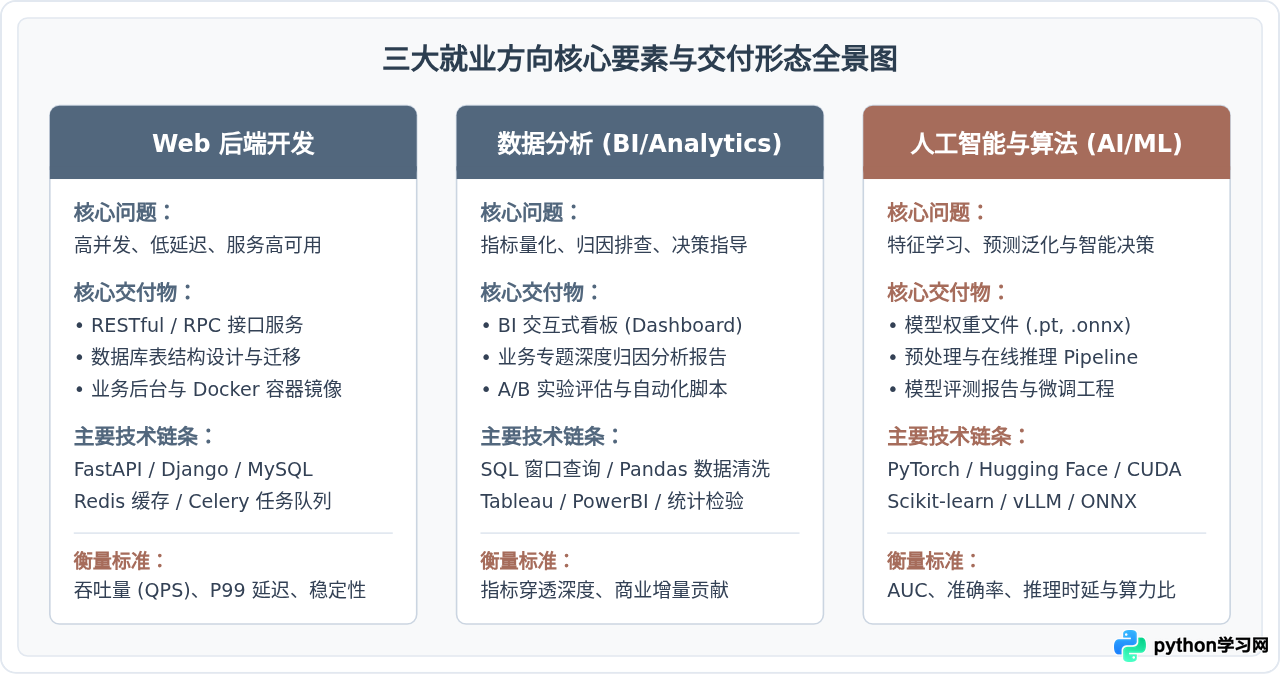
一、核心定位与交付产物对比
区分职业方向最直接的方法,不是看岗位招聘名称,而是看这个岗位最终向业务部门或用户交付什么成果,以及系统如何衡量其工作价值。
- Web 后端开发:本质是软件工程与服务构建。工程师的核心任务是支撑业务系统的稳定运转,编写业务逻辑代码、设计关系型与非关系型数据库结构、提供高吞吐低延迟的 RESTful 或 RPC 接口,并保障系统在流量峰值下的可用性、并发安全与数据一致性。其最终交付物是稳定运行在服务器上的后端程序、API 文档以及自动化部署配置。
- 数据分析:本质是业务洞察与量化决策。分析师以业务数据为原料,通过 SQL 提取、Pandas 清洗转换以及统计检验,诊断业务波动的内在动因,评估功能上线的实验效果,为管理层和产品经理提供数据证据。其最终交付物是交互式 BI 仪表板、专题数据分析报告以及自动化的日常监控报表。
- 人工智能(AI / 机器学习):本质是模式识别与概率建模。算法工程师通过特征工程构建、模型结构选型、训练循环调优和推理加速,使机器具备预测、分类、生成或决策能力。其最终交付物是经过验证的模型权重文件(如 PyTorch 模型、ONNX 格式导出)、推理服务 Pipeline 以及泛化能力评估指标。
二、技术栈与日常工具链的实质差异
虽然三个方向都在编写 .py 脚本,但在日常工作中,你所调用的库以及与之协同的外部系统存在本质区别。
1. Web 后端开发:重工程、重架构、重规范
Web 开发对 Python 语法本身的关注点在于面向对象设计模式、类型提示(Type Hints)、异步非阻塞编程(asyncio)以及并发控制。开发者大部分时间在与数据库、缓存中间件以及网络协议打交道。
- 主流框架:FastAPI(目前微服务与 API 开发的首选,基于类型注解与异步原生支持)、Django(功能完备的全功能大而全框架,自带强健的 ORM 与 Admin 后台)、Flask(轻量微框架,适合快速构建小工具)。
- 核心依赖系统:MySQL/PostgreSQL(数据持久化与索引优化)、Redis(高频数据缓存与分布式锁)、Celery/RabbitMQ(异步耗时任务解耦与消息流转)、Docker/Nginx(容器化封装与反向代理负载均衡)。
# Web开发典型代码片段:基于 FastAPI 的结构化异步接口
from fastapi import FastAPI, Depends, HTTPException, status
from pydantic import BaseModel, Field

app = FastAPI()

class UserCreateRequest(BaseModel):
    username: str = Field(..., min_length=3, max_length=32)
    email: str = Field(..., pattern=r"^[\w\.-]+@[\w\.-]+\.\w+$")

@app.post("/api/v1/users", status_code=status.HTTP_201_CREATED)
async def create_user(payload: UserCreateRequest):
    # 涉及请求体验证、异步数据库连接池操作、异常捕获与状态码规范
    return {"status": "success", "user": payload.username}
2. 数据分析:重业务、重逻辑、重统计
数据分析师的核心并非构建长久常驻的后台守护进程,而是从结构化与半结构化数据中挖掘信息。SQL 的比重在很多场景下甚至高于 Python 本身。
- 核心库:Pandas(数据切片、透视、合并与分组聚合)、NumPy(底层矩阵与矢量化运算)、Matplotlib/Seaborn(统计图形绘制与模式呈现)。
- 核心依赖系统:SQL(深度掌握复杂连接、窗口函数如
ROW_NUMBER()与LEAD/LAG)、数据仓库(Hive、ClickHouse、Snowflake)、BI 商业智能工具(Tableau、PowerBI、FineBI)。
# 数据分析典型代码片段:基于 Pandas 的业务指标聚合与切片
import pandas as pd

# 读取订单明细并计算用户留存与复购间隔
df = pd.read_csv("orders.csv", parse_dates=["order_time"])
user_metrics = (
    df.groupby("user_id")
      .agg(
          total_spend=("amount", "sum"),
          order_count=("order_id", "count"),
          last_order=("order_time", "max")
      )
      .reset_index()
)
# 筛选出高价值活跃用户群体并输出统计特征
vip_users = user_metrics.query("total_spend > 1000 and order_count >= 3")
3. 人工智能与机器学习:重数学、重算力、重实验
AI 方向的核心工作通常围绕“实验—迭代”展开。算法工程师需要阅读前沿论文、设计神经网络结构、处理海量多模态数据,并在 GPU 集群上监控训练收敛情况。
- 核心框架:PyTorch(学术界与工业界最主流的深度学习平台)、TensorFlow(历史存量部署广泛)、Hugging Face 生态(Transformers、Datasets、PEFT 大模型微调套件)。
- 算法与基础设施:Scikit-learn(经典机器学习与特征预处理)、CUDA 与 cuDNN(GPU 加速支持)、vLLM / TensorRT-LLM(高性能大模型推理加速引擎)。
# AI算法典型代码片段:PyTorch 基础模型架构与张量计算
import torch
import torch.nn as nn

class ClassifierHead(nn.Module):
    def __init__(self, in_features: int, num_classes: int):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(in_features, 256),
            nn.ReLU(),
            nn.Dropout(0.2),
            nn.Linear(256, num_classes)
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.net(x)
三、真实业务场景下的任务协作流
为了直观展现三个方向在企业实战中的分工与衔接,我们以电商平台的“高价值用户流失预警与智能挽留”这一典型业务需求为例。三个岗位在同一个需求下的介入时机与执行链路完全不同:
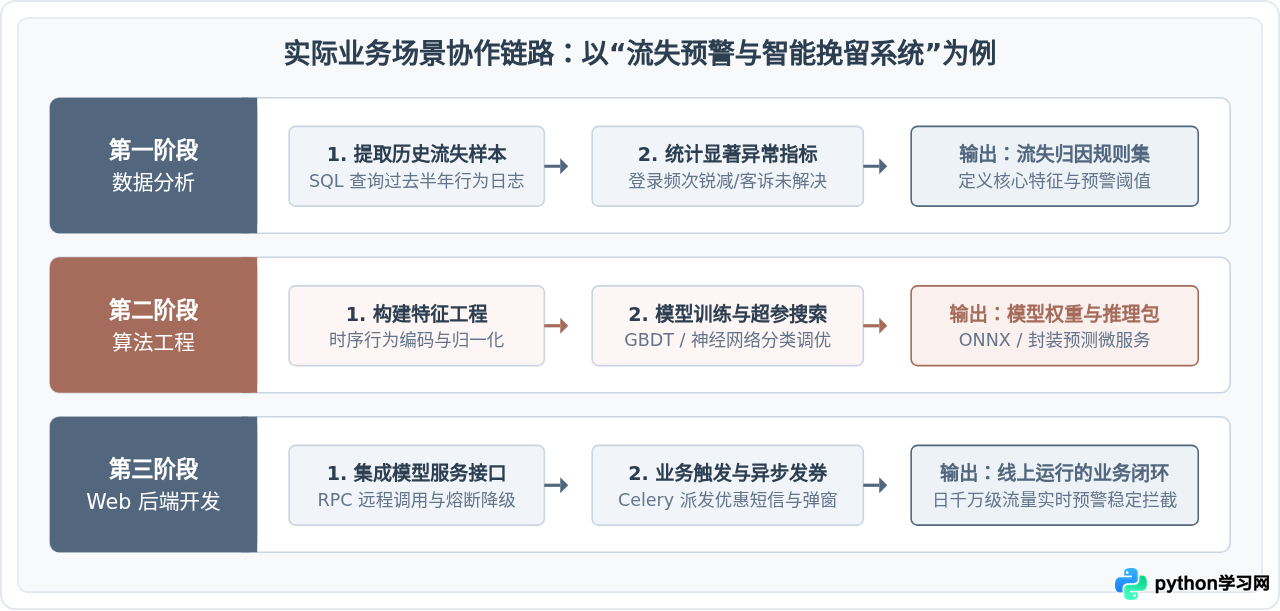
从上述执行链路可以看出:
- 数据分析师负责“看清现状与发现问题”。他们敏锐地察觉哪些行为指标与流失强相关,并给出了基础策略定义。
- AI 工程师负责“从规律中提炼预测能力”。他们把离散的业务指标转化为高精度的二分类预测模型,确保误报率和漏报率处于可接受范围。
- Web 后端工程师负责“将能力落地为高可用工程产品”。模型再准确,如果调用超时导致用户端页面卡顿崩溃也是失败的;Web 工程师通过异步解耦、缓存与容器部署,确保这套智能流程对前台业务丝滑无感。
四、能力门槛与学习路线对比
很多学习者陷入困惑,是因为低估或高估了不同方向的进入门槛。三个方向的学习坡度有着非常鲜明的分层。
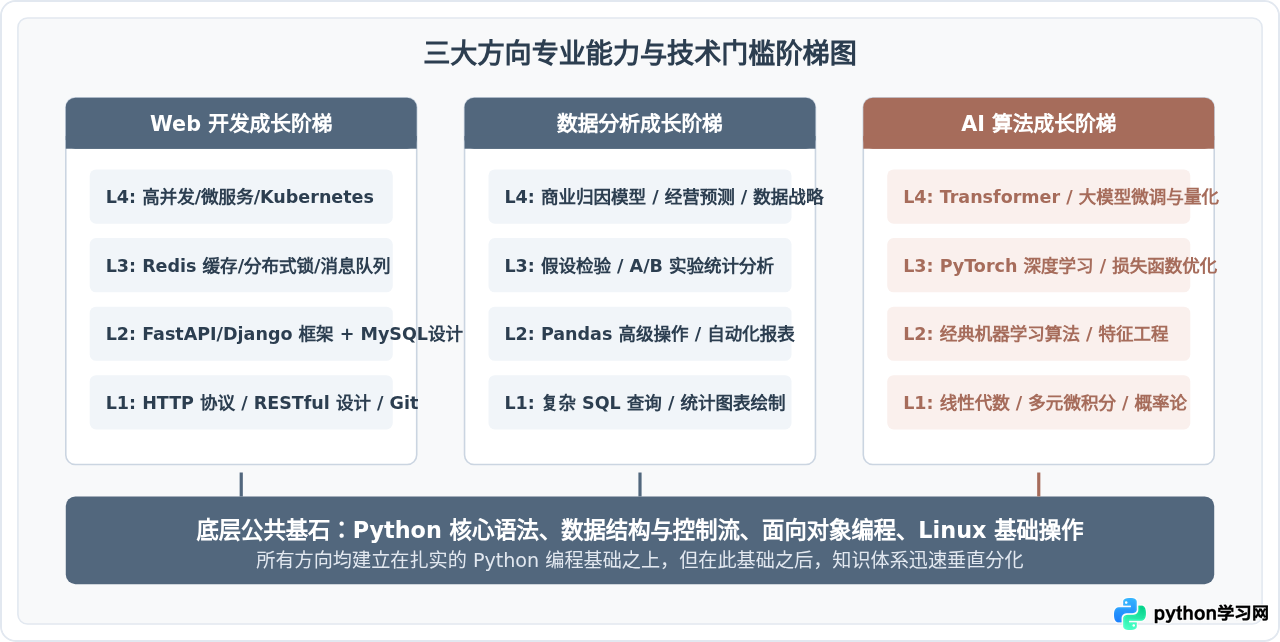
| 对比维度 | Web 后端开发 | 数据分析 | 人工智能 (AI / 算法) |
|---|---|---|---|
| 数学理论要求 | 较低。主要是初等代数与基础逻辑运算,核心考察系统抽象能力。 | 中等。侧重概率论、数理统计(均值/方差/假设检验)、抽样推断。 | 极高。线性代数(特征分解)、多元微积分(梯度推导)、凸优化。 |
| 工程与系统要求 | 极高。Linux 运维、网络协议(TCP/HTTP)、并发设计、Docker 部署。 | 较低。多运行在本地 Jupyter 或云端报表平台,较少直接面对生产流量。 | 中等到高。除了算法调优,也需具备模型量化与高并发推理部署工程能力。 |
| 常见学历门槛 | 以实战项目与工程能力为重,普通本科通常具备充分机会。 | 对专业背景包容度大(理工科、商科、经管类皆有),看重业务逻辑。 | 学术要求严苛。主流算法岗位普遍倾向统招硕士及以上,需论文或竞赛支撑。 |
| 反馈周期 | 极快。接口写错马上报错,功能调通立刻可以在前台看到效果。 | 较快。SQL 运行出结果,图表实时渲染,直接与业务反馈挂钩。 | 较慢。模型训练动辄数小时甚至数天,存在大量无效调参实验。 |
五、如何根据自身背景做出清晰抉择
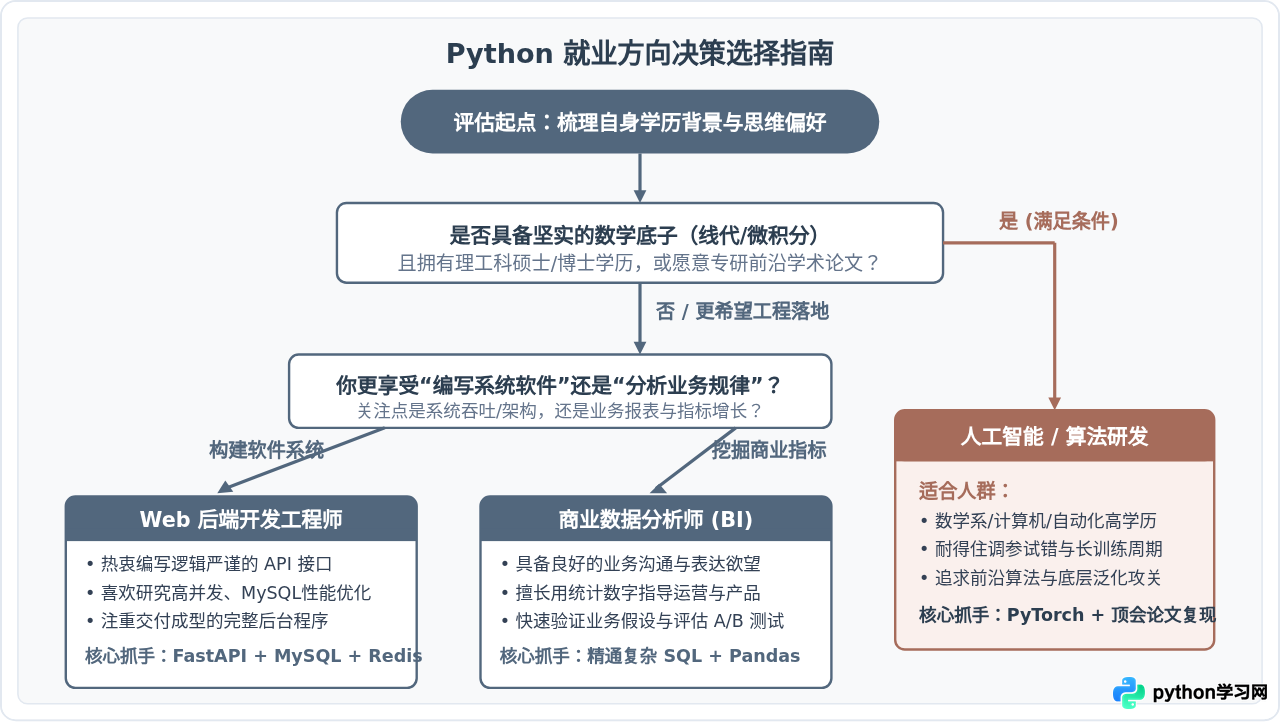
很多转行或初学读者最常犯的错误,就是脱离自身背景去盲目追逐所谓“热门赛道”。以下提供一套明确的判断路径,帮助你排除干扰选项:
六、初学者的务实建议与避坑提醒
明确了三个方向的界限之后,在日常学习与简历准备中,还应注意以下三个关键陷阱:
避坑一:不要把“调库调用 API”误当成掌握了人工智能
许多初学者在脚本里调用了某些大模型的公开 HTTP 接口,或者使用 model.fit() 跑通了波士顿房价预测,就认为自己已经达到了 AI 算法工程师的求职标准。在企业级招聘中,算法工程师的核心考核点在于对反向传播数学机理的理解、损失函数设计、注意力机制的计算开销优化以及特征工程的深入构造。如果缺乏数学与理论推导功底,单纯的 API 调用更接近于 Web 业务开发中的“第三方服务集成”,而非算法岗位。
避坑二:数据分析的核心不是“画炫酷的图”,而是“解决具体业务问题”
学习数据分析时,不要把时间过分耗费在配置各类罕见的复杂图表视觉样式上。企业对分析师的考核,首要是 SQL 提取的准确性与效率,其次是对留存率、转化漏斗、LTV(生命周期总价值)等业务指标的敏锐度。脱离了实际业务场景的代码只是数字游戏,只有能明确回答“这个月用户流失的具体主因是什么、下一步该调整哪个功能”的分析,才具备就业竞争力。
避坑三:Web 开发切忌停留在简单单表 CRUD,必须重视并发与基础设施
如果你的作品集里只有简单的“图书管理系统”或基于 Django 的纯静态页面博客,在当下就业市场中将很难脱颖而出。现代 Python Web 岗位极其看重工程细节:是否掌握 Pydantic 的严谨数据验证、是否理解异步非阻塞编程(async/await)对 I/O 密集型接口的吞吐提升、能否排查 MySQL 慢查询并合理建立联合索引、是否熟练运用 Redis 进行缓存穿透与雪崩的防护。这些系统工程能力才是拉开差距的核心关键。
综上所述,Python 本身只是通用工具,它赋予了开发者快速试验与表达思想的巨大优势。真正的职业价值取决于你用它承载的专业领域知识:是构建健壮可靠的 Web 工程体系,是用严谨的数据洞察驱动商业飞轮,还是用坚实的数学与算法撬动前沿智能。在起步阶段选定一个与自身底色最为匹配的方向深度深耕,远比在三个领域表面涉猎更有实效。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















