


Python标准库array模块使用指南:怎么创建节省内存的类型化数组
深入讲解Python标准库array模块的使用方法与底层原理。全面剖析类型码选择、紧凑物理内存结构、与list的内存消耗对比实测、二进制快速I/O及技术选型策略,帮助读者在无需额外第三方库的情况下显著降低纯数值序列的内存占用。
list 会因为对象包装和指针引用带来高达数倍的额外内存开销。Python 标准库自带的 array 模块通过底层连续的 C 语言原生缓冲区直接存储纯数据,在无需引入第三方科学计算库(如 NumPy)的前提下,能够将纯数值的内存占用直接缩减 80% 到 90%。本文将详细讲解 array 模块的底层运行机制、类型码(Typecode)的选择依据、基础与高阶操作技巧,以及它与 list 和 numpy.ndarray 的适用边界。
一、为什么 list 如此占内存:底层存储原理剖析
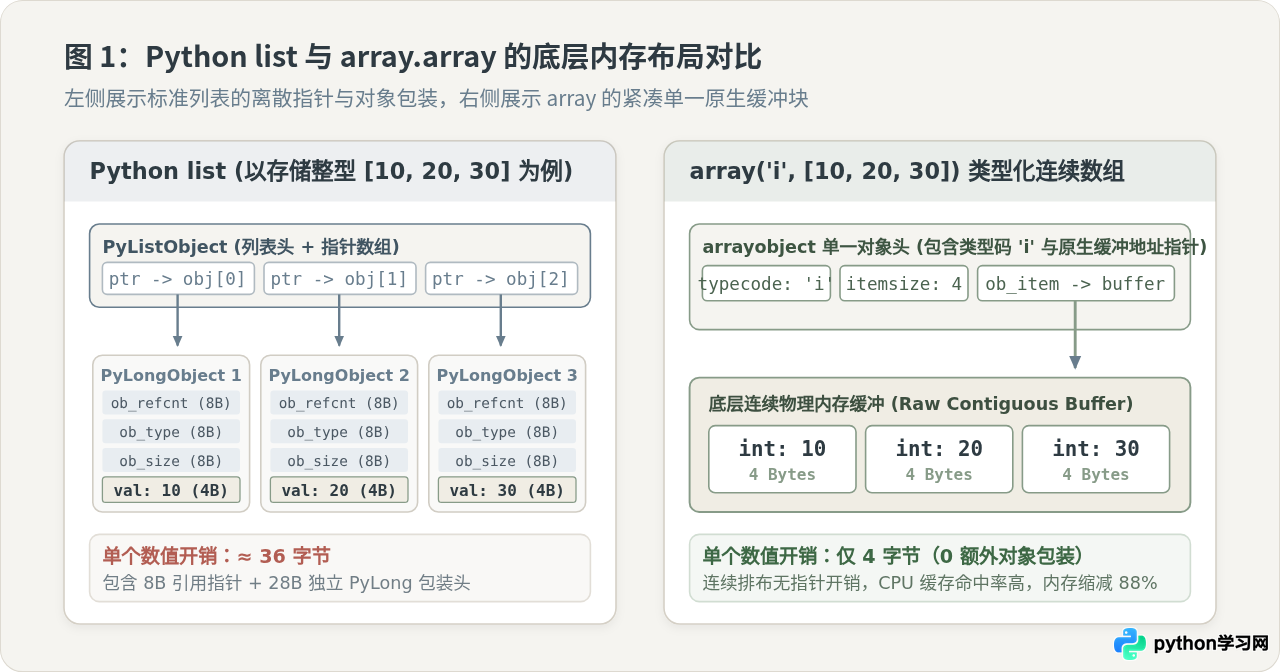
很多初学者容易将 Python 的 list 当作类似 C 语言中的数组,但两者的内部组织方式有着本质区别。在 CPython 解释器中,list 本质上是一个动态长度的指针数组(PyObject**)。无论向列表中存放一个多小的整数或浮点数,列表本身只记录指向该对象的 64 位(8字节)指针,而真正的数字则以独立的 PyObject(具体为 PyLongObject 或 PyFloatObject)分配在堆内存的其他区域。
一个标准的 64 位 Python 整数对象哪怕只代表数字 10,其内部也必须包含:
ob_refcnt:8 字节引用计数;ob_type:8 字节类型指针(指向int类型对象);ob_size:8 字节表示位宽元信息的长整型;ob_digit:至少 4 字节的数字物理存储单元。
list 指针槽位所消耗的 8 字节指针,每存储一个数字至少需要 36 字节的内存!如果有 1,000 万个整数,仅承载这批数字就需要耗费 360 MB 以上的物理内存,并在内存中制造上千万个离散碎片对象,极大地加重了垃圾回收器的标记追踪负担。
而 Python 标准库中的 array.array 彻底改变了这种布局。它直接在内存中申请一块单一、连续的扁平物理内存块,直接将 C 语言原生的 int、short 或 double 二进制字节顺序填入该缓冲区。整个数组只有一个轻量的 Python 外壳对象头,各个元素之间没有任何指针引用,也没有任何独立的 PyObject 包装。一个 32 位整型只消耗其物理应占的 4 字节,空间浪费几乎降为零。
二、类型码(Typecode)速查与正确选择
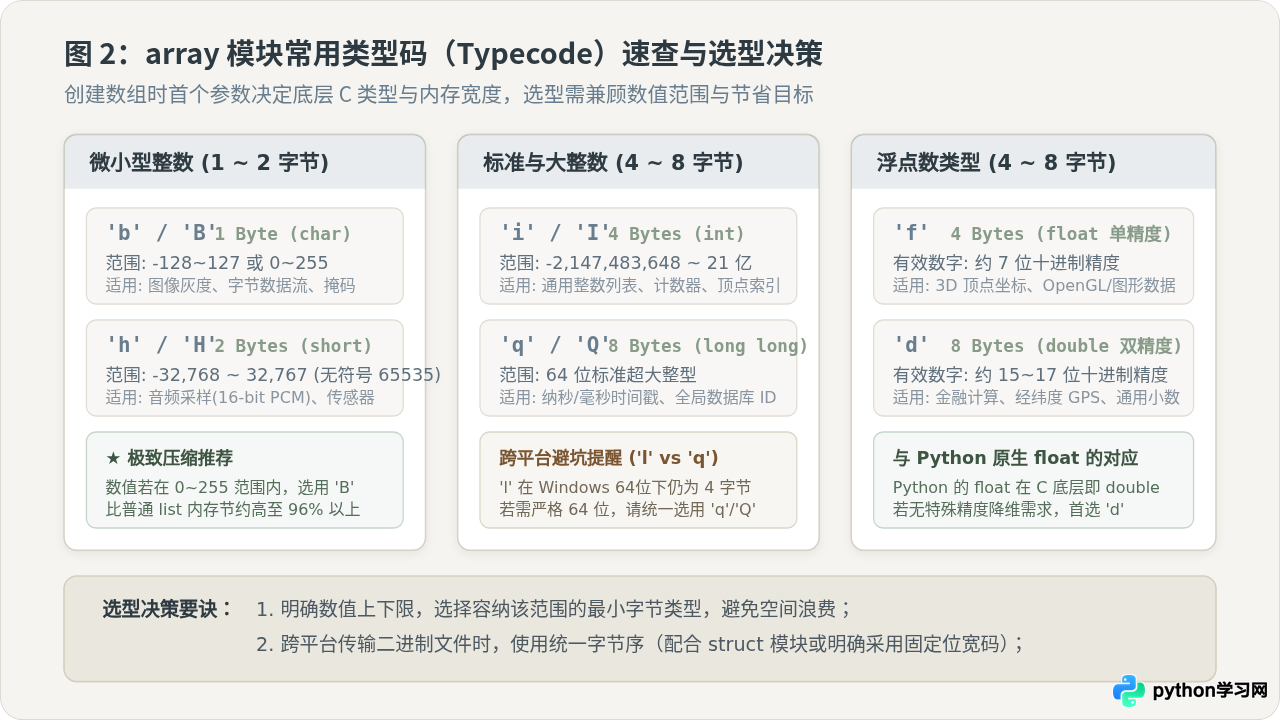
创建 array 实例时,第一个必选参数是类型码(Typecode)。它是一个由单个英文字符构成的标识符,明确指示底层以何种 C 语言原生数据类型和字节宽度来解读与分配内存。数组一经定义,其内部所有元素都必须严格遵从该类型的范围与约束。
| 类型码 | 对应 C 语言类型 | 最小字节数 | 典型取值范围 | 典型应用场景 |
|---|---|---|---|---|
'b' |
signed char | 1 | -128 ~ 127 | 有符号微小读数、8-bit 音频差值 |
'B' |
unsigned char | 1 | 0 ~ 255 | 灰度图像像素、字节流缓冲、状态掩码 |
'h' |
signed short | 2 | -32,768 ~ 32,767 | 16 位标准音频 PCM 样本、传感器测量值 |
'H' |
unsigned short | 2 | 0 ~ 65,535 | 16 位无符号数、端口号、网络分片计数 |
'i' |
signed int | 2 (通常为 4) | -2,147,483,648 ~ 2,147,483,647 | 通用 32 位整型序列、图形顶点索引 |
'I' |
unsigned int | 2 (通常为 4) | 0 ~ 4,294,967,295 | 32 位正整数计数器、内存物理偏移 |
'q' |
signed long long | 8 | -9.22×10¹⁸ ~ 9.22×10¹⁸ | 纳秒级时间戳、全局数据库 ID |
'Q' |
unsigned long long | 8 | 0 ~ 1.84×10¹⁹ | 64 位超大无符号整数 |
'f' |
float | 4 | 约 7 位有效十进制精度 | 3D 向量空间坐标、低精度连续采样 |
'd' |
double | 8 | 约 15~17 位有效十进制精度 | 高精度科学数值、经纬度 GPS、通用小数 |
long 宽度依赖操作系统规范:在 64 位 Linux 和 macOS 上 long 为 8 字节;但在 64 位 Windows 上(LLP64 数据模型)long 依然只有 4 字节。如果您需要严格的 64 位整数,强烈建议使用 'q' 或 'Q',以确保代码跨平台迁移与文件反序列化时字节宽度绝对一致。
三、核心操作指南:从创建到二进制极速持久化
array 在操作语法上极大程度地沿袭了 Python 列表的习惯,支持索引、切片、迭代以及 append()、extend() 等通用方法;同时它还赋予了对底层缓冲区原生的二进制吞吐能力。
1. 初始化与属性检查
可以通过传入一个可迭代对象(如 list、tuple 或生成器)来初始化数组,也可以先构造一个空数组后续动态追加:
import array

# 1. 从已有序列创建 32 位有符号整型数组
int_arr = array.array('i', [10, 20, 30, 40])

# 2. 检查单个元素占用的字节数 (bytes)
print("每个元素宽度:", int_arr.itemsize)  # 输出: 4

# 3. 检查底层缓冲区的首地址与元素总数 (address, length)
print("物理缓冲信息:", int_arr.buffer_info())  # 示例输出: (4389178240, 4)

# 4. 类型严格性校验:放入浮点数或越界数据会抛出 TypeError 或 OverflowError
try:
    int_arr.append(3.14159)  # 试图向整型数组插入浮点数
except TypeError as e:
    print("类型拦截生效:", e)  # 输出: 'float' object cannot be interpreted as an integer
2. 动态维护与切片
向数组追加数据时,array 会在底层平滑扩容;但扩展数组时,追加的数据必须与原有类型码完全一致:
# 原地追加单个元素
int_arr.append(50)

# 批量追加另一个兼容的可迭代对象
int_arr.extend([60, 70, 80])

# 支持标准切片操作(切片返回的依然是相同类型的 array)
sub_arr = int_arr[2:5]
print(sub_arr)  # 输出: array('i', [30, 40, 50])
3. 二进制文件极速读写与流转(tofile / fromfile)
在日常开发中,将几百万个数值存盘或读取通常使用 json、csv 或 pickle。然而,文本格式不仅文件体积巨大,而且在序列化与反序列化时需要消耗大量 CPU 逐个做字符串格式化与数值解析。
array 提供了 tofile() 与 fromfile(),它们直接将底层的原生 C 字节块灌入文件描述符或从磁盘原样拷入内存,速度相比解析文本文件可提升 5 到 10 倍以上:
# 极速将 100 万个浮点数以二进制直接写入磁盘
float_data = array.array('d', (0.001 * i for i in range(1_000_000)))

with open("sensor_samples.bin", "wb") as f:
    float_data.tofile(f)  # 零格式化开销,直接 dump 原生 8 字节浮点数据流

# 从磁盘中零解析开销直接还原数据
restored_data = array.array('d')
with open("sensor_samples.bin", "rb") as f:
    # 告知需要读入的元素数量
    restored_data.fromfile(f, 1_000_000)

print("读取恢复成功,前 3 个元素:", restored_data[:3])
4. 与网络字节流与 memoryview 的无缝配合
array 原生支持 Python 的 缓冲区协议(Buffer Protocol)。你可以通过 tobytes() 和 frombytes() 与 bytes 互转,或者使用 memoryview 进行零拷贝切片与网络发送:
# 转换为原生 bytes 字节串,常用于 Socket 发送或硬件串口交互
raw_bytes = int_arr.tobytes()
print("总字节长度:", len(raw_bytes))  # 元素个数 * 4

# 零拷贝切片操作 (通过 memoryview 映射物理内存)
mv = memoryview(int_arr)
print("memoryview 项大小:", mv.itemsize)  # 4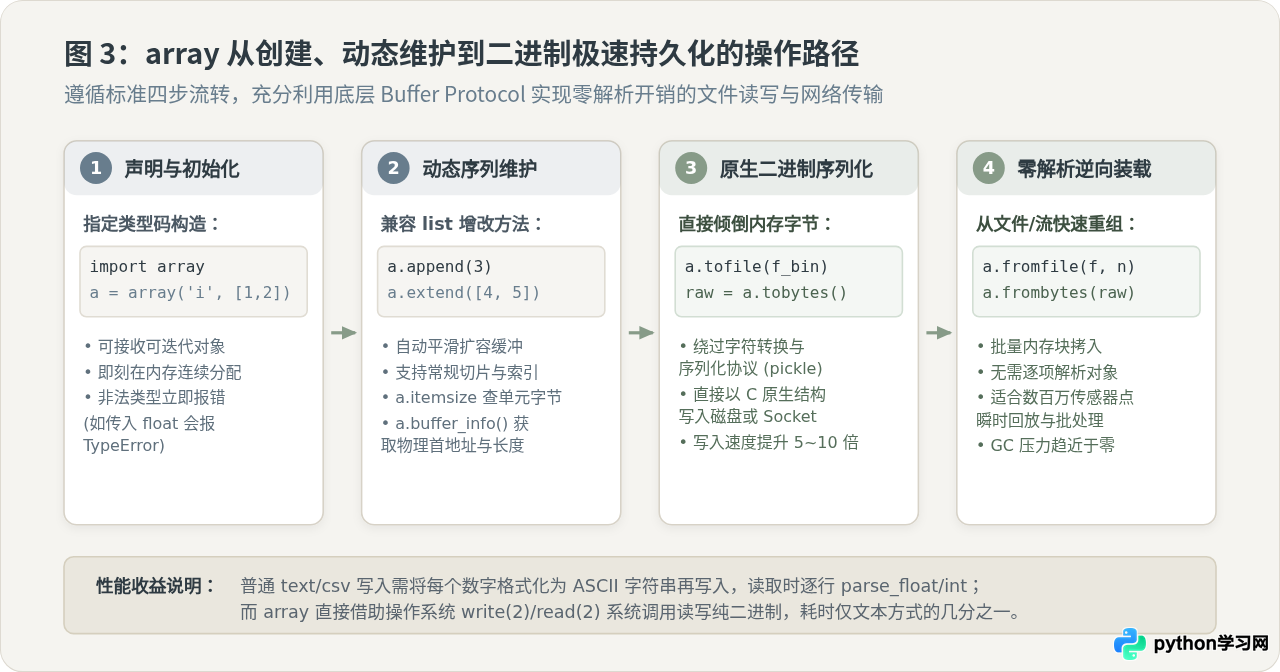
四、数据实测:在一致条件下对比 list 与 array 的内存开销
为了直观说明两者在内存利用上的关键差异,我们在相同的 64 位 Python 运行环境中,分别存储 10,000,000 个(一千万个)32 位整数,并测量其物理内存驻留与对象开销。
| 测试指标 | 标准列表 list |
紧凑数组 array('i') |
对比与差异影响 |
|---|---|---|---|
| 底层存储形式 | 指针数组 + 独立 PyLongObject | 连续单片 C 语言 int 缓冲 |
array 消除了所有外层对象包装头 |
| 单个元素内存开销 | 约 36 字节 (8B指针 + 28B对象) | 精确 4 字节 | 单元素内存直接压缩 88.8% |
| 一千万元素总内存 | 约 360 ~ 400 MB | 约 38.1 MB (40,000,000 字节) | 节省超过 320 MB 内存! |
| 生成独立对象数量 | 10,000,001 个对象 | 仅 1 个 array 对象 | GC 标记压力彻底归零,杜绝内存碎片 |
| 持久化到二进制文件大小 | 若用 pickle 约 80MB+,若用 json 约 78MB | 仅 38.1 MB (纯二进制数据) | 磁盘与网络 IO 负载降低 50% 以上 |
差异为什么重要?对于并发处理数以百计的数据流或在云原生容器环境中运行的微服务而言,320 MB 的差异往往决定了服务是否会触发操作系统的 OOM (Out Of Memory) Killer。尤其在批量处理日志序号、网络数据包或海量点云坐标时,array 能够让原本因为内存不足而必须引入分布式或磁盘落盘的任务,直接在单机内存中高效跑完。
array 内存非常紧凑,但在纯 Python 代码中通过 for x in arr: 遍历元素时,Python 解释器在取值瞬间依然会把底层的 4 字节 C 整数临时装箱为 int 对象返回给循环体。因此,array 主要解决的是内存存储瓶颈与二进制 IO 传输瓶颈,而非纯 Python 循环内部的数值运算提速。
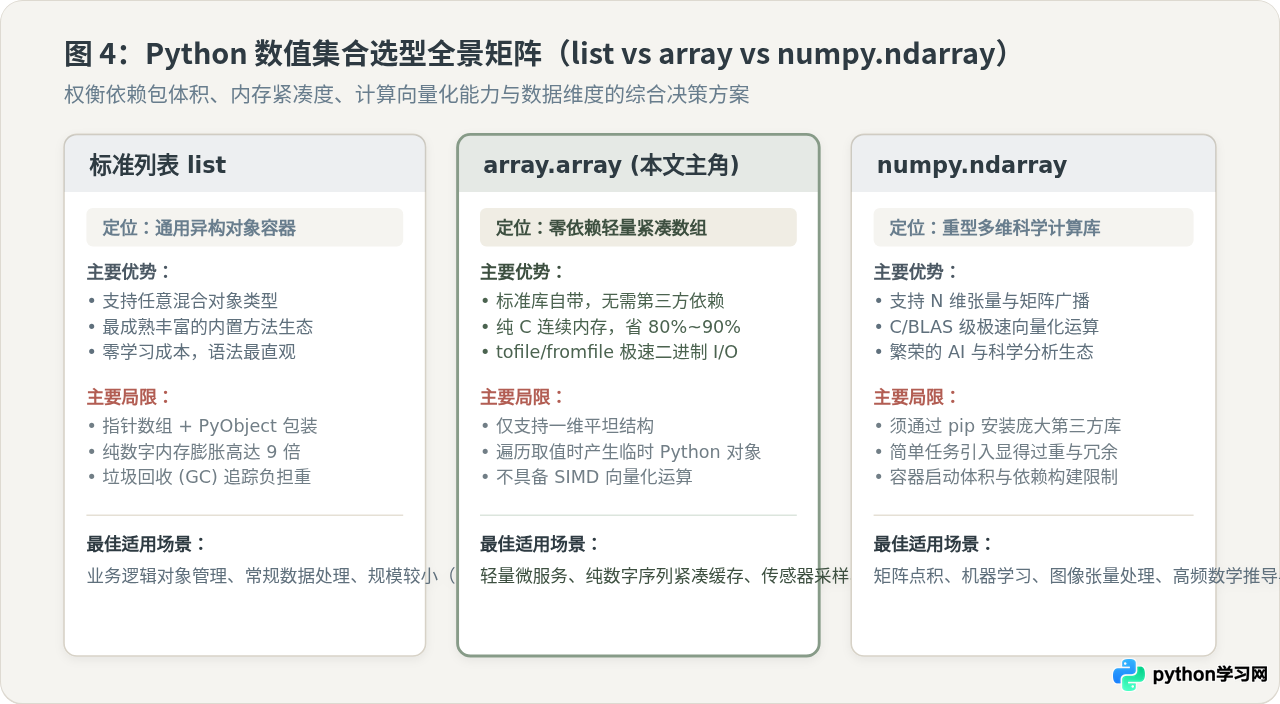
五、选型全景:什么时候用 list、array 或 numpy.ndarray?
理解一个工具的适用边界,往往比单纯掌握其 API 更加关键。Python 生态中存在三种常见的序列方案,它们各司其职:
- 内置
list:
核心定位:通用异构对象容器。
适用场景:数据量相对适中(几万项以内)、需要存放不同类型的字典、字符串或自定义类实例,或者代码逻辑极其频繁地对元素进行异质修改与复杂嵌套。 - 标准库
array.array:
核心定位:标准库自带的轻量级零依赖类型化紧凑一维数组。
适用场景:数据为纯单一类型数值(纯整数、纯浮点数)、规模从数万到数千万项;处于标准库限制环境(例如打包体积严格受限的 AWS Lambda / 嵌入式设备 / 无网络安装第三方 wheel 的受限生产容器);需要频繁进行二进制文件存储与网络原始数据包拆装。 - 第三方
numpy.ndarray:
核心定位:重型科学计算与高维矩阵引擎。
适用场景:需要进行二维或多维矩阵运算、线性代数、傅里叶变换、向量化广播数学计算(如整个数组每个元素乘以 1.5 且需要 C 级别的 SIMD 并行加速)。如果业务只是一维存取与轻量流转,NumPy 的安装体积与启动负担则显得过于庞大。
六、总结与实践建议
Python 标准库的 array 模块是一座常被忽视的宝藏工具。回顾其核心价值与操作路径:
- 内存瘦身显著:对于同构数值序列,通过剔除
PyObject头与指针数组,实现高达 80%~90% 的物理内存缩减; - 按需选定类型码:利用
'b'/'B'处理字节图像,'h'/'H'处理音频与传感器采样,'i'/'I'处理常规整型,'q'/'Q'锁定跨平台 64 位大整数,'d'处理高精度浮点; - 善用原生二进制 I/O:利用
tofile()、fromfile()、tobytes()绕过文本格式化解析与复杂序列化开销,极大提升数据落盘与恢复速率; - 明确技术权衡:在无需多维运算与向量化数学库的轻量级场景下,优先用
array替代list,在保持零外部依赖的同时为系统换取极佳的资源利用率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















