


Python Scrapy框架实战:构建高并发异步爬虫
深入解析Scrapy单进程事件驱动机制,从Twisted/Asyncio底层架构、非阻塞中间件编写,到高并发参数调优与生产级避坑指南,全面构建高吞吐量异步爬虫系统。
一、Scrapy 异步事件驱动架构与并发机制
许多初次接触高并发爬虫的开发者常误以为 Scrapy 依靠多线程实现高并发。事实上,Python 原生多线程受全局解释器锁(GIL)限制,在密集的 I/O 切换中会带来昂贵的线程上下文切换开销。Scrapy 从设计之初就基于事件驱动架构(默认使用 Twisted 框架,新版本深度整合原生 asyncio),在单主线程内运行非阻塞事件循环(Event Loop / Reactor)。
在 Reactor 模型中,当一个 HTTP 请求通过网络连接发出后,底层套接字(Socket)便注册到操作系统多路复用机制(如 Linux epoll 或 macOS kqueue)。主线程无需挂起等待远程服务器返回数据,而是立即处理事件循环队列中的下一个就绪事件——例如调度下一个请求、解析已到达的页面、或将清洗完毕的数据推入写入缓冲。只有当某个套接字的数据流真正到达内核缓冲区时,Reactor 才会调用对应请求的回调函数(Callback)。这种非阻塞流转使得单个进程在等待海量网络 I/O 时能够维持极高的吞吐率。
1.1 六大核心组件的异步协作流转
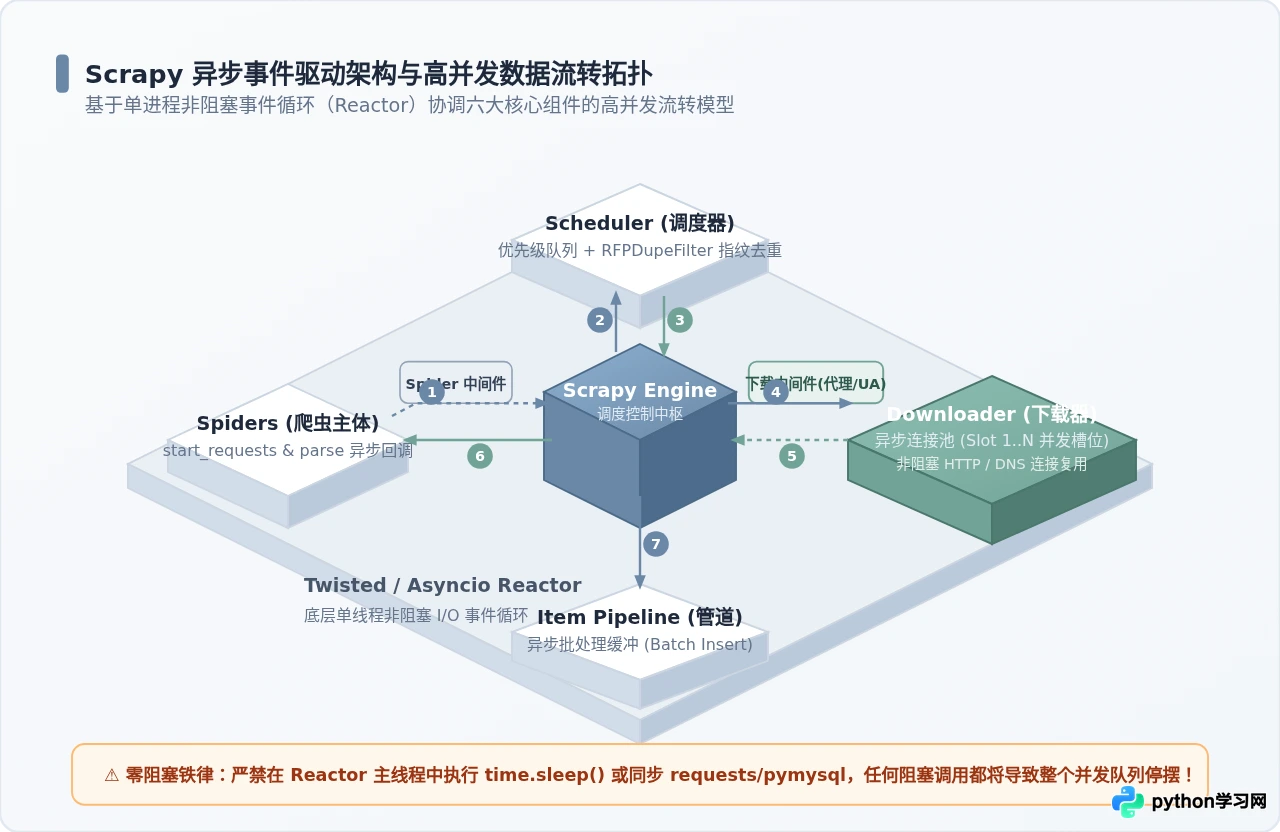
理解 Scrapy 高并发的关键,在于看清以下六大组件如何在引擎中进行闭环流转:
- Scrapy Engine(引擎):爬虫系统的心脏,负责控制所有组件之间的数据信号流转,并在发生特定操作时触发事件。
- Scheduler(调度器):接收来自引擎的请求并压入优先级队列。调度器内部集成了基于哈希指纹的去重过滤器(
RFPDupeFilter),在入队前拦截重复 URL,防止高并发下因环路爬取导致的资源浪费。 - Downloader(下载器):高并发吞吐量的实际承载者。下载器维护着一个异步 HTTP 连接池(Connection Pool Slots),利用非阻塞 I/O 同时与目标主机建立几十甚至数百个长连接。
- Spiders(爬虫主体):用户编写解析逻辑的地方。负责处理下载器返回的
Response,提取结构化数据Item,或者产出后续深度跟进的Request。 - Downloader Middlewares(下载中间件):位于引擎与下载器之间的钩子层,用于在高并发场景下动态附加代理 IP、随机轮换 User-Agent、或根据目标响应状态码(如 429 Too Many Requests)执行退避策略。
- Item Pipeline(数据管道):结构化数据的出口,负责清洗、验证及持久化入库。
因为 Scrapy 运行在单个事件循环主线程上,如果在 Spider 解析方法、下载中间件或 Pipeline 中调用了任何同步阻塞代码(例如
time.sleep()、传统的 requests.get()、或者同步的 pymysql.connect().cursor().execute()),会导致整个 Reactor 事件循环瞬间停滞。在这段阻塞期间,所有正在网络连接池中并发传输的几十上百个请求将全部被冻结,造成系统吞吐量断崖式暴跌。
二、五步构建高并发异步爬虫实战
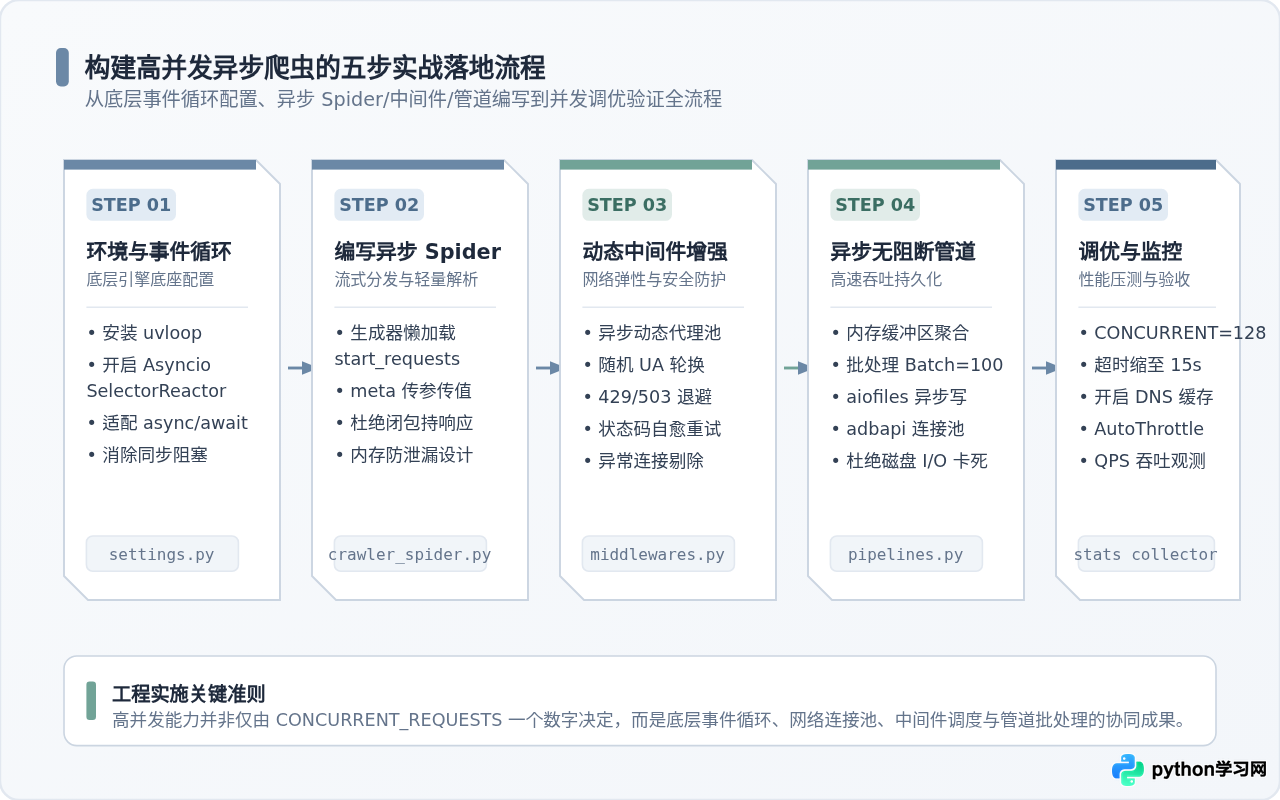
为了让高并发理念落到工程代码中,接下来按照生产项目的实际搭建顺序,从底层事件循环配置、Spider 异步请求编写、中间件防御加固,到非阻塞管道批处理持久化,完成一套完整的异步爬虫。
步骤 1:环境初始化与启用现代 Asyncio Reactor
在较新的 Scrapy 版本中,官方推荐使用基于 Python 标准库 asyncio 的反应器替代传统的 Twisted SelectReactor。这不仅能让我们在爬虫中直接使用 async/await 语法,还能借助 uvloop 将底层事件循环吞吐量提升 2 至 4 倍。
# 终端安装核心依赖(虚拟环境中执行)
pip install scrapy uvloop aiofiles motor

# 在 settings.py 中指定使用 AsyncioSelectorReactor 并集成 uvloop
import sys
import asyncio

# 启用基于 asyncio 的 Twisted Reactor
TWISTED_REACTOR = 'twisted.internet.asyncioreactor.AsyncioSelectorReactor'

# 在 Linux / macOS 环境下配置 uvloop 加速
if sys.platform != 'win32':
    import uvloop
    asyncio.set_event_loop_policy(uvloop.EventLoopPolicy())
步骤 2:编写高效的 Spider 异步生成器
在大规模采集任务中,千万不要将数万条目标 URL 一次性装载到一个 Python 列表中。这不仅会导致内存飙升,还会使爬虫启动时陷入长时间的列表初始化阻塞。正确的做法是使用 Python 生成器(Generator)进行流式按需分发。
# news_spider.py
import scrapy
from typing import Iterable

class HighConcurrencySpider(scrapy.Spider):
    name = 'high_concurrency_news'
    allowed_domains = ['example.org']

    def start_requests(self) -> Iterable[scrapy.Request]:
        """
        使用生成器流式下发初始请求,将内存占用严格控制在 O(1)
        """
        total_pages = 5000
        base_url = 'https://example.org/api/articles?page={}'
        for page_index in range(1, total_pages + 1):
            yield scrapy.Request(
                url=base_url.format(page_index),
                callback=self.parse_index,
                meta={'page': page_index},
                dont_filter=False
            )

    def parse_index(self, response):
        # 解析分页索引数据
        article_items = response.json().get('data', [])
        for item in article_items:
            detail_url = f"https://example.org/articles/{item['id']}"
            # 仅传递必要字段,绝不把整个大型字典塞入 meta
            yield response.follow(
                url=detail_url,
                callback=self.parse_detail,
                meta={'article_id': item['id']},
                priority=10  # 详情页设置更高优先级,快速消耗队列
            )

    def parse_detail(self, response):
        # 提取正文内容并产出 Item
        title = response.css('h1.title::text').get(default='').strip()
        body = response.css('div.article-content::text').getall()
        yield {
            'id': response.meta['article_id'],
            'title': title,
            'content': ''.join(body).strip(),
            'url': response.url
        }
步骤 3:编写动态代理与重试下载中间件
在高并发场景下,单 IP 发包频率极易触发目标站点的 WAF 防火墙(返回 429 Too Many Requests 或 403 Forbidden)。我们需要在中间件中实现动态代理轮换,并针对瞬时连接错误进行指数退避重试。
# middlewares.py
import random
import logging
from scrapy.exceptions import IgnoreRequest

logger = logging.getLogger(__name__)

class AsyncProxyAndHeaderMiddleware:
    def __init__(self):
        # 生产环境中推荐从本地 Redis 内存或外部代理探活服务获取可用列表
        self.proxy_pool = [
            'http://proxy-cluster-1.internal:8080',
            'http://proxy-cluster-2.internal:8080',
            'http://proxy-cluster-3.internal:8080',
        ]
        self.user_agents = [
            'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36',
            'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36',
            'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36'
        ]

    def process_request(self, request, spider):
        # 动态注入随机 Header 与代理地址
        request.headers['User-Agent'] = random.choice(self.user_agents)
        if self.proxy_pool:
            request.meta['proxy'] = random.choice(self.proxy_pool)

    def process_response(self, request, response, spider):
        # 拦截限流状态码,进行退避处理
        if response.status in (429, 503):
            logger.warning(f"检测到频率限制 {response.status},重新安排请求: {request.url}")
            retry_req = request.copy()
            retry_req.dont_filter = True
            retry_req.priority = request.priority - 1
            return retry_req
        return response
步骤 4:构建异步无阻断管道(Batch Buffer Pipeline)
如果在 Item Pipeline 中每收到一条数据就同步执行一次 INSERT INTO,数据库的磁盘 I/O 延迟(通常在 1~10ms)将成为系统最严重的瓶颈。正确的做法是在内存中开辟缓冲队列,每积累满指定批次(例如 100 条)或定时触发一次异步批量入库。
# pipelines.py
import json
import aiofiles
import logging

logger = logging.getLogger(__name__)

class AsyncBatchFilePipeline:
    def __init__(self, batch_size=100):
        self.batch_size = batch_size
        self.buffer = []
        self.file_handle = None

    async def open_spider(self, spider):
        # 基于 aiofiles 异步打开输出文件,杜绝同步打开文件句柄造成的 I/O 阻塞
        self.file_handle = await aiofiles.open('output_articles.jsonl', mode='a', encoding='utf-8')

    async def process_item(self, item, spider):
        self.buffer.append(json.dumps(dict(item), ensure_ascii=False) + '
')
        if len(self.buffer) >= self.batch_size:
            await self.flush_buffer()
        return item

    async def flush_buffer(self):
        if self.buffer and self.file_handle:
            content = ''.join(self.buffer)
            self.buffer.clear()
            await self.file_handle.write(content)
            await self.file_handle.flush()

    async def close_spider(self, spider):
        await self.flush_buffer()
        if self.file_handle:
            await self.file_handle.close()
三、并发核心参数与网络连接池深度调优
Scrapy 的性能并非单纯由某一个开关控制,而是由一组相互掣肘的网络与调度参数共同决定。如果盲目将并发数字调到极大,而未缩短连接超时或未扩充 DNS 解析线程池,爬虫很可能在数分钟内因网络连接耗尽而瘫痪。
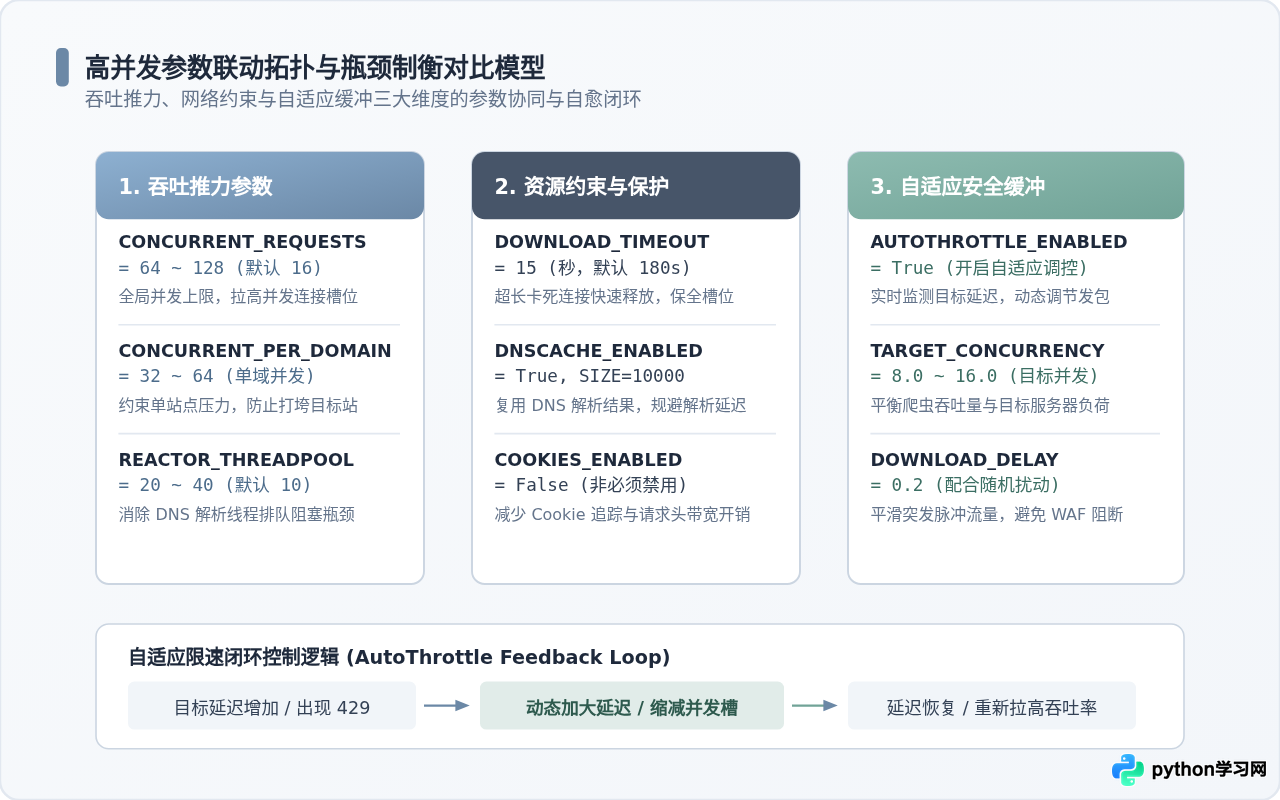
3.1 核心参数联动矩阵
| 配置项名称 | 默认值 | 高并发推荐值 | 调优原因与工程意义 |
|---|---|---|---|
CONCURRENT_REQUESTS |
16 | 64 ~ 128 | 全局并发上限。决定单进程同时在网络连接池中维持的最大请求数。 |
CONCURRENT_REQUESTS_PER_DOMAIN |
8 | 32 ~ 64 | 单域名最大并发数。防止瞬时请求过密打垮目标服务器或触发 WAF 封禁。 |
DOWNLOAD_TIMEOUT |
180 秒 | 15 ~ 25 秒 | 极关键参数!默认 3 分钟超时极易使僵死连接霸占并发 Slot。必须果断缩短,让错误连接迅速重试。 |
DNSCACHE_ENABLED |
True | True | 开启内存 DNS 缓存。在千万级爬取中避免重复向公网发起百万次 DNS 查询。 |
DNSCACHE_SIZE |
1000 | 10000 | 扩充 DNS 缓存条目上限,保证多域名爬取时的缓存命中率。 |
REACTOR_THREADPOOL_MAXSIZE |
10 | 20 ~ 40 | Twisted 底层专用于 DNS 解析和线程调度的线程池。增大可防止 DNS 解析排队造成吞吐断层。 |
COOKIES_ENABLED |
True | False | 无需登录状态的采集应禁用 Cookie 追踪,能显著减轻内存占用与 HTTP Header 带宽开销。 |
3.2 AutoThrottle(自适应限速扩展)的精密控制
在真实互联网环境中,目标网站的处理能力与网络延迟是时刻波动的。如果使用固定的并发速率,在高峰期容易被封 IP,在低峰期又浪费了爬取能力。Scrapy 内置的 AutoThrottle 扩展通过闭环控制算法完美解决了这一问题。
它的工作原理是:监控每一次网络响应的延迟(Latency)。当目标站点响应迅速时,算法自动缩短发送间隔并增加并发连接;当目标站点延迟增加或出现轻微拥塞时,算法自动加大 DOWNLOAD_DELAY 并缩减并发槽位,始终将爬虫的工作状态稳定在目标服务器能够承受的最优区间。
# 在 settings.py 中配置自适应调控
AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 0.5          # 初始下载延迟(秒)
AUTOTHROTTLE_MAX_DELAY = 10.0           # 高延迟情况下的最大容忍延迟
AUTOTHROTTLE_TARGET_CONCURRENCY = 8.0    # 期望平均并发请求数
AUTOTHROTTLE_DEBUG = False              # 生产环境关闭调控调试日志
四、生产级避坑指南与性能监控体系
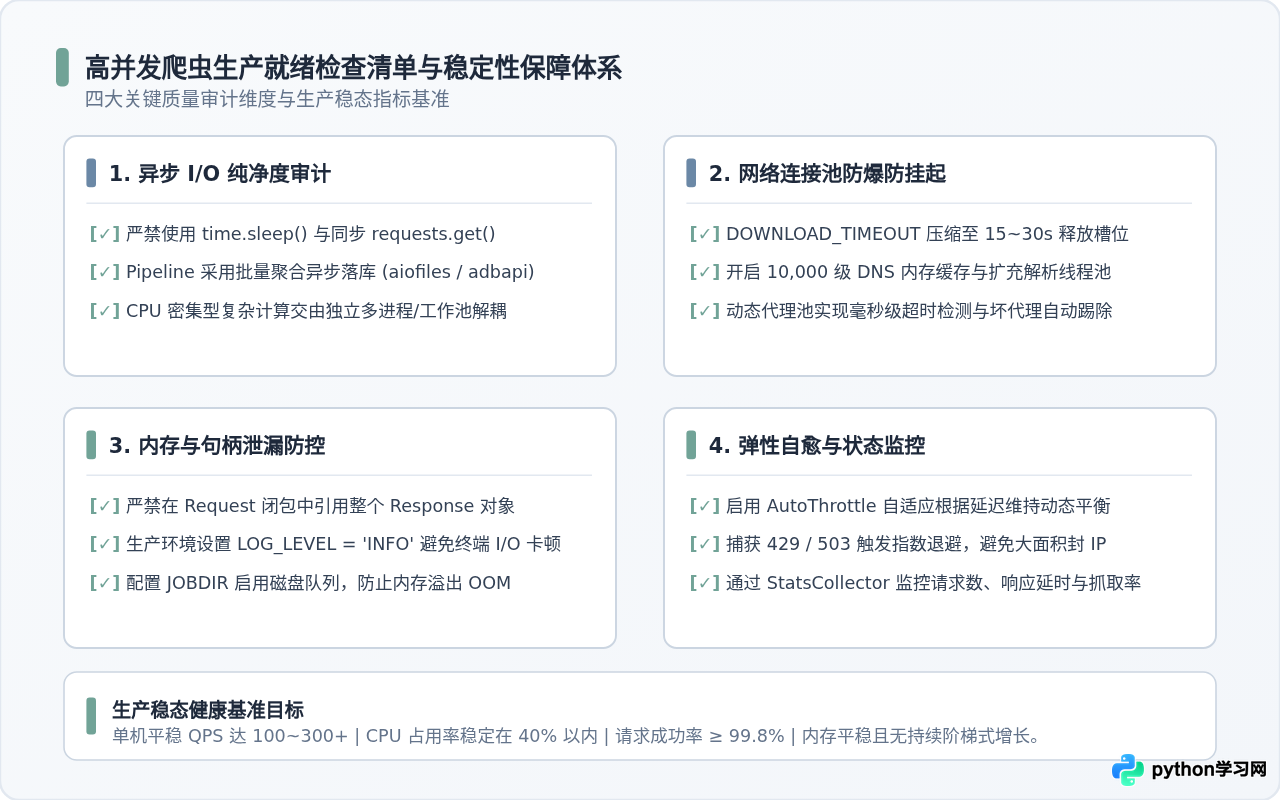
当并发连接数被提升至 100 以上后,原本在低并发测试阶段暴露不出的细微隐患,都会被成倍放大。下面总结三项生产高并发爬虫最常见的致命隐患与应对方案。
4.1 隐患一:闭包与全局引用引发的内存泄漏(OOM)
在高并发爬虫运行数小时后,开发者经常发现内存占用从几百兆直线攀升至数吉甚至被系统 OOM Kill。最常见的罪魁祸首是在生成子请求时,通过闭包或者在 meta 中传递了上一级的整个 Response 对象。
在 Scrapy 中,每个 Response 对象都持有完整的 HTTP Body、Headers 以及绑定的 Selector 解析树。如果在下一个请求的闭包里引用了当前响应,Python 的垃圾回收器就永远无法释放已解析页面的内存。数万个页面累积下来,内存必然耗尽。
meta 中只传递纯标量数据(如数字 ID、短字符串 URL)。需要核查常驻未释放的响应对象时,可在代码中调用 from scrapy.utils.trackref import print_live_refs; print_live_refs(),一旦发现活跃 Response 对象数持续远超并发数(如 Live References: Response: 15420),即可确认为对象泄漏。
4.2 隐患二:海量终端与磁盘日志拖垮主事件循环
当爬虫以每秒 100~300 个页面的速率运转时,如果 LOG_LEVEL 依然保留默认的 DEBUG 级别,控制台每秒将疯狂输出数千行日志。标准输出与磁盘写日志是典型的同步系统调用,频繁的终端滚动会吃满宿主机 CPU,甚至直接将事件循环拖垮。
在生产部署时,务必将日志级别提升至 LOG_LEVEL = 'INFO',同时在 settings.py 中配置 LOG_STDOUT = False,仅保留关键的统计与错误告警。
4.3 隐患三:借助 StatsCollector 监控真实生产指标
怎样确认爬虫确实跑在高并发状态?不要只凭肉眼观察日志滚动,而应通过 Scrapy 的核心统计收集器(crawler.stats)观测底层计数器。运行结束或定时监控时,关注以下核心指标:
downloader/request_count与downloader/response_count:对比两者差值,差值过大说明大量请求堆积在网络队列中未及时返回。downloader/response_status_count/200:正常成功响应的比例,生产环境必须维持在 99.5% 以上。downloader/response_status_count/429:限流触发计数。一旦频繁出现,表明代理池轮换失效或并发设置过高,需立即下调。item_scraped_count:实际入库的数据条数,验证解析逻辑与管道过滤的有效性。
五、生产调优完整 settings.py 模板
最后,将前述所有高并发架构理念、异步 Reactor 驱动、超时限制与自适应限速策略,整合成一份拿来即用的生产级 settings.py 配置文件:
# settings.py - 高并发异步爬虫生产配置模版
BOT_NAME = 'async_crawler'
SPIDER_MODULES = ['async_crawler.spiders']
NEWSPIDER_MODULE = 'async_crawler.spiders'

# 1. 启用异步事件循环驱动与 uvloop
TWISTED_REACTOR = 'twisted.internet.asyncioreactor.AsyncioSelectorReactor'

# 2. 并发吞吐核心参数
CONCURRENT_REQUESTS = 128
CONCURRENT_REQUESTS_PER_DOMAIN = 64
DOWNLOAD_TIMEOUT = 15
COOKIES_ENABLED = False

# 3. DNS 缓存与解析线程池强化
DNSCACHE_ENABLED = True
DNSCACHE_SIZE = 10000
REACTOR_THREADPOOL_MAXSIZE = 30

# 4. 目标友好性与自适应调速
AUTOTHROTTLE_ENABLED = True
AUTOTHROTTLE_START_DELAY = 0.2
AUTOTHROTTLE_MAX_DELAY = 5.0
AUTOTHROTTLE_TARGET_CONCURRENCY = 12.0

# 5. 中间件与异步管道注册
DOWNLOADER_MIDDLEWARES = {
    'async_crawler.middlewares.AsyncProxyAndHeaderMiddleware': 543,
}

ITEM_PIPELINES = {
    'async_crawler.pipelines.AsyncBatchFilePipeline': 300,
}

# 6. 生产日志与断点容灾
LOG_LEVEL = 'INFO'
LOG_FORMAT = '%(asctime)s [%(name)s] %(levelname)s: %(message)s'
# JOBDIR = 'crawler_state_dir'  # 开启磁盘持久化请求队列,支持中断恢复
构建高并发异步爬虫不是盲目堆砌并发参数,而是一场网络 I/O、事件循环纯净度、动态代理调度与后端存储承载力的系统工程。遵循“零阻塞原则”,通过 Asyncio Reactor 与批处理管道消除内耗,再配合 AutoThrottle 自适应维持稳态吞吐,便能在保障系统自身轻盈与目标服务稳定的前提下,实现极致高效的数据采集。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















